Quét web bằng Java năm 2024 - Hướng dẫn chi tiết nhất
Hướng dẫn này tập trung vào việc quét web bằng Java vào năm 2024. Nó cung cấp hướng dẫn chi tiết từng bước. Bắt đầu khám phá ngay bây giờ!
May 10, 2024Tạ Quí Lĩnh
Hướng dẫn cơ bản về quét web
Hướng dẫn này tập trung vào việc quét web bằng Java vào năm 2024. Hướng dẫn này cung cấp hướng dẫn từng bước về cách trích xuất dữ liệu từ các trang web bằng cách sử dụng trang Scrapeme làm ví dụ. Bằng cách sử dụng Java và thư viện jsoup, bạn sẽ học cách quét tĩnh. tài nguyên trang web và truy xuất thông tin cụ thể như tên sản phẩm, hình ảnh, giá cả và chi tiết.
Hướng dẫn này trang bị cho bạn những kỹ năng cần thiết để quét dữ liệu từ các trang web tương tự và làm nền tảng cho các kỹ thuật quét web nâng cao hơn.
Hãy sẵn sàng khai thác sức mạnh của Java để quét web trong kỷ nguyên hiện đại này!
Yêu cầu về môi trường:
Điều quan trọng cần lưu ý là vì chúng tôi sẽ sử dụng Java cho dự án demo trong bài viết này nên hãy đảm bảo rằng bạn có sẵn các điều kiện tiên quyết sau đây trước khi tiếp tục:
Môi trường được đề xuất:
Java: Mọi phiên bản 8+ LTS
Công cụ xây dựng: Bất kỳ phiên bản Gradle hoặc Maven nào tương thích với phiên bản Java cục bộ của bạn
IDE: Bất kỳ tùy chọn nào của bạn, chẳng hạn như Eclipse, IntelliJ IDEA, VS Code
Lưu ý: Quá trình cài đặt cho môi trường bị bỏ qua.
Môi trường trường hợp:
JDK 21
javascriptCopy
# java -version
java version "21.0.2" 2024-01-16 LTS
Java(TM) SE Runtime Environment (build 21.0.2+13-LTS-58)
Java HotSpot(TM) 64-Bit Server VM (build 21.0.2+13-LTS-58, mixed mode, sharing)
Công cụ xây dựng: Gradle
javascriptCopy
# gradle -version
Gradle 8.7

Build time: 2024-03-22 15:52:46 UTC
Revision: 650af14d7653aa949fce5e886e685efc9cf97c10

Kotlin: 1.9.22
Groovy: 3.0.17
Ant: Apache Ant(TM) version 1.10.13 compiled on January 4 2023
JVM: 21.0.2 (Oracle Corporation 21.0.2+13-LTS-58)
OS: Mac OS X 14.4.1 aarch64
IDE: IntelliJ IDEA
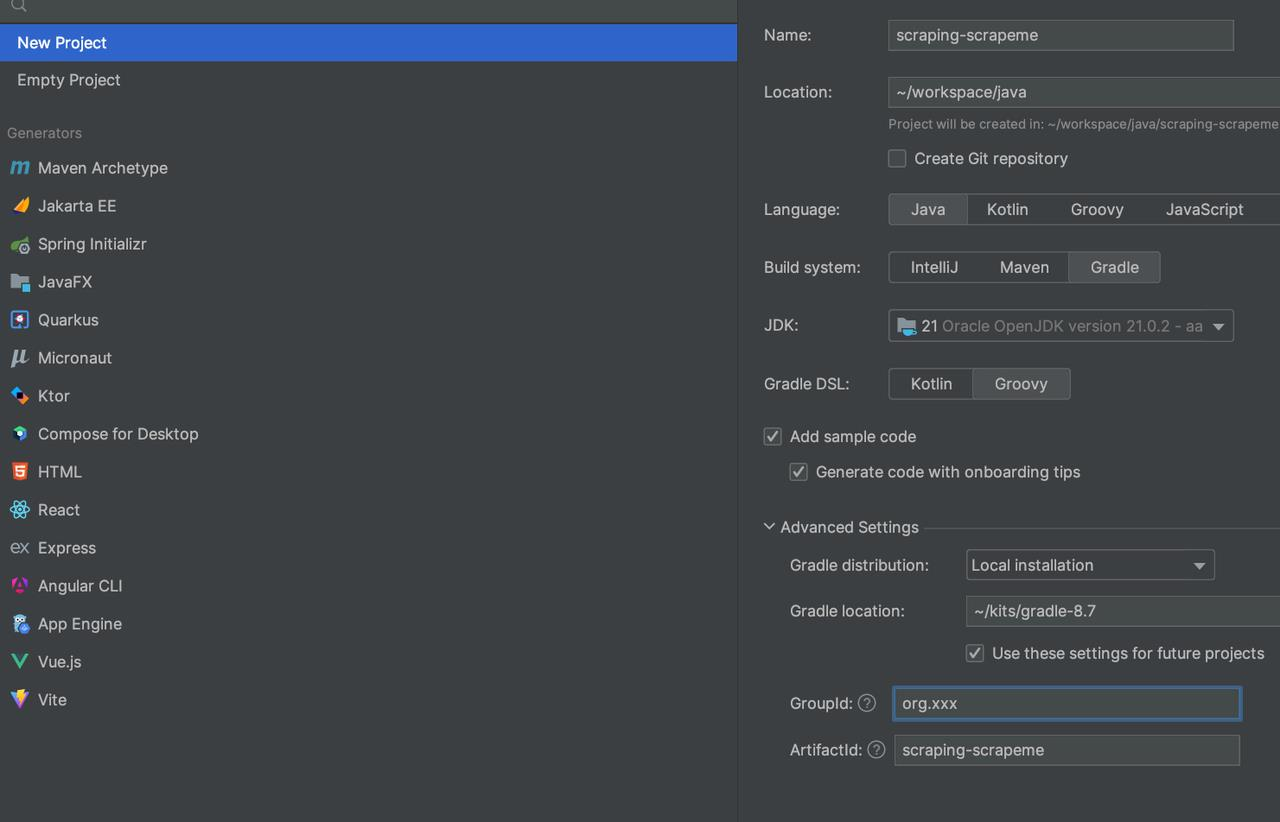
Tạo dự án
Thông tin dự án:
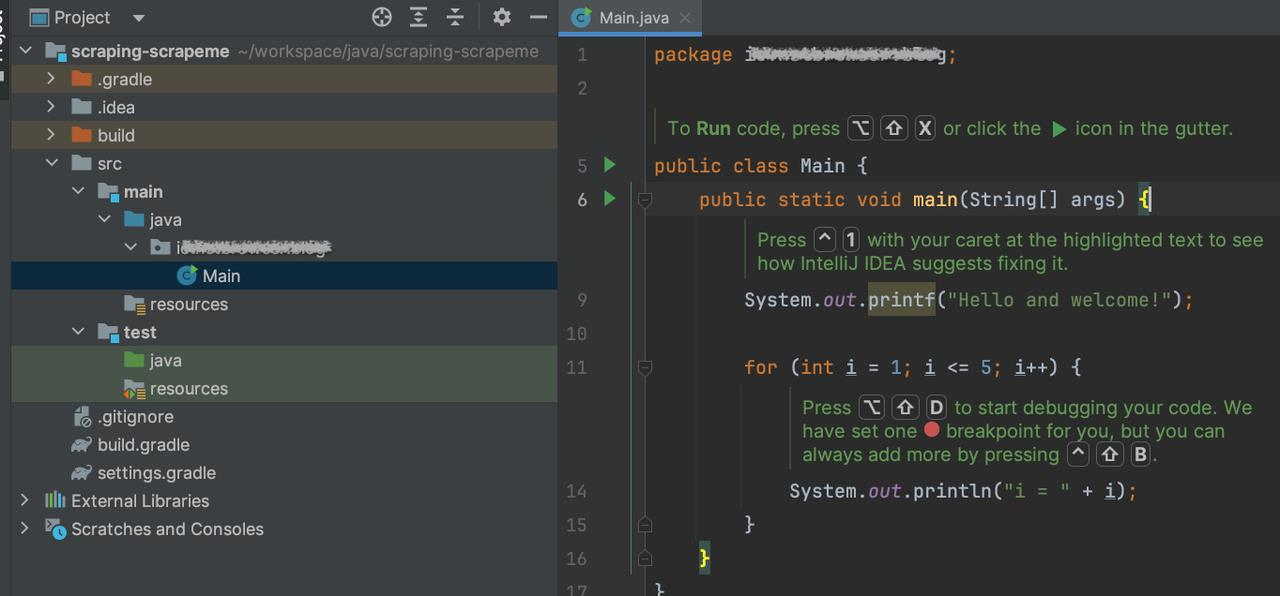
Sau khi tạo, dự án của bạn có thể trông như thế này:
Các phần phụ thuộc được thêm vào và hiện tại, jsoup sẽ đủ (jsoup: Java HTML Parser):
Now it's the right time to scrape the website! Here I will crawl the ScrapeMe, just as a reference. You can go through all the progress and then finish your project.
Target Site Analysis:
First, let's take a look at the data we want to scrape from the Scrapeme site. Open the site in a browser and view the source code to analyze the target elements. Then, retrieve the desired elements through code.
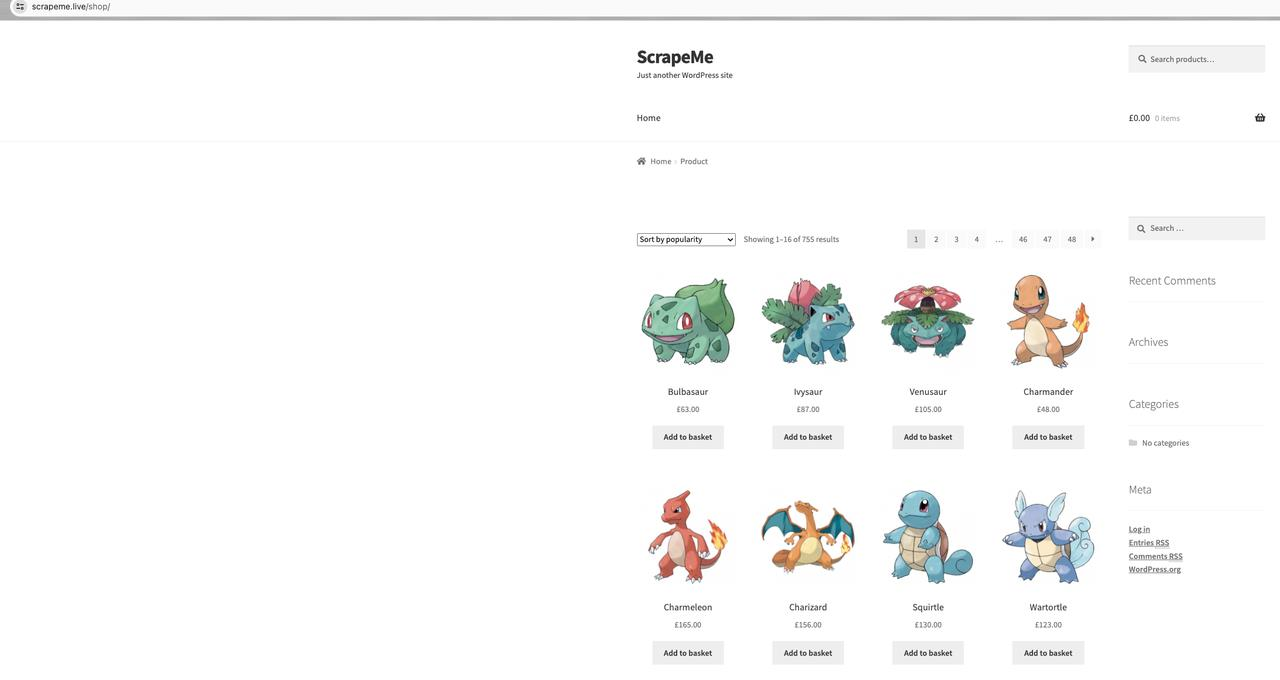
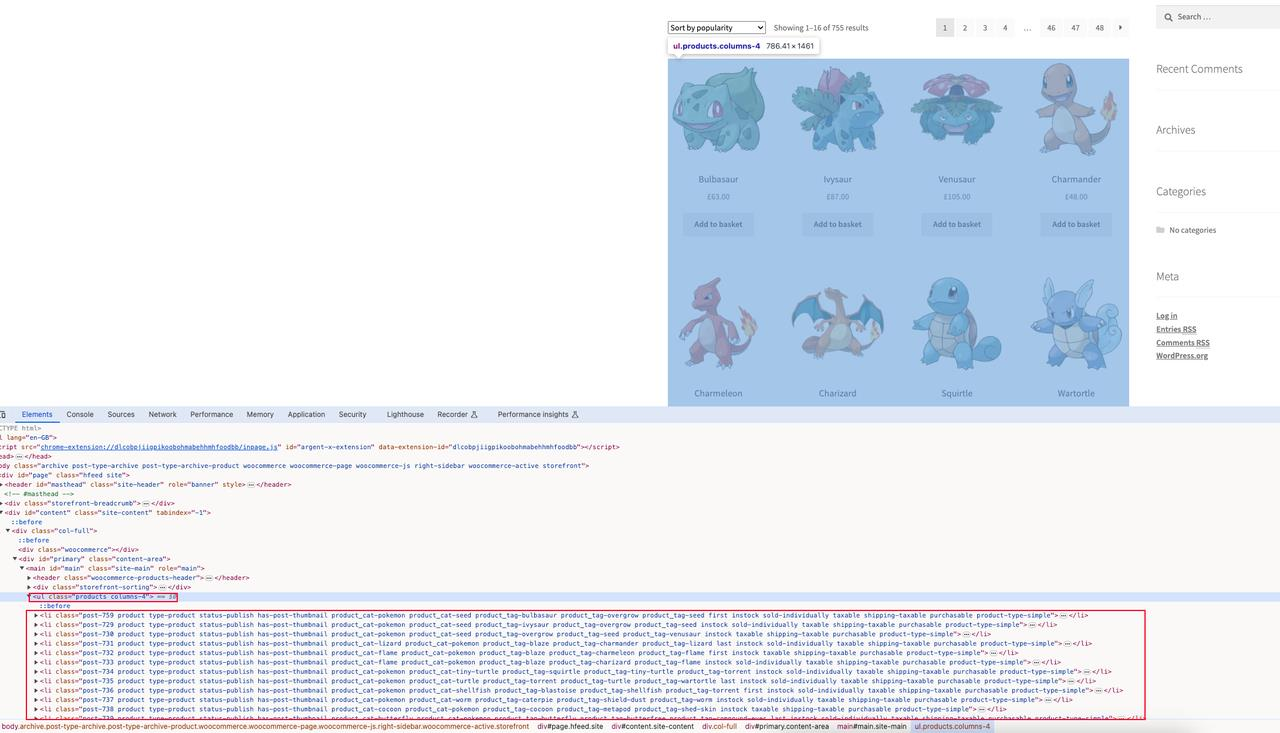
Danh sách sản phẩm trang chủ ScrapeMe:
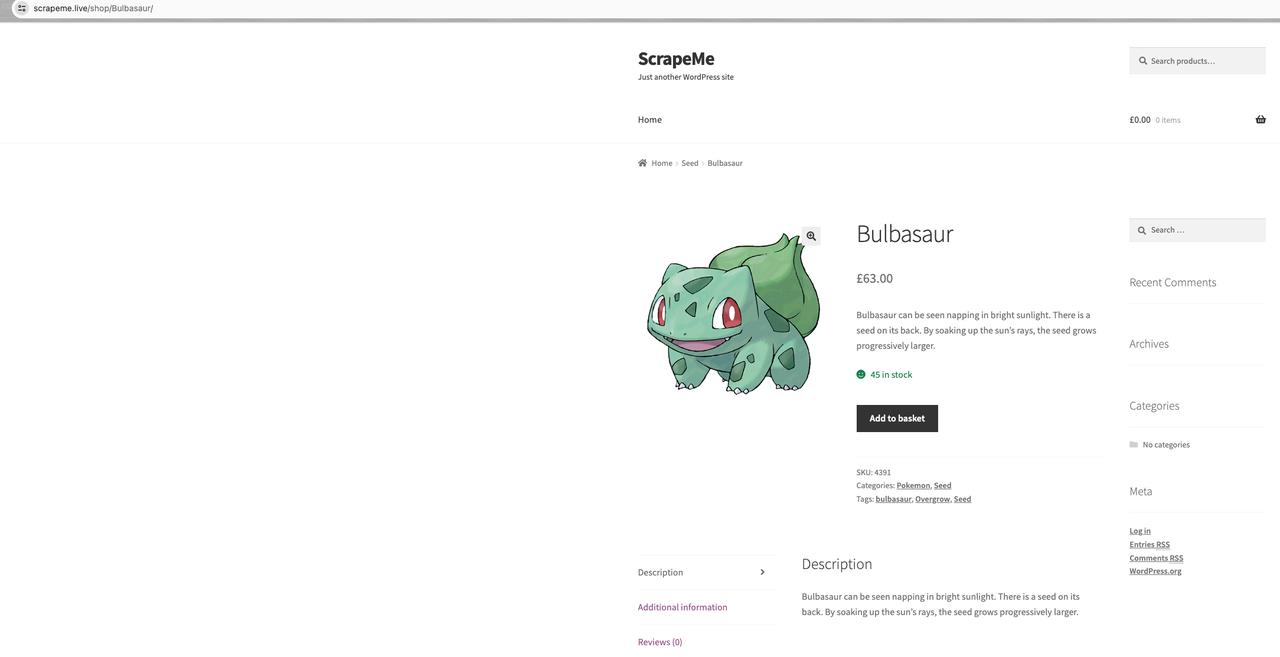
Chi tiết sản phẩm ScrapeMe:
Mục tiêu của chúng tôi là thu thập thông tin trang chủ của các sản phẩm này, bao gồm tên sản phẩm, hình ảnh sản phẩm, giá sản phẩm và địa chỉ chi tiết sản phẩm.
Phân tích mã nguồn trang
Phần tử trang
Bằng cách xem xét phân tích thành phần trang, chúng tôi biết rằng trang hiện tại có tất cả các thành phần trang sản phẩm: ul.products và từng thành phần chi tiết sản phẩm: li.product.
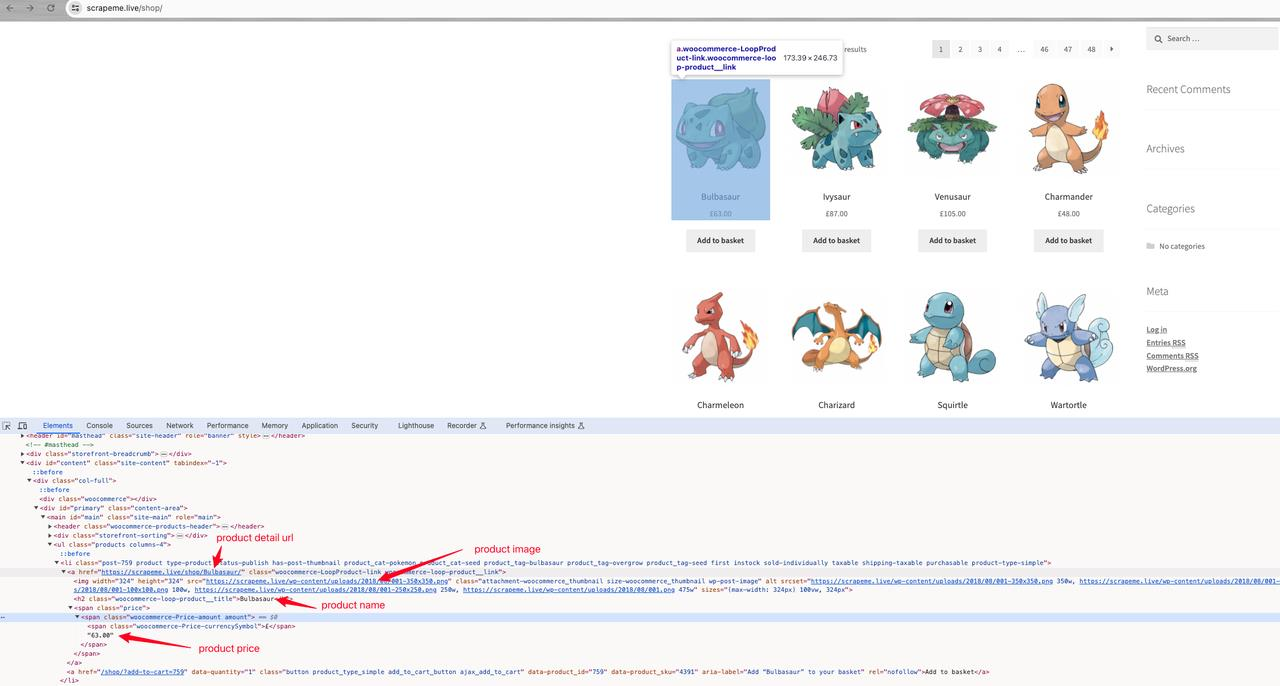
Thông tin chi tiết sản phẩm
Phân tích sâu hơn sẽ tìm thấy tên sản phẩm: a h2, hình ảnh sản phẩm: a img.src, giá sản phẩm: khoảng, địa chỉ chi tiết sản phẩm: a.href.
import org.jsoup.*;
import org.jsoup.nodes.*;
import org.jsoup.select.*;
import java.io.IOException;
import java.util.ArrayList;
import java.util.List;

public class Scraper {
  // scrapeme site url
  private static final String SCRAPEME_SITE_URL = "https://scrapeme.live/shop";

  public static List<ScrapeMeProduct> scrape() {
    // html doc for scrapeme page
    Document doc;
    // products data
    List<ScrapeMeProduct> pokemonProducts = new ArrayList<>();
    try {
      doc = Jsoup.connect(SCRAPEME_SITE_URL)
          .userAgent("Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/123.0.0.0 Safari/537.36") // mock userAgent header
          .header("Accept-Language", "*") // mock Accept-Language header
          .get();
      // select product nodes
      Elements products = doc.select("li.product");
      for (Element product : products) {
        ScrapeMeProduct pokemonProduct = new ScrapeMeProduct();
        pokemonProduct.setUrl(product.selectFirst("a").attr("href")); // parse and set product url
        pokemonProduct.setImage(product.selectFirst("img").attr("src")); // parse and set product image
        pokemonProduct.setName(product.selectFirst("h2").text()); // parse and set product name
        pokemonProduct.setPrice(product.selectFirst("span").text()); // parse and set product price
        pokemonProducts.add(pokemonProduct);
      }
    } catch (IOException e) {
      throw new RuntimeException(e);
    }
    return pokemonProducts;
  }
}
Main.java
javaCopy
import io.xxx.basic.ScrapeMeProduct;
import io.xxx.basic.Scraper;
import java.util.List;

public class Main {
  public static void main(String[] args) {
    List<ScrapeMeProduct> products = Scraper.scrape();
    products.forEach(System.out::println);
    // continue coding
  }
}
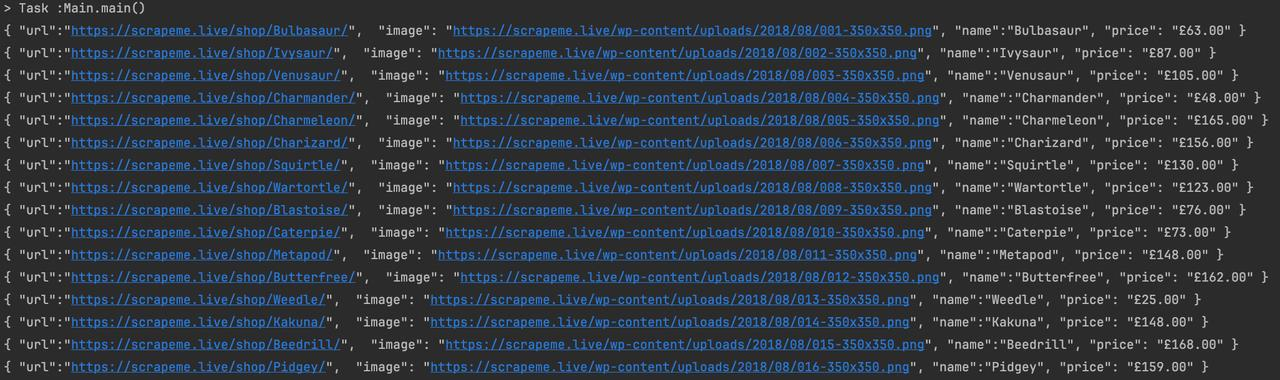
Biểu thức kết quả
Phần kết luận
Cho đến nay, chúng ta đã học cách sử dụng Java để thu thập dữ liệu trang tĩnh đơn giản, phần tiếp theo chúng ta sẽ nâng cao trên cơ sở này, sử dụng thu thập thông tin đồng thời Java ScrapeMe trên tất cả dữ liệu sản phẩm, cũng như việc sử dụng mã Java được kết nối với trình duyệt Nstbrowser cho thu thập dữ liệu vì chương nâng cao sẽ được sử dụng cho Nstbrowser trong trình duyệt không có giao diện người dùng và các tính năng khác.