Web Scraping
Web Scraping Usando Python | 2024 Guía Completa
¿Cómo hacer scraping web con python? ¿Es difícil? Usted obtendrá la información específica y los códigos para el raspado web con python en esta guía.
May 13, 2024
Si se sabe cómo extraer datos, Internet es una inmensa fuente de información. Por eso, la demanda de web scraping ha crecido exponencialmente en los últimos años, y Python se ha convertido en el lenguaje de programación más popular para esta tarea.
En este tutorial:
- Aprender y ejecutar tu primer programa en Python
- Aprender sobre URLs de páginas web
- Aprender a realizar análisis en profundidad de páginas web con Devtool.
- Aprender los fundamentos del web scraping utilizando Beautiful Soup y Requests en Python.
- Aprender a extraer datos de nodos individuales, listas, tablas y más utilizando Beautiful Soup.
- Aprender a exportar el contenido raspado en varios formatos, como JSON y CSV.
¡Vamos a sumergirnos en el mundo del web scraping usando Python!
¿Qué es Web Scraping en Python?
Web scraping es el proceso de recuperar datos de la web. Incluso copiar y pegar el contenido de una página es una forma de scraping. Sin embargo, el término se refiere típicamente a tareas automatizadas por software, esencialmente scripts (también conocidos como bots, spiders o crawlers) que acceden a sitios web y extraen los datos deseados de sus páginas. En nuestro ejemplo, utilizaremos Python.
Vale la pena señalar que muchos sitios web implementan técnicas anti-scraping por diversas razones. Pero no te preocupes, ¡más adelante te mostraremos cómo eludirlas!
Comprender el sitio web de destino
¿Estás listo para empezar? Construirás una araña real para recuperar datos de ScrapeMe, un sitio web de comercio electrónico de Pokémon creado para aprender web scraping.
Lo que verás es sólo un ejemplo, destinado a comprender cómo funciona el web scraping en Python. Sin embargo, recuerda que puedes aplicar lo que aprendas aquí a cualquier otro sitio web. El proceso puede ser más complejo, pero los conceptos clave a seguir siguen siendo los mismos.
Antes de sumergirse en la escritura de algún código, es necesario cumplir con algunos requisitos previos:
Configurar tu entorno
Para construir un raspador de datos usando Python, necesitarás descargar e instalar las siguientes herramientas:
-
Python 3.11+: Este tutorial se refiere a Python 3.11.2, la última versión en el momento de escribir este artículo.
-
pip: El índice de paquetes de Python (PyPi), que permite instalar bibliotecas con un solo comando.
-
IDE: Se puede utilizar cualquier IDE que soporte Python.
-
Nota: Si eres usuario de Windows, no olvides seleccionar la opción Añadir python.exe al PATH durante el asistente de instalación. Esto permite a Windows utilizar los comandos python y pip en el terminal. Tenga en cuenta que pip se incluye por defecto con Python 3.4 o versiones posteriores, por lo que no necesita instalarlo manualmente.
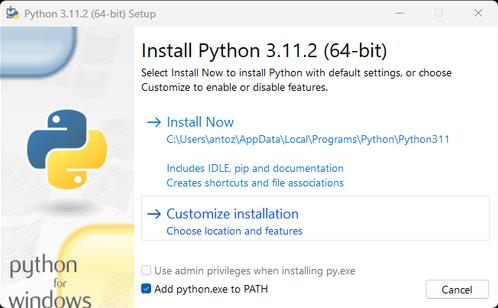
Ahora, has conseguido todo lo que necesitas para construir tu primer web scraper con Python.
¡Sigamos!
Inicializar el Proyecto Python
Crea una carpeta y dentro de ella crea un archivo llamado main.py. Abre este archivo en tu IDE.
Escribe el siguiente código en el archivo:
python
def print_hello(name):
    print(f"Hello, {name}!")

if __name__ == "__main__":
    print_hello('world')
Ejecute el siguiente comando en el terminal para verificarlo:
bash
python3 main.pySi ves la siguiente salida en el terminal, significa que has ejecutado Python con éxito:
Hello, world!Analizar el sitio web de destino
Puede que esté ansioso por empezar a codificar de inmediato, pero ese no es el mejor enfoque. En primer lugar, debe dedicar algún tiempo a comprender el sitio web de destino. Esto puede parecer tedioso o innecesario, pero es la única forma de estudiar la estructura del sitio y averiguar cómo extraer datos de él. Todos los proyectos de scraping empiezan así.
Navegar por el sitio web
Navegue por el sitio web, pruebe la funcionalidad de búsqueda, haga clic en algunos botones y observe las respuestas del sitio web y la estructura de las páginas.
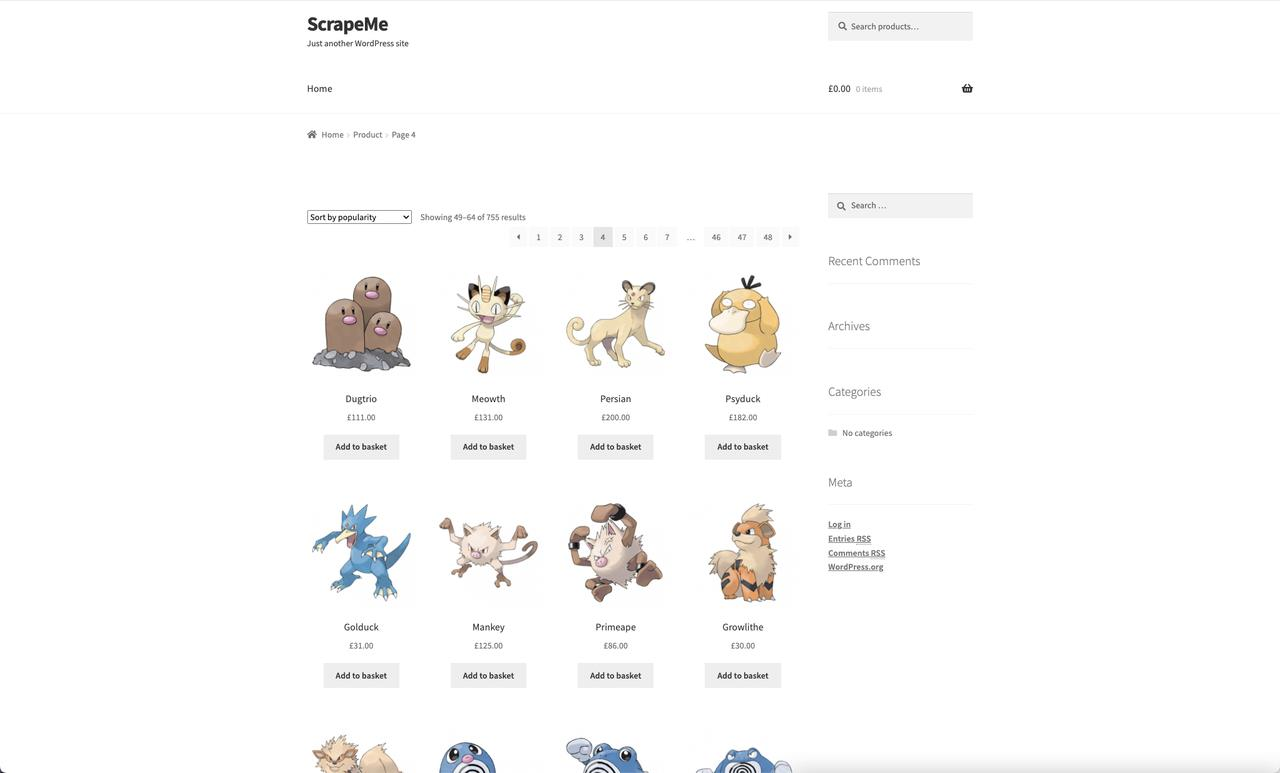
Los servidores web devuelven un documento HTML basado en la URL solicitada, con cada documento asociado a una página específica. Considere la URL de la cuarta página de la lista de productos:
Puede descomponer cualquiera de ellas en dos partes principales:
- URL base: La ruta a la sección de la tienda del sitio web. En este caso es
https://scrapeme.live/shop/page/4/. - Ubicación específica de la página: La ruta al producto específico. La URL puede terminar en
.html,.php, o puede no tener ninguna extensión.
Todos los productos ofrecidos en el sitio web tendrán la misma URL de base. Lo que varía entre cada página es su última mitad, que contiene una cadena que especifica qué página del producto debe devolver el servidor. Normalmente, las URL de páginas del mismo tipo comparten un formato similar.
Además, las URL también pueden contener información adicional:
- Parámetros de ruta: Se utilizan para capturar valores específicos en métodos RESTful (por ejemplo, el parámetro de ruta en
https://scrapeme.live/shop/page/4/es 4). - Parámetros de consulta: Estos parámetros se añaden después de un signo de interrogación (
?) al final de la URL. Suelen codificar valores de filtro que se envían al servidor al realizar una búsqueda (por ejemplo, enhttps://www.example.com/search?search=blabla&sort=newest,search=blablaysort=newestson parámetros de consulta).
Es importante tener en cuenta que cualquier cadena de parámetros de consulta contiene:
?: Marca el inicio.- Pares de parámetros
clave=valorseparados por&:dondeclavees el nombre de un parámetro yvalorrepresenta su valor. Las cadenas de consulta contienen parámetros en pares clave-valor separados por&.
En otras palabras, las URL no son simples cadenas de localización de documentos HTML. Pueden contener información de parámetros que los servidores utilizan para ejecutar consultas y rellenar páginas con datos específicos.
Uso de DevTools para inspeccionar el sitio web
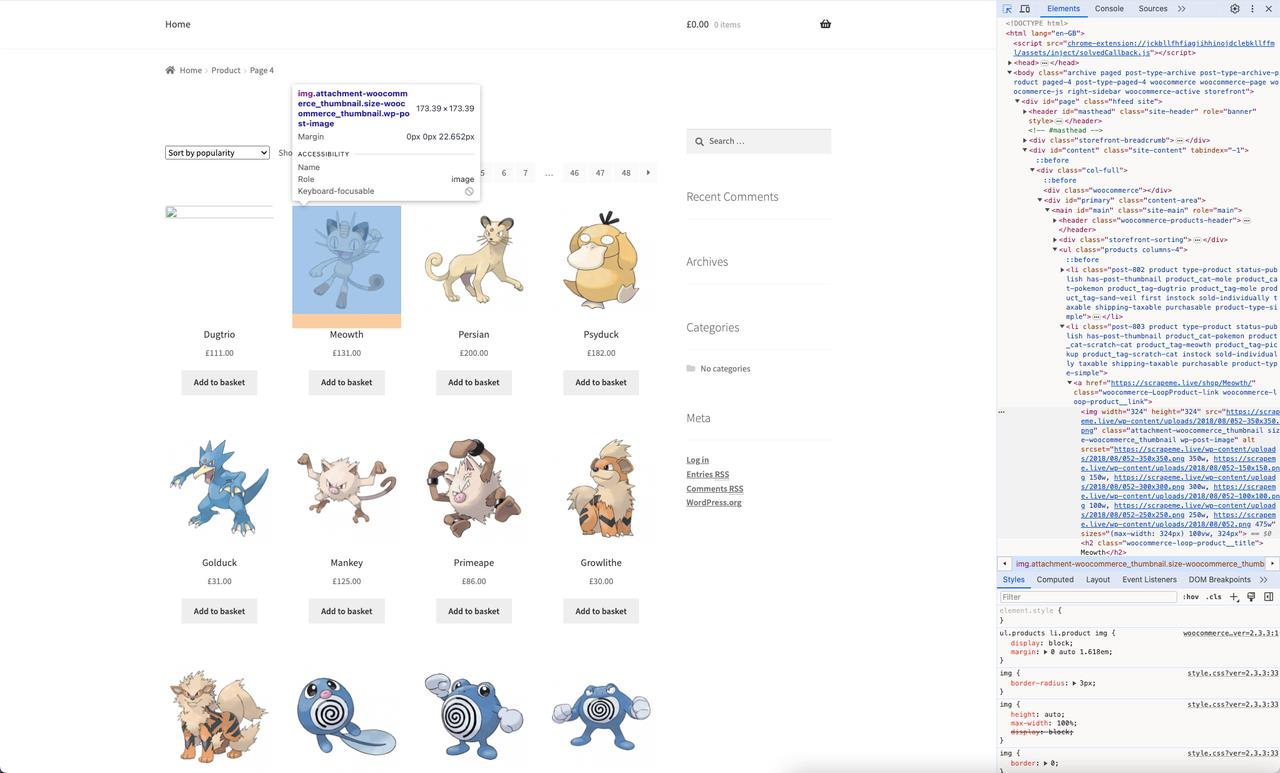
Ya estás familiarizado con el sitio web. El siguiente paso es profundizar en el código HTML de las páginas, estudiando su estructura y contenido para entender cómo extraer datos de ellas.
Todos los navegadores modernos vienen con un conjunto de herramientas avanzadas para desarrolladores, la mayoría de las cuales ofrecen funcionalidades casi idénticas. Estas herramientas permiten explorar el código HTML de las páginas web y trabajar con él. En este tutorial de Python sobre web scraping, verás la aplicación práctica de las DevTools de Chrome.
Haz clic con el botón derecho en un elemento HTML y selecciona Inspeccionar para abrir la ventana DevTools. Si el sitio web tiene desactivado el menú del botón derecho, haz lo siguiente:
- En macOS: Selecciona "Ver > Desarrollador > Herramienta de desarrollo" en la barra de menús.
- En Windows y Linux: Haga clic en el botón de menú "⋮" de la esquina superior derecha y, a continuación, seleccione "Más herramientas > Herramientas de desarrollador".
Le permiten inspeccionar la estructura del Modelo de Objetos del Documento (DOM) de la página web. Esto, a su vez, le ayuda a comprender el código fuente con mayor profundidad. En la sección DevTools, navega hasta la pestañaElementospara acceder al DOM.
Los retos del Web Scraping
Sin embargo, el web scraping se enfrenta a numerosos retos en el avanzado panorama en línea actual. Los sitios web suelen
- imponen restricciones de acceso y medidas de control, lo que dificulta el proceso de rastreo y la recuperación de datos
- implementan mecanismos de verificación humana como CAPTCHA, cuya gestión manual puede requerir mucho tiempo y trabajo.
Nstbrowser se considera una de las soluciones a estos retos. Con Nstbrowser, puede superar estos obstáculos sin esfuerzo. Emplea técnicas de emulación de navegadores para imitar el comportamiento humano, reduciendo el riesgo de que se activen los mecanismos de protección automatizados. La rotación de User-Agent garantiza que sus actividades de scraping pasen desapercibidas.
¿Cómo raspar un sitio web con Python?
Ahora, ¡todos los preparativos han terminado! Los pasos más detallados son los siguientes:
Paso 1. Descarga la página HTML
Prepárate para encender tu Python, ya que estás listo para escribir algo de código.
Suponiendo que desea raspar algunos datos de la siguiente ubicación:
typescript
https://scrapeme.live/shop/Para recuperar el código HTML de la página de destino, primero hay que descargar el documento HTML asociado a la URL de la página. Para ello, puede utilizar la biblioteca requests de Python.
Para instalar la biblioteca requests, utilice el siguiente comando:
shell
pip install requestsCrea un nuevo archivo scraper.py y añade el siguiente código al archivo:
python
import requests

# download the HTML document with an HTTP GET request
response = requests.get("https://scrapeme.live/shop/")

# print the HTML content of the page
print(response.text)
Este código importa la biblioteca requests y la utiliza para realizar una petición GET a la URL de la página de destino. Devuelve el contenido de la respuesta, que incluye el documento HTML.
Al imprimir el atributo text de la respuesta, podrás ver la estructura del código de la página de destino.
html
<!doctype html>
<html lang="en-GB">
<head>
<meta charset="UTF-8">
<meta name="viewport" content="width=device-width, initial-scale=1, maximum-scale=2.0">
<link rel="profile" href="http://gmpg.org/xfn/11">
<link rel="pingback" href="https://scrapeme.live/xmlrpc.php">
<title>Products – ScrapeMe</title>
<!-- rest of the page omitted for brevity... -->Error común: Olvidarse de gestionar las excepciones.
Una petición GET puede fallar por varias razones, como que el servidor no esté disponible temporalmente, una URL incorrecta o que su IP esté bloqueada. Por lo tanto, es importante manejar los errores de la siguiente manera:
python
import requests

# download the HTML document with an HTTP GET request
response = requests.get("https://scrapeme.live/shop/")

if response.ok:
  # scraping logic here
else:
  # log the error response
  # in case of 4xx or 5xx
  print(response)
Utilizando técnicas de gestión de errores, su script no se bloqueará si se produce un error durante la petición. Sólo continuará si el código de estado de la respuesta está en el rango 2xx.
Paso 2. Análisis del contenido HTML
En el paso anterior, ha recuperado el documento HTML del servidor. Si lo miras, verás una larga cadena de código y la única forma de entenderlo es extraer los datos necesarios mediante el análisis sintáctico de HTML.
Beautiful Soup es una biblioteca de Python para analizar contenido XML y HTML, y expone una API para explorar código HTML. En otras palabras, permite seleccionar elementos HTML y extraer fácilmente datos de ellos.
Para instalar la biblioteca, escriba y ejecute el siguiente comando en un terminal
shell
pip install beautifulsoup4Primero se solicita la página mediante peticiones y luego se utiliza para analizar el contenido recuperado:
python
import requests
from bs4 import BeautifulSoup

# download the HTML document with an HTTP GET request
response = requests.get("https://scrapeme.live/shop/")

if response.ok:
  # scraping logic here
  soup = BeautifulSoup(response.text, 'html.parser')
else:
  # log the error response
  # in case of 4xx or 5xx
  print(response)
Es importante tener en cuenta que los sitios web contienen datos en diversos formatos. Elementos individuales, listas y tablas son sólo algunos ejemplos. Para que tu Python scraper sea efectivo, necesitas saber cómo usar Beautiful Soup en muchos escenarios. Veamos cómo afrontar los retos más comunes.
Paso 3. Extraer datos de un solo elemento
Beautiful Soup proporciona varios métodos para seleccionar elementos HTML del DOM, y el atributo id es la forma más eficiente de seleccionar un único elemento. Como su nombre indica, el id identifica de forma única un nodo HTML en la página.
Para encontrar el cuadro de búsqueda, haz clic con el botón derecho y abre las Devtools para ver su id:
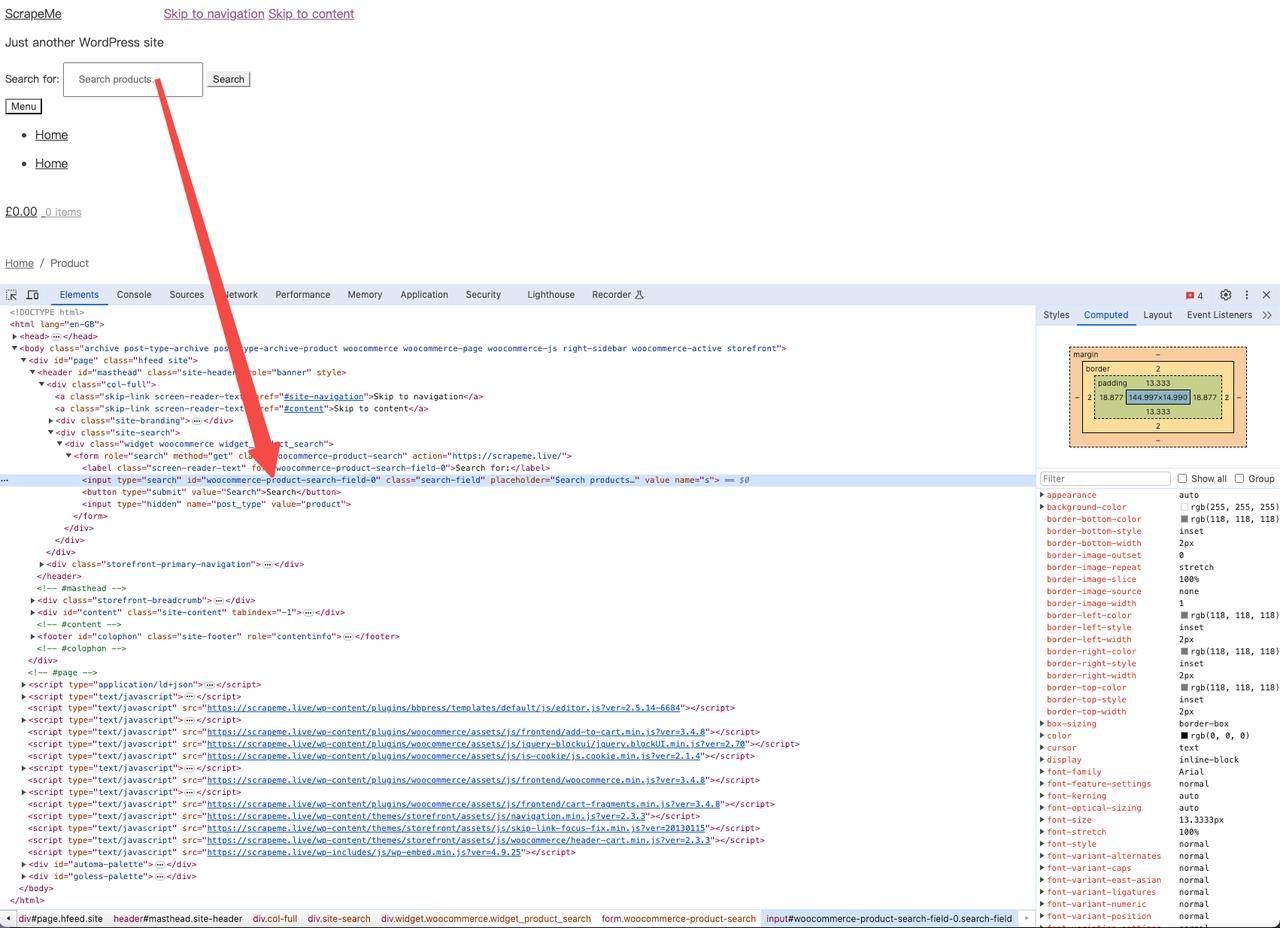
Como puedes ver, el elemento <input> tiene el siguiente id:
python
woocommerce-product-search-field-0Puede utilizar esta información para seleccionar el elemento de búsqueda del producto:
python
product_search_element = soup.find(id="woocommerce-product-search-field-0")La función find() permite extraer un único elemento HTML del DOM.
Tenga en cuenta que el id es un atributo opcional. Por eso existen otros métodos para seleccionar elementos:
Por etiqueta: Utilice find() sin ningún parámetro:
python
h1_element = soup.find("h1")Por clase: Añade el parámetro class_:
python
search_input_element = soup.find(class_="search_field")Por atributo: Utiliza el parámetro attrs:
python
search_input_element = soup.find(attrs={"name": "s"})Paso 4. Obteniendo una lista de elementos
Ahora que ha aprendido a navegar por la página y extraer información de los elementos, ¡profundicemos en el web scraping de verdad!
Las páginas web suelen contener listas de elementos, como listados de productos en una tienda de comercio electrónico. Recuperar datos de ellos puede llevar mucho tiempo, ¡pero aquí es donde entra en juego el web scraping Beautiful Soup de Python!
La lista de productos en Pokémon está contenida dentro de los elementos <li>:
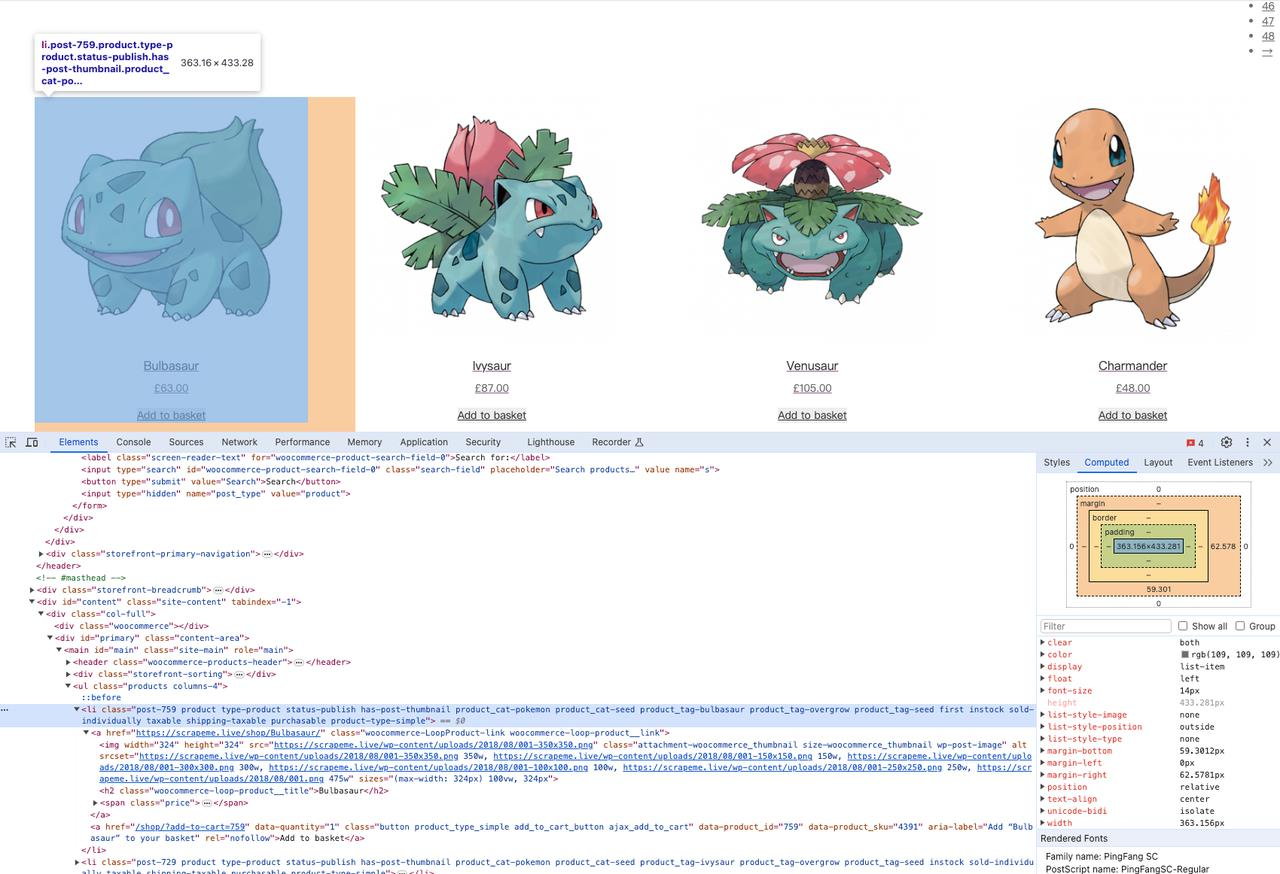
Consigámoslos:
python
product_elements = soup.select("li.product")Repita todos los datos de sus productos de la siguiente manera:
python
for product_element in product_elements:
    product_name = product_element.find("h2").get_text()
    product_url = product_element.find("a")["href"]
    product_image = product_element.find("img")["src"]
    product_price = product_element.select_one(".amount").get_text()
Al manejar una lista de elementos, se recomienda almacenar los datos extraídos en una lista de diccionarios. En Python, un diccionario es una colección desordenada de pares clave-valor y puedes usarlo de la siguiente manera:
python
# the list of dictionaries containing the
  # scrape data
  pokemon_products = []

  for product_element in product_elements:
    product_name = product_element.find("h2").get_text()
    product_url = product_element.find("a")["href"]
    product_image = product_element.find("img")["src"]
    product_price = product_element.select_one(".amount").get_text()

    # define a dictionary with the scraped data
    new_pokemon_product = {
      "name": product_name,
      "url": product_url,
      "image": product_image,
      "price": product_price
    }
    # add the new product dictionary to the list
    pokemon_products.append(new_pokemon_product)

  # print the list of dictionaries
  print(pokemon_products)
Ahora tienes una lista llamada pokemon_products que contiene toda la información extraída de cada producto individual en la página.
¡Fantástico! Ahora tiene todos los componentes básicos que necesita para crear un raspador de datos utilizando Beautiful Soup en Python. Pero sigamos avanzando; ¡El tutorial aún no ha terminado!
Paso 5. Exportar los datos extraídos
Recuperar el contenido de una página web suele ser el primer paso de un proceso más amplio. El siguiente paso es utilizar la información extraída para diferentes necesidades y propósitos. Por tanto, es fundamental convertirlo a un formato que sea fácil de leer y explorar, como CSV o JSON.
Ha encontrado la información del producto en la lista pokemon_products proporcionada anteriormente. Ahora, ¡aprendamos cómo convertirlo a un nuevo formato y exportarlo a un archivo en Python!
Exportar como CSV
CSV es un formato popular para el intercambio, almacenamiento y análisis de datos, especialmente cuando se trata de grandes conjuntos de datos. Los archivos CSV almacenan información en forma de tabla, con valores separados por comas. Esto lo hace compatible con programas de hojas de cálculo como Microsoft Excel.
Así es como puedes convertir una lista de diccionarios en un archivo CSV en Python:
python
import csv

# scraping logic...

# write the scraped data to a CSV file
csv_file = open("pokemon_products.csv", "w", encoding="utf-8", newline="")

# create a CSV writer object
writer = csv.writer(csv_file)

# convert each element of the list to a row in the CSV file
for pokemon_product in pokemon_products:
writer.writerow(pokemon_product.values())

# release the resources
csv_file.close()
Exportar como JSON
JSON es un formato de intercambio de datos ligero, versátil y popular, especialmente en aplicaciones web. Se utiliza comúnmente para transferir información entre servidores o entre clientes y servidores a través de API. Muchos lenguajes de programación lo admiten.
Aquí está el código para exportar la lista de diccionarios como JSON en Python:
python
import json

# scraping logic...

# create the pokemon_products.json
json_file = open("pokemon_products.json", "w")

# convert pokemon_products to JSON
# and write it into the JSON output file
json.dump(pokemon_products, json_file)

# release the file resources
json_file.close()
La lógica de exportación mencionada anteriormente gira en torno a la función json.dump(), que proviene del módulo json estándar de Python y le permite escribir objetos de Python en un archivo con formato JSON.
json.dump() toma dos parámetros:
- El objeto Python que se convertirá al formato JSON.
- El objeto de archivo se inicializó con la ubicación donde se escribirán los datos JSON, utilizando la función open().
Después de completar todos los pasos mencionados anteriormente, puede navegar a la carpeta donde se encuentra su código y encontrará que se han creado los archivos CSV y JSON que extrajo y exportó.
Conclusión
¡Felicidades! Con este tutorial, ha aprendido cómo realizar web scraping usando Python y extraer información de páginas web.
Más


