Browserless
Làm thế nào để thực hiện Web Scraping với Browserless trên Cloud?
Khám phá sức mạnh của trình duyệt đám mây! Tìm hiểu lý do tại sao Browserless là lựa chọn hàng đầu cho việc trích xuất dữ liệu web mượt mà và học cách bắt đầu sử dụng trên đám mây!
Sep 24, 2024Triệu Lệ Chi
Trình duyệt đám mây là gì?
Trình duyệt đám mây là sự kết hợp dựa trên đám mây của ứng dụng trình duyệt web với container ảo hóa thực hiện khái niệm cách ly trình duyệt từ xa. Nhà phát triển có thể tự động hóa trình duyệt web bằng cách sử dụng các công cụ phổ biến như Playwright và Puppeteer để thu thập dữ liệu web và kiểm tra web.
Trình duyệt đám mây thực thi các lệnh từ mạng trong một container an toàn, riêng biệt với điểm cuối của người dùng, và truy cập thông qua giao thức hiển thị từ xa. Kết quả là, các ứng dụng trình duyệt được tập trung hơn, dễ quản lý hơn, hiệu quả hơn về chi phí, có thể mở rộng và được bảo vệ.
Tại sao nên thu thập dữ liệu web với Browserless?
Browserless là một giải pháp dựa trên đám mây mạnh mẽ cho tự động hóa trình duyệt liền mạch, thu thập dữ liệu web và kiểm tra. Mục tiêu chính của Browserless là đơn giản hóa và mở rộng quy mô các tác vụ tự động hóa trình duyệt web như kiểm tra và thu thập dữ liệu và điều này có thể được tiếp cận theo một trong hai cách:
- Chạy nhiều phiên bản trình duyệt trên Docker hoặc Kubernetes.
- Sử dụng các máy chủ proxy trình điều khiển web hiện có như Selenium Grid.
Cách thu thập dữ liệu web với Browserless trên đám mây?
Bước 1: Chuẩn bị
Trước khi bắt đầu, chúng ta cần có dịch vụ Browserless. Sử dụng Browserless có thể giải quyết các tác vụ tự động hóa quy mô lớn và thu thập dữ liệu web phức tạp, và hiện tại nó đã đạt được triển khai đám mây được quản lý đầy đủ.
Browserless áp dụng phương pháp tập trung vào trình duyệt, cung cấp khả năng triển khai ẩn danh mạnh mẽ và cung cấp hiệu suất và độ tin cậy cao hơn. Để biết thêm thông tin về Browserless, bạn có thể tải xuống tài liệu để tìm hiểu thêm.
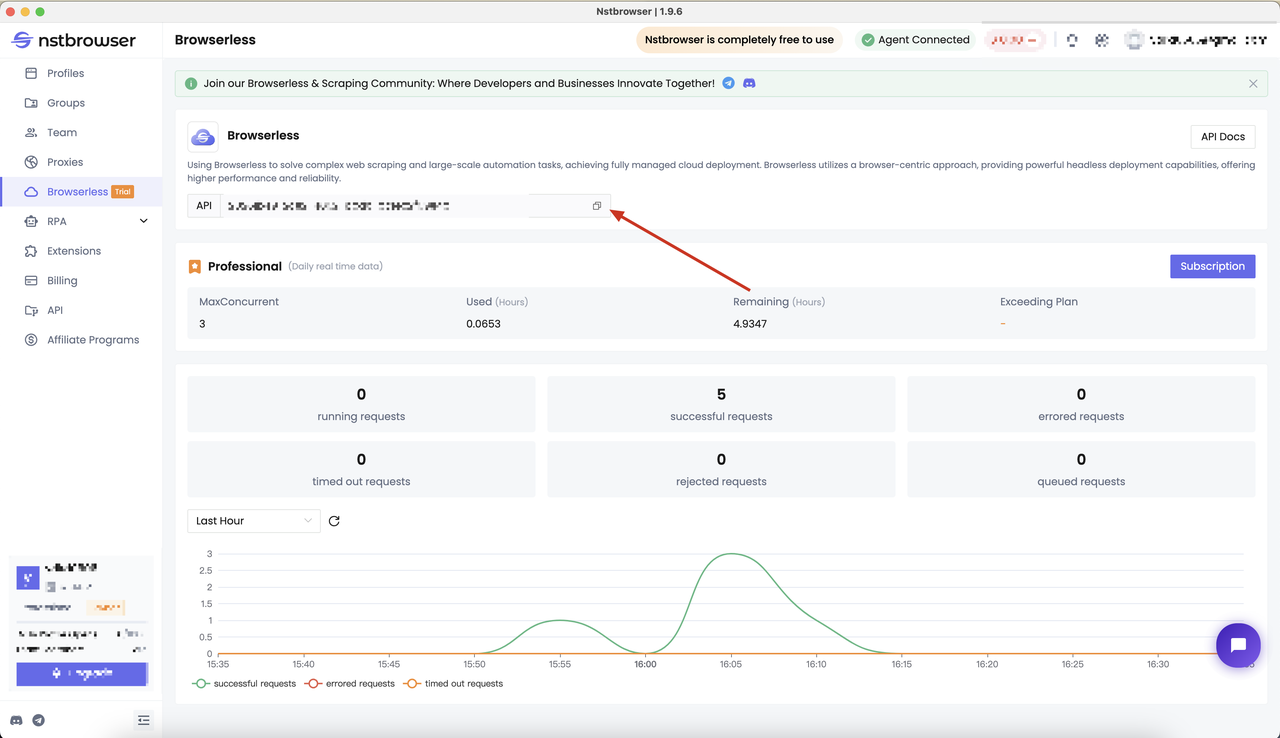
- Nhận API KEY và đi đến trang menu Browserless của Nstbrowser client, hoặc bạn có thể đi đến Nstbrowser client để truy cập
Bạn có bất kỳ ý tưởng tuyệt vời nào và nghi ngờ về thu thập dữ liệu web và Browserless?
Hãy xem những gì các nhà phát triển khác đang chia sẻ trên Discord và Telegram!
Bước 2: Xác nhận mục tiêu thu thập dữ liệu
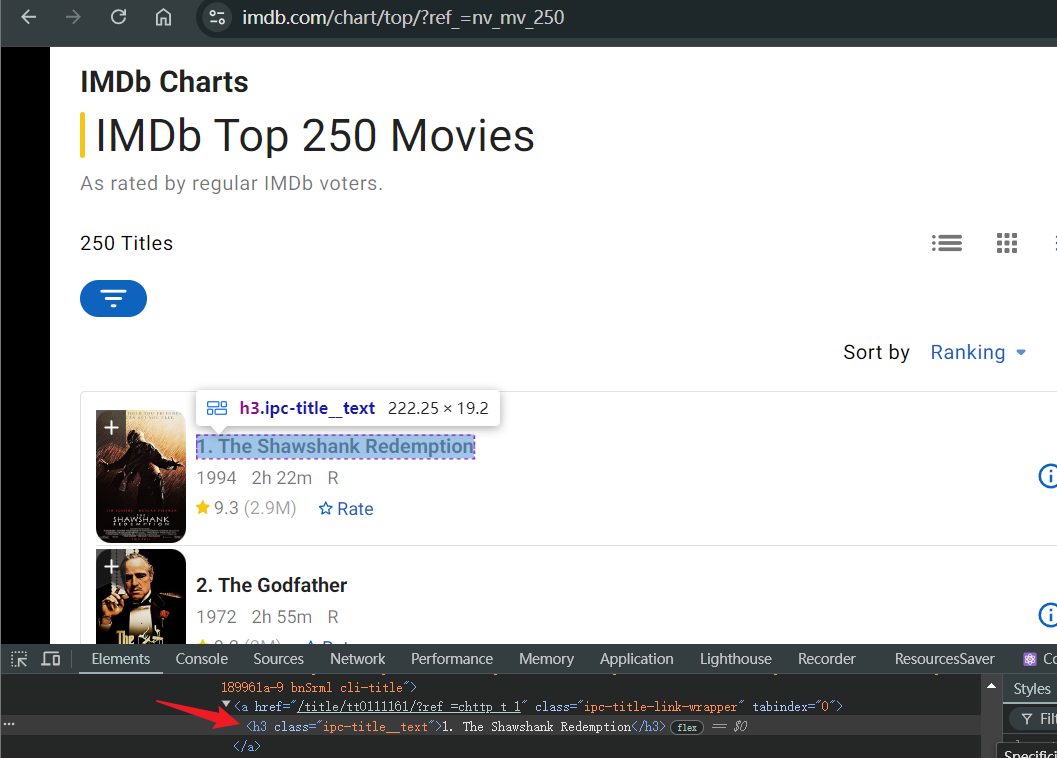
Trước khi bắt đầu, chúng ta cần đảm bảo những gì chúng ta sẽ thu thập dữ liệu. Trong ví dụ sau, chúng tôi cố gắng thu thập tiêu đề phim trong IMDb's Top 250 Phim. Sau khi mở trang:
- Chờ trang tải bình thường và định vị trang đến tiêu đề phim trong IMDb Top 250 Movies
- Mở bảng điều khiển gỡ lỗi và xác định phần tử html của tiêu đề phim
- Sử dụng thư viện yêu thích của bạn để lấy tiêu đề phim
Bước 3: Bắt đầu thu thập dữ liệu
Mọi thứ đã sẵn sàng, hãy bắt đầu thu thập dữ liệu! Chúng tôi chọn sử dụng Browserless đám mây mạnh mẽ được cung cấp bởi Nstbrowser để thu thập dữ liệu nội dung trên. Dưới đây, chúng tôi sẽ liệt kê một số thư viện phổ biến được sử dụng cùng nhau.
Puppeteer
Nếu bạn chưa chọn thư viện nào, chúng tôi khuyên bạn nên sử dụng Puppeteer vì nó rất năng động và có nhiều người duy trì. Nó cũng được xây dựng bởi các nhà phát triển Chrome, vì vậy nó là một trong những thư viện chất lượng cao nhất.
- Cài đặt puppeteer-core
Bash
# pnpm
pnpm i puppeteer-core
# yarn
yarn add puppeteer-core
# npm
npm i --save puppeteer-core- Kịch bản mã
JavaScript
import puppeteer from "puppeteer-core";

const token = "your api key"; // 'your proxy'

const config = {
  proxy: 'your proxy', // required; input format: schema://user:password@host:port eg: http://user:password@localhost:8080
  // platform: 'windows', // support: windows, mac, linux
  // kernel: 'chromium', // only support: chromium
  // kernelMilestone: '128', // support: 128
  // args: {
  //     "--proxy-bypass-list": "detect.nstbrowser.io"
  // }, // browser args
  // fingerprint: {
  //     userAgent: 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36', // userAgent supportted since v0.15.0
  // },
};

const query = new URLSearchParams({
  token: token, // required
  config: JSON.stringify(config),
});

const browserWSEndpoint = `https://less.nstbrowser.io/connect?${query.toString()}`;
// Connect browserless
const browser = await puppeteer.connect({
  browserWSEndpoint,
  defaultViewport: null,
})
console.info('Connected!');

// Create new page
const page = await browser.newPage()

// Visit IMDb top 250 page
await page.goto('https://www.imdb.com/chart/top/?ref_=nv_mv_250')

// Wait for the movie list to load
await page.waitForSelector('.ipc-metadata-list')

// Get a list of movie titles
const moviesList = await page.$$eval('.ipc-metadata-list h3.ipc-title__text', nodes => nodes.map(node => node.textContent));

console.log('[IMDb Top 250 Movies]===>', moviesList);

// Close browser
await browser.close();
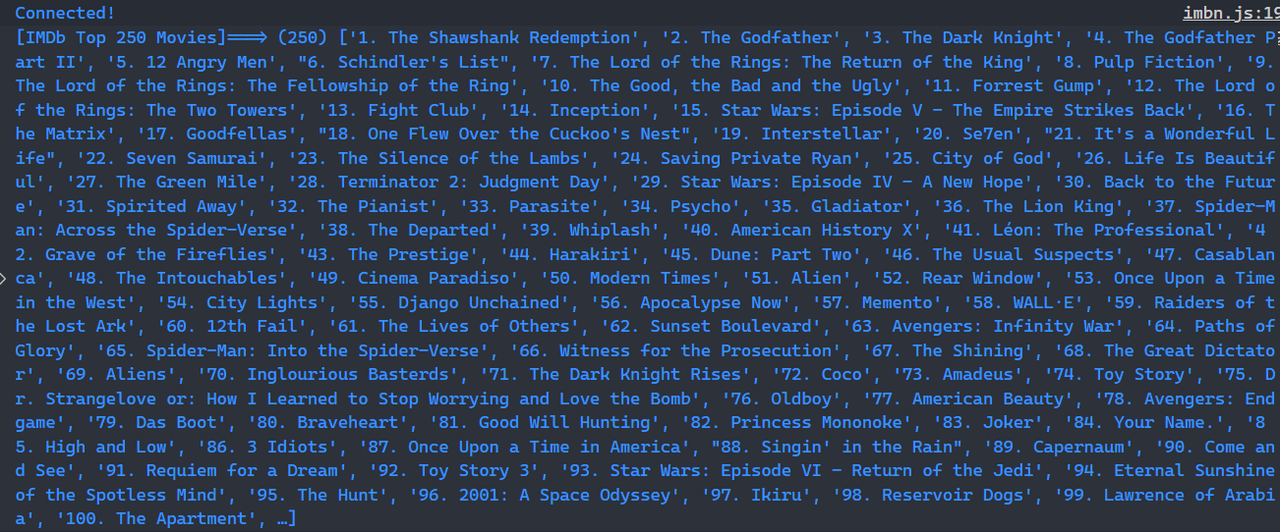
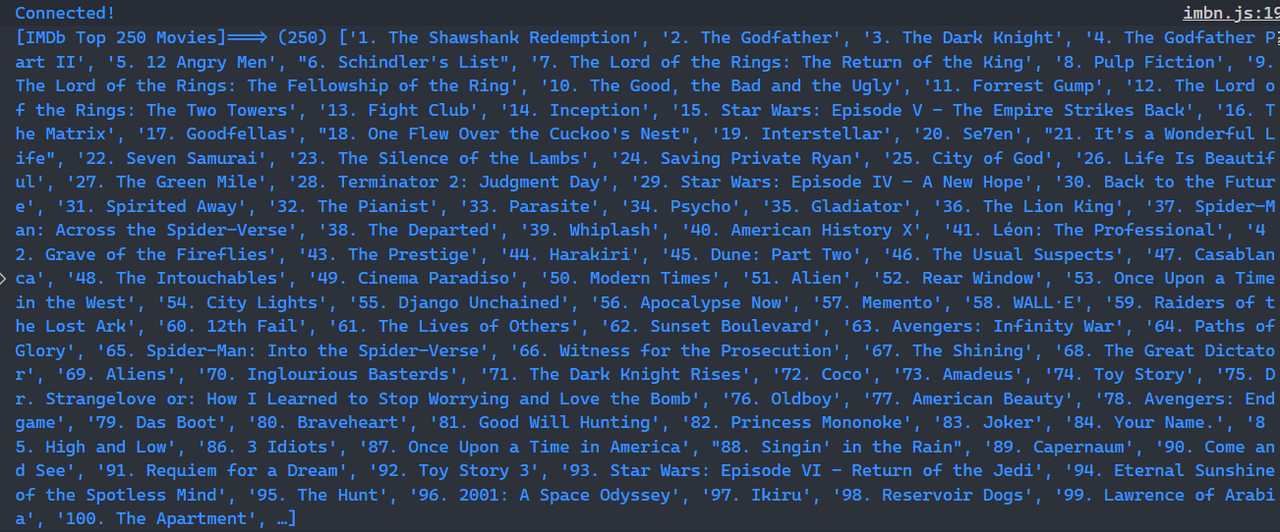
Chúc mừng! Chúng tôi đã hoàn thành nhiệm vụ thu thập dữ liệu của mình. Bạn có thể thấy kết quả của 250 bộ phim trong bảng điều khiển:
Playwright
Đây là một dự án mã nguồn mở năng động với một lượng lớn người đóng góp. Playwright được phát triển bởi Microsoft và hỗ trợ nhiều trình duyệt (Chromium, Firefox và WebKit) và nhiều ngôn ngữ lập trình (Nodejs, Python, .NET và Java), biến nó trở thành một trong những công cụ tự động hóa trình duyệt linh hoạt và chất lượng cao nhất.
Sử dụng trong Nodejs
- Cài đặt Playwright
Bash
# pnpm
pnpm create playwright
# yarn
yarn create playwright
# npm
npm init playwright@latest- Kịch bản mã
JavaScript
import { chromium } from 'playwright'

const token = "your api key"; // 'your proxy'

const config = {
  proxy: 'your proxy', // required; input format: schema://user:password@host:port eg: http://user:password@localhost:8080
  // platform: 'windows', // support: windows, mac, linux
  // kernel: 'chromium', // only support: chromium
  // kernelMilestone: '128', // support: 128
  // args: {
  //     "--proxy-bypass-list": "detect.nstbrowser.io"
  // }, // browser args
  // fingerprint: {
  //     userAgent: 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36', // userAgent supportted since v0.15.0
  // },
};

const query = new URLSearchParams({
  token: token, // required
  config: JSON.stringify(config),
});

const browserWSEndpoint = `ws://less.nstbrowser.io/connect?${query.toString()}`;
// Connect browserless
const browser = await chromium.connectOverCDP(browserWSEndpoint);
console.info('Connected!');

// Create new page
const page = await browser.newPage();

// Visit IMDb's top 250 page
await page.goto('https://www.imdb.com/chart/top/?ref_=nv_mv_250');

// Wait for movie list to load
await page.waitForSelector('.ipc-metadata-list');

// Get a list of movie titles
const moviesList = await page.$$eval('.ipc-metadata-list h3.ipc-title__text', nodes => nodes.map(node => node.textContent));

console.log('[IMDb Top 250 Movies]===>', moviesList);

// Close browser
await browser.close();
Ở đây, chúng ta có thể tìm ra danh sách sau khi chạy dự án của mình:
Sử dụng trong Python
- Cài đặt Playwright
Bash
pip install pytest-playwright- Kịch bản mã
Python
from playwright.sync_api import sync_playwright
from urllib.parse import urlencode
import json

token = "your api key"  # 'your proxy'

config = {
    "proxy": "your proxy",  # required; input format: schema://user:password@host:port eg: http://user:password@localhost:8080
    # platform: 'windows', // support: windows, mac, linux
    # kernel: 'chromium', // only support: chromium
    # kernelMilestone: '128', // support: 128
    # args: {
    #     "--proxy-bypass-list": "detect.nstbrowser.io"
    # }, // browser args
    # fingerprint: {
    #     userAgent: 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36', // userAgent supportted since v0.15.0
    # },
}

query = urlencode({"token": token, "config": json.dumps(config)})

browser_ws_endpoint = f"ws://less.nstbrowser.io/connect?{query}"

def scrape_imdb_top_250():
    with sync_playwright() as p:
        # Connect browserless
        browser = p.chromium.connect_over_cdp(browser_ws_endpoint)
        print("Connected!")

        # Create new page
        page = browser.new_page()

        # Visit IMDb top 250 page
        page.goto("https://www.imdb.com/chart/top/?ref_=nv_mv_250")

        # Wait for movie list to load
        page.wait_for_selector(".ipc-metadata-list")

        # Get a list of movie titles
        movies_list = page.eval_on_selector_all(
            ".ipc-metadata-list h3.ipc-title__text",
            "nodes => nodes.map(node => node.textContent)",
        )

        print("[IMDb Top 250 Movies]===>", movies_list)

        # Close browser
        browser.close()

scrape_imdb_top_250()
Tất nhiên, đây là kết quả thu thập dữ liệu:
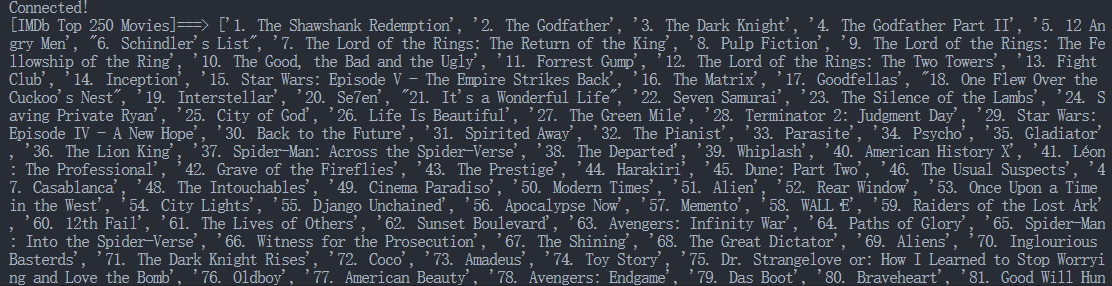
Chọn ngôn ngữ và thư viện yêu thích của bạn, thực thi kịch bản tương ứng, và bạn có thể xem kết quả thu thập dữ liệu!
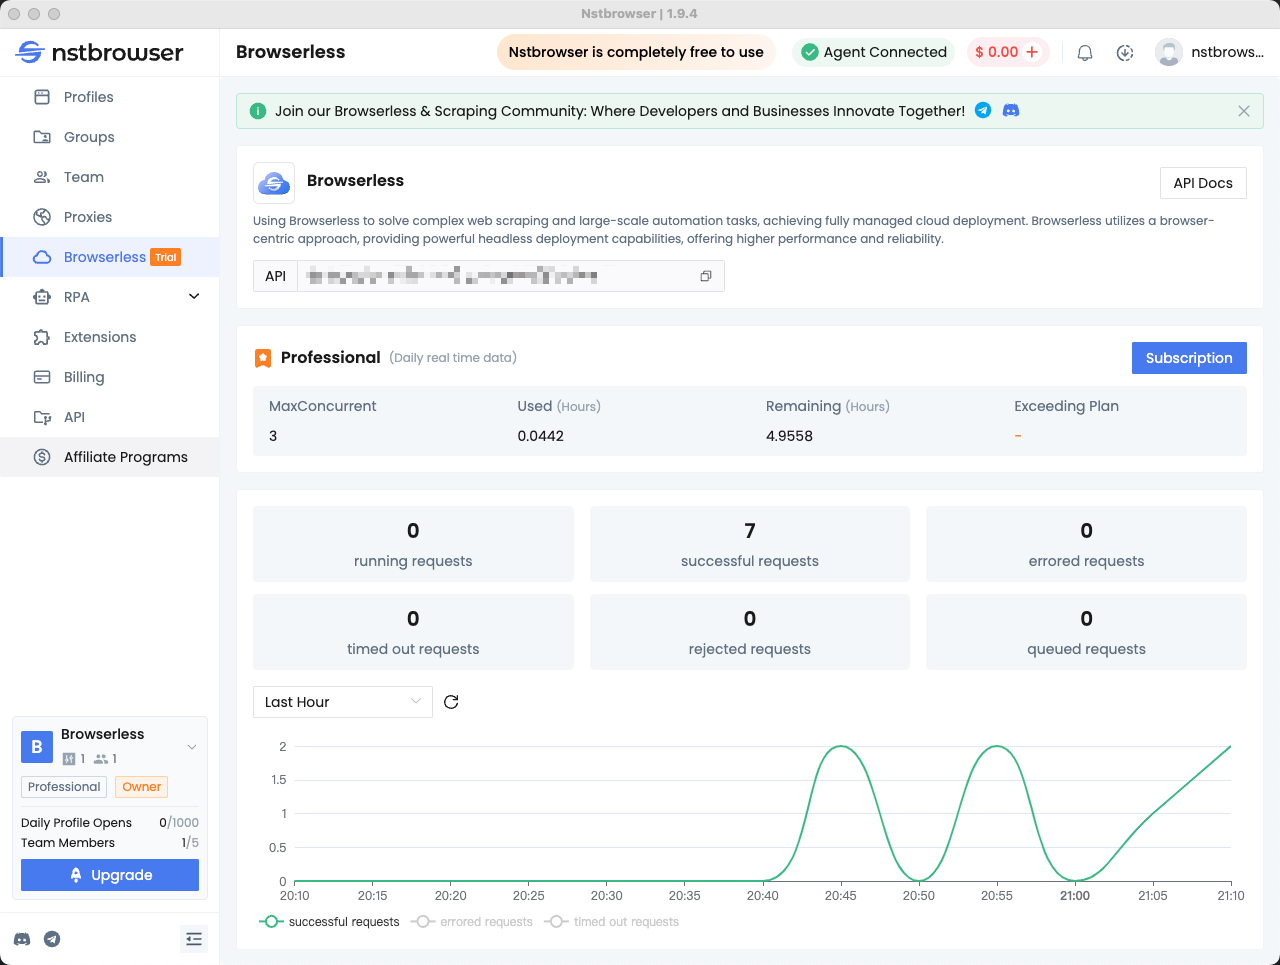
Bước 4: Xem bảng điều khiển Browserless
Bạn có thể xem tất cả số liệu thống kê cho các yêu cầu gần đây và thời gian phiên còn lại trong menu Browserless của Nstbrowser client.
5 Mẹo để bỏ qua việc chặn thu thập dữ liệu với Browserless?
Có một số điểm khác biệt chính giữa trình duyệt ẩn danh và trình duyệt thông thường. Dịch vụ chống bot phát hiện trình duyệt ẩn danh bằng cách phát hiện ra những điểm khác biệt này.
Bỏ qua việc chặn thu thập dữ liệu với Browserless liên quan đến một số chiến lược chính:
- Sử dụng trình duyệt ẩn danh: Browserless cho phép bạn chạy trình duyệt ẩn danh như Puppeteer, có thể bắt chước hành vi của người dùng thực và giảm thiểu rủi ro bị phát hiện.
- Xoay vòng User Agent: Ngẫu nhiên hóa User Agent có thể giúp tránh bị chặn bằng cách khiến các yêu cầu của bạn có vẻ đến từ các trình duyệt khác nhau.
- Triển khai xoay vòng Proxy: Sử dụng proxy xoay vòng để thay đổi địa chỉ IP thường xuyên, giảm thiểu khả năng bị chặn bởi các trang web mục tiêu.
- Điều tiết yêu cầu: Bắt chước hành vi duyệt web giống như con người bằng cách giới thiệu độ trễ giữa các yêu cầu, ngăn chặn các yêu cầu nhanh chóng kích hoạt các biện pháp bảo mật.
- Quản lý cookie và phiên: Xử lý cookie và dữ liệu phiên một cách chính xác để duy trì tính liên tục và tránh bị phát hiện, vì các phiên liên tục ít có khả năng bị gắn cờ.
Sự khác biệt giữa Browserless và trình duyệt ẩn danh là gì?
- Định nghĩa:
Browserless: Một dịch vụ hoặc nền tảng cung cấp tự động hóa trình duyệt dựa trên đám mây, cho phép người dùng chạy trình duyệt ẩn danh mà không cần quản lý cơ sở hạ tầng cơ bản.
Trình duyệt ẩn danh: Một trình duyệt web không có giao diện người dùng đồ họa (GUI) có thể chạy trong môi trường dòng lệnh, hữu ích cho việc tự động hóa các tác vụ web.
- Quản lý:
Browserless: Cung cấp các dịch vụ được quản lý, trừu tượng hóa sự phức tạp của việc thiết lập và duy trì các phiên bản trình duyệt. Người dùng tương tác với API để khởi tạo tác vụ.
Trình duyệt ẩn danh: Yêu cầu người dùng thiết lập và quản lý môi trường trình duyệt, bao gồm các phụ thuộc và cấu hình.
- Khả năng mở rộng:
Browserless: Được thiết kế để có thể mở rộng, cho phép người dùng dễ dàng chạy nhiều phiên bản trình duyệt song song, tận dụng tài nguyên đám mây.
Trình duyệt ẩn danh: Việc mở rộng quy mô có thể liên quan đến nhiều công việc thủ công hơn, chẳng hạn như quản lý nhiều phiên bản và tài nguyên máy chủ.
- Trường hợp sử dụng:
Browserless: Lý tưởng cho các nhà phát triển và nhóm cần tự động hóa có thể mở rộng cho thu thập dữ liệu web, kiểm tra và trích xuất dữ liệu mà không có vấn đề về cơ sở hạ tầng.
Trình duyệt ẩn danh: Thích hợp cho các nhà phát triển muốn kiểm soát trực tiếp các tác vụ tự động hóa của họ và thoải mái quản lý môi trường của riêng họ.
- Tích hợp:
Browserless: Thường cung cấp tích hợp với nhiều công cụ và dịch vụ khác nhau, giúp dễ dàng kết hợp vào các quy trình làm việc hiện có.
Trình duyệt ẩn danh: Yêu cầu nỗ lực tích hợp tùy chỉnh để kết nối với các công cụ hoặc dịch vụ khác.
Kết thúc
Cách thu thập dữ liệu web với browserless trên đám mây? Chúng tôi đã khám phá 4 bước chi tiết. Chỉ cần chọn thư viện yêu thích của bạn và sau đó thu thập dữ liệu bạn cần.
Ngoài ra, chúng tôi cũng đã học được rằng:
- Trình duyệt đám mây là gì?
- Lợi ích của Browserless
- 5 hiệu quả để tránh bị chặn
Bắt đầu sử dụng Browserless để đơn giản hóa mọi thứ!
Hơn