Browserless
Cách trích xuất kết quả hình ảnh Yandex bằng Playwright và Browserless?
Lấy dữ liệu từ tìm kiếm hình ảnh Yandex thực sự rất khó. Tuy nhiên, các bước và mã hiệu quả trong bài viết này sẽ giúp bạn dễ dàng thu thập nội dung.
Oct 24, 2024Tạ Quí Lĩnh
Yandex là gì?
Yandex là một công ty đa quốc gia có trụ sở tại Nga, nổi tiếng nhất với công cụ tìm kiếm của họ, là một trong những công cụ tìm kiếm lớn nhất ở nước này. Yandex cung cấp một loạt các dịch vụ ngoài khả năng tìm kiếm. Ngoài ra, Yandex cung cấp Yandex Image Search, cho phép bạn tìm kiếm ảnh bằng từ khóa.
Kết quả tìm kiếm hình ảnh của Yandex hơi khác so với Google và Bing. Tìm kiếm hình ảnh của Yandex cũng hỗ trợ nhiều bộ lọc, bao gồm kích thước, hướng, loại, màu sắc, định dạng, gần đây và hình nền.
Hàng ngàn ảnh có thể được thu thập cho nhiều mục đích, bao gồm tiếp thị, xây dựng thương hiệu, nghiên cứu, giảng dạy và sáng tạo.
Thu thập dữ liệu từ Yandex rất khó!
Yandex sử dụng các biện pháp chống bot nâng cao được thiết kế để phát hiện và chặn các yêu cầu tự động. Điều này bao gồm việc triển khai CAPTCHA và giới hạn tốc độ IP nghiêm ngặt, có thể cản trở nỗ lực thu thập dữ liệu.
Nhiều trang của Yandex có nội dung động được tải qua JavaScript. Điều này có nghĩa là các kỹ thuật thu thập dữ liệu đơn giản có thể không thu thập được tất cả thông tin liên quan, cần sử dụng các công cụ tinh vi hơn như trình duyệt headless.
Ngoài ra, Yandex thường xuyên cập nhật thuật toán và cấu trúc của các trang web của họ. Sự phát triển liên tục này có thể khiến các tập lệnh thu thập dữ liệu bị hỏng, yêu cầu bảo trì và điều chỉnh thường xuyên.
Có những cân nhắc pháp lý cần lưu ý, vì thu thập dữ liệu có thể vi phạm điều khoản dịch vụ của Yandex, có khả năng dẫn đến hậu quả pháp lý cho người dùng.
Lượng dữ liệu khổng lồ có sẵn trên Yandex có nghĩa là việc xử lý dữ liệu hiệu quả là điều cần thiết, thêm một lớp phức tạp vào quy trình thu thập dữ liệu.
Những yếu tố này kết hợp lại khiến việc thu thập dữ liệu từ Yandex trở thành một nỗ lực đầy thử thách, đòi hỏi lập kế hoạch và thực hiện cẩn thận.
Tại sao Browserless hoạt động tốt cho việc thu thập dữ liệu tìm kiếm hình ảnh của Yandex?
Browserless của Nstbrowser là một dịch vụ đám mây Headless Chrome điển hình hoạt động các ứng dụng trực tuyến và tự động hóa các tập lệnh mà không cần giao diện người dùng đồ họa. Nó đặc biệt hữu ích cho các tác vụ như thu thập dữ liệu web và các hoạt động tự động khác.
Nstbrowser tích hợp tính năng chống phát hiện, mở khóa web và browserless vào Browserless. Browserless hoàn toàn miễn phí để thử nghiệm. Tài liệu của chúng tôi tại đây đã được chuẩn bị để biết thêm chi tiết.
Bạn có bất kỳ ý tưởng tuyệt vời nào hoặc nghi ngờ về thu thập dữ liệu web và Browserless?
Hãy xem những gì các nhà phát triển khác đang chia sẻ trên Discord!
Cách thu thập dữ liệu kết quả tìm kiếm hình ảnh của Yandex?
Thiết lập môi trường
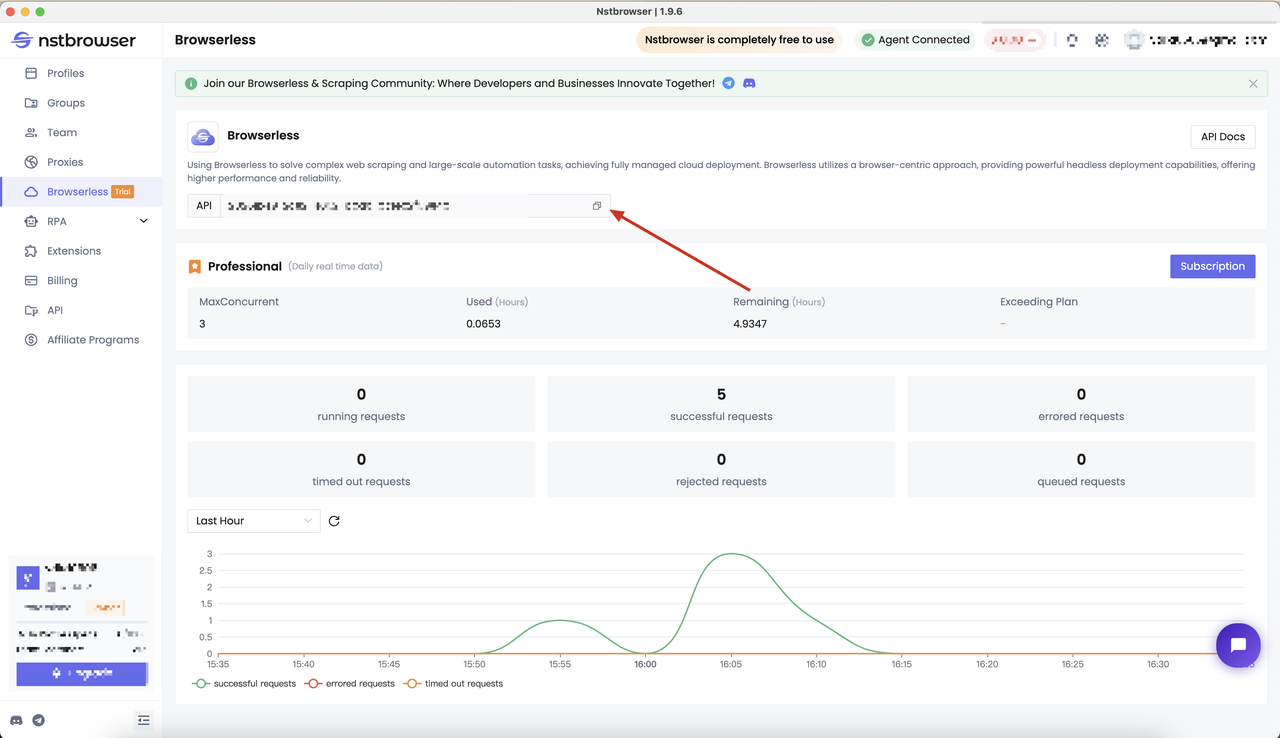
Ngay từ đầu, chúng ta nên chuẩn bị dịch vụ Browserless của mình. Browserless có thể giúp giải quyết các tác vụ thu thập dữ liệu web phức tạp và tự động hóa quy mô lớn, và việc triển khai đám mây được quản lý đầy đủ đã được thực hiện.
- Browserless sử dụng phương pháp tập trung vào trình duyệt, cung cấp các tính năng triển khai headless mạnh mẽ và cung cấp độ tin cậy và tốc độ được cải thiện. Kiểm tra tài liệu về Browserless của chúng tôi để biết thêm chi tiết.
- Truy cập trang menu Browserless của khách hàng Nstbrowser để lấy API KEY, hoặc bạn có thể lấy trực tiếp thông qua liên kết chuyển tiếp tại đây.
Xác định mục tiêu thu thập dữ liệu
Giống như trước đây, hãy theo dõi chúng tôi để xác định mục tiêu thu thập dữ liệu trước tiên.
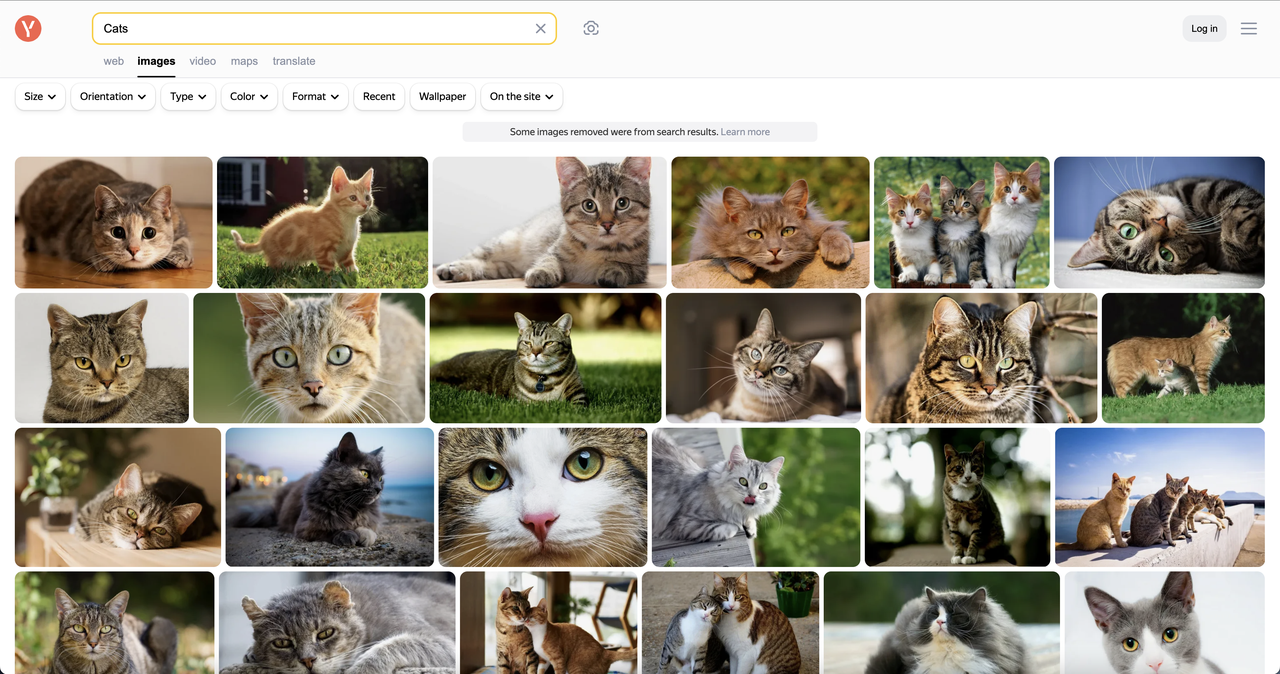
Hãy sử dụng Playwright và kết hợp nó với dịch vụ Browserless của Nstbrowser để thu thập dữ liệu các hình ảnh hàng đầu khi tìm kiếm từ khóa "cat".
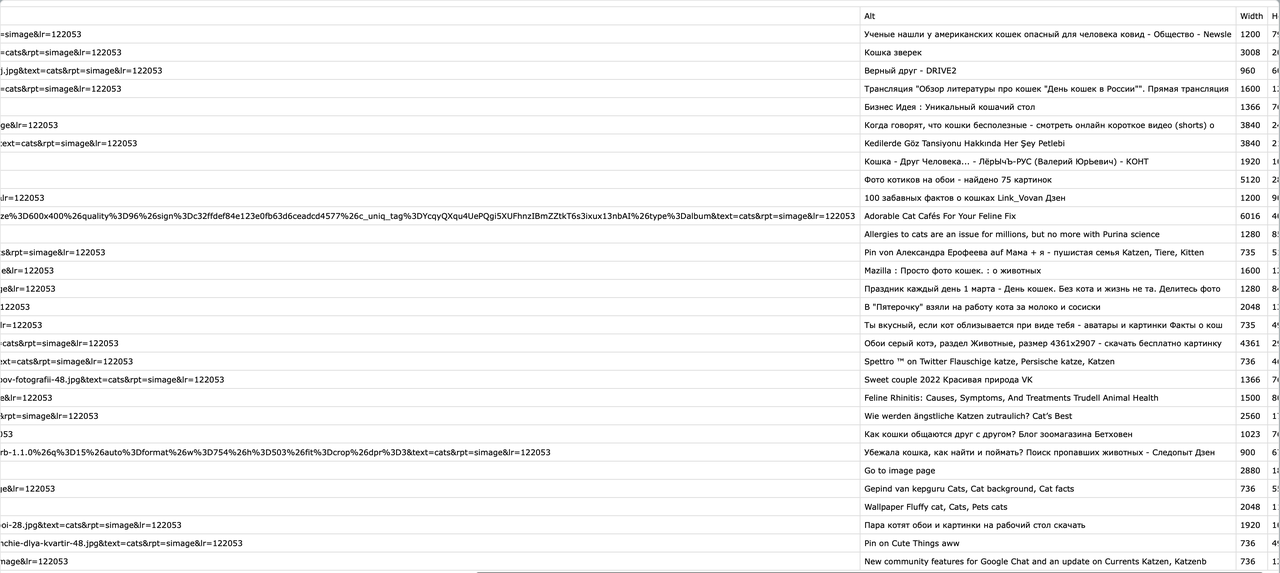
Dữ liệu chúng ta cần bao gồm: "địa chỉ hình ảnh", "tóm tắt hình ảnh", "chiều rộng hình ảnh" và "chiều cao hình ảnh", và lưu kết quả vào một tệp CSV.
Bắt đầu thu thập dữ liệu bằng cách sử dụng dịch vụ Browserless của Nstbrowser
Làm theo các bước dưới đây để tạo dự án và bắt đầu thu thập dữ liệu:
Bước 1. Tạo một tệp main.py và một dự án Python mới.
Bước 2. Sử dụng Browserless của Nstbrowser để tạo một phiên bản trình duyệt.
Python
from playwright.sync_api import sync_playwright

token = "You API token" # required
config = {
    "proxy": "", # required; input format: schema://user:password@host:port eg: http://user:password@localhost:8080
    # "platform": "windows",  # support: windows, mac, linux
    # "kernel": "chromium",  # only support: chromium
    # "kernelMilestone": "124",  # support: 113, 120, 124
    # "args": {
    #     "--proxy-bypass-list": "detect.nstbrowser.io"
    # },  # browser args
    # "fingerprint": {
    #     "userAgent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36",
    # },
}

query = urlencode({
    "token": token,
    "config": json.dumps(config)
})

browser_ws_endpoint = f"ws://less.nstbrowser.io/connect?{query}"

def get_browser():
    playwright = sync_playwright().start()
    return playwright.chromium.connect_over_cdp(browser_ws_endpoint)
Bước 3. Thu thập dữ liệu hình ảnh và làm sạch dữ liệu
- Xác định địa chỉ URL của trang web thu thập dữ liệu:
Python
target_website_url = "https://yandex.com/images/search?family=yes&from=tabbar&text=cats"- Ở đây, Playwright sử dụng phương thức
page.gotođể giúp mở trang web mục tiêu.
Bước này là để đảm bảo rằng trình duyệt có thể tải trang web một cách chính xác và chờ cho nội dung DOM của trang web được tải đầy đủ.
Python
page.goto(url, timeout=60000, wait_until="domcontentloaded")- Tiếp theo, chúng ta cần tìm tất cả các phần tử có thuộc tính
data-statetrên trang và cố gắng tìm phần tử mục tiêu (phần tử chứa dữ liệu hình ảnh).
Bước này sử dụng phương thức query_selector_all để lấy các phần tử này và xác định vị trí của phần tử chứa thông tin hình ảnh thông qua get_attribute("id") và get_attribute("data-state").
Python
data_states = page.query_selector_all("[data-state]")
images_app = None
for data_state in data_states:
    if "ImagesApp" in data_state.get_attribute("id"):
        images_app = data_state.get_attribute("data-state")
break- Sau khi nhận được phần tử mục tiêu, mã gọi hàm
get_image_results.
Hàm này phân tích dữ liệu JSON trong thuộc tính data-state của phần tử mục tiêu và trích xuất thông tin hình ảnh.
Python
def get_image_results(images_app):
    images_app_obj = json.loads(images_app)
    images_lists = images_app_obj['initialState']["serpList"]["items"]["entities"]
    imgs = []
    for key in images_lists:
        img = images_lists[key]
        imgs.append({
            "url": img["url"],
            "alt": img["alt"],
            "width": img["width"],
            "height": img["height"],
        })

    return imgs
Bước 4. Lưu kết quả thu thập dữ liệu và xuất ra tệp CSV
Trước khi lưu dữ liệu, bạn cần xác định tiêu đề của tệp CSV. Bốn trường được xác định ở đây: URL, Alt, Width và Height. Các trường này đại diện cho các thuộc tính cơ bản của mỗi hình ảnh. Sử dụng hàm open() để mở một tệp có tên yandex_images.csv ở chế độ ghi ('w'). Đồng thời, định dạng mã hóa được chỉ định là UTF-8 và newline='' được đặt để tránh các dòng trống khi ghi.
Python
def save_csv(data):
    try:
        header = ["URL", "Alt", "Width", "Height"]
        with open('yandex_images.csv', 'w', encoding='UTF8', newline='') as f:
            writer = csv.writer(f)
            writer.writerow(header)
            for item in data:
                writer.writerow(
                    [
                        item["url"],
                        item["alt"],
                        item["width"],
                        item["height"],
                    ])
        print("Saved to yandex_images.csv")
    except Exception as e:
        print(e)
Toàn bộ dòng mã
Python
import json
import csv
from urllib.parse import urlencode

from playwright.sync_api import sync_playwright

token = ""  # required
config = {
    "proxy": "", # required; input format: schema://user:password@host:port eg: http://user:password@localhost:8080
    # "platform": "windows",  # support: windows, mac, linux
    # "kernel": "chromium",  # only support: chromium
    # "kernelMilestone": "124",  # support: 113, 120, 124
    # "args": {
    #     "--proxy-bypass-list": "detect.nstbrowser.io"
    # },  # browser args
    # "fingerprint": {
    #     "userAgent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36",
    # },
}

query = urlencode({
    "token": token,
    "config": json.dumps(config)
})

browser_ws_endpoint = f"ws://less.nstbrowser.io/connect?{query}"
target_website_url = "https://yandex.com/images/search?family=yes&from=tabbar&text=cats"


def get_browser():
    playwright = sync_playwright().start()
    return playwright.chromium.connect_over_cdp(browser_ws_endpoint)


def get_image_results(images_app):
    try:
        images_app_obj = json.loads(images_app)
        images_lists = images_app_obj['initialState']["serpList"]["items"]["entities"]
        imgs = []
        for key in images_lists:
            img = images_lists[key]
            imgs.append({
                "url": img["url"],
                "alt": img["alt"],
                "width": img["width"],
                "height": img["height"],
            })

        return imgs

    except Exception as e:
        print(e)


def get_tar(url, page):
    try:
        print("Open page: " + url)
        page.goto(url, timeout=60000, wait_until="domcontentloaded")
        data_states = page.query_selector_all("[data-state]")
        images_app = None
        results = []
        for data_state in data_states:
            if "ImagesApp" in data_state.get_attribute("id"):
                images_app = data_state.get_attribute("data-state")
                break

        if images_app is None:
            print("Cannot find the target element")
        else:
            print("Found the target element")
            results = get_image_results(images_app)

        return results
    except Exception as e:
        print(e)


def save_csv(data):
    try:
        header = ["URL", "Alt", "Width", "Height"]
        with open('yandex_images.csv', 'w', encoding='UTF8', newline='') as f:
            writer = csv.writer(f)
            writer.writerow(header)
            for item in data:
                writer.writerow(
                    [
                        item["url"],
                        item["alt"],
                        item["width"],
                        item["height"],
                    ])
        print("Saved to yandex_images.csv")
    except Exception as e:
        print(e)


def main():
    try:
        with get_browser() as browser:
            page = browser.new_page()
            res = get_tar(target_website_url, page)
            if len(res) == 0:
                print("No results")
            else:
                save_csv(res)
            browser.close()
    except Exception as e:
        print(e)


if __name__ == "__main__":
    main()
Kết quả thu thập dữ liệu
Kết luận
Thu thập dữ liệu tìm kiếm hình ảnh của Yandex là khó khăn, như mọi người đều biết. Tuy nhiên, bạn có thể dễ dàng thu thập dữ liệu kết quả tìm kiếm của Yandex cho bất kỳ thuật ngữ nào được chọn và xuất dữ liệu đó vào các tệp CSV hoặc JSON nếu bạn làm theo hướng dẫn thu thập dữ liệu trong bài đăng này và sử dụng mã Python được cung cấp.
Bạn có thể dễ dàng thu thập dữ liệu Yandex SERP ở quy mô lớn với Nstbrowser và Browserless. Bây giờ, sử dụng Browserless là hoàn toàn miễn phí. Đừng bỏ lỡ cơ hội tuyệt vời này!
Hãy liên hệ với chúng tôi nếu bạn cần một giải pháp mạnh mẽ hơn.
Lưu ý: Bất kỳ dữ liệu và trang web nào được đề cập trong bài viết này chỉ nhằm mục đích minh họa. Chúng tôi phản đối mạnh mẽ các hoạt động bất hợp pháp và vi phạm. Nếu bạn có bất kỳ câu hỏi hoặc thắc mắc nào, vui lòng liên hệ với chúng tôi ngay lập tức.
Hơn