Browserless
Cách Scraping Trang Web Động Sử Dụng Browserless?
Lấy dữ liệu từ các trang web động thực sự khó! Làm sao để hoàn thành nó một cách dễ dàng? Tìm hiểu cách tốt nhất trong hướng dẫn này.
Oct 18, 2024Triệu Lệ Chi
Trang web động là gì?
Trang web động là trang web mà nội dung không được nhúng trực tiếp vào HTML tĩnh mà được tạo ra thông qua kết xuất phía máy chủ hoặc phía máy khách.
Nó có thể hiển thị dữ liệu theo thời gian thực dựa trên hành động của người dùng, chẳng hạn như tải thêm nội dung khi người dùng nhấp vào nút hoặc cuộn xuống trang (như cuộn vô hạn). Thiết kế này cải thiện trải nghiệm của người dùng và cho phép người dùng nhận được thông tin liên quan mà không cần tải lại toàn bộ trang.
Để xác định xem một trang web có phải là trang web động hay không, bạn có thể vô hiệu hóa JavaScript trong trình duyệt của mình. Nếu trang web là động, hầu hết nội dung sẽ biến mất.
Thách thức khi trích xuất dữ liệu từ trang web động
Nhận dạng dấu vân tay và chặn
-
Kỹ thuật nhận dạng dấu vân tay: Nhiều trang web sử dụng kỹ thuật nhận dạng dấu vân tay để phát hiện và chặn các trình trích xuất dữ liệu tự động. Những kỹ thuật này tạo ra một "dấu vân tay" duy nhất cho mỗi khách truy cập bằng cách phân tích thông tin như hành vi trình duyệt, độ phân giải màn hình, plugin, múi giờ, v.v. Nếu phát hiện bất thường hoặc không phù hợp với hành vi của người dùng bình thường, trang web có thể chặn quyền truy cập.
-
Cơ chế chặn: Để bảo vệ nội dung của mình, các trang web triển khai nhiều cơ chế chặn khác nhau, chẳng hạn như:
- Chặn IP: Khi có yêu cầu thường xuyên từ cùng một địa chỉ IP, trang web có thể tạm thời hoặc vĩnh viễn cấm truy cập từ địa chỉ IP đó.
- Xác minh CAPTCHA: Các trang web có thể giới thiệu CAPTCHA khi phát hiện lưu lượng truy cập tự động để xác nhận rằng khách truy cập là người thật.
- Giới hạn lưu lượng truy cập: Đặt giới hạn tốc độ yêu cầu, và khi tốc độ yêu cầu vượt quá ngưỡng đã đặt, trang web sẽ từ chối các yêu cầu tiếp theo.
Thách thức tải cục bộ
- Tiêu thụ tài nguyên: Các trang động thường yêu cầu nhiều tài nguyên hệ thống hơn để kết xuất và thu thập dữ liệu. Khi sử dụng các công cụ như Puppeteer hoặc Selenium, nó có thể gây ra mức sử dụng bộ nhớ và CPU cao, đặc biệt là khi thu thập dữ liệu từ nhiều trang.
- Độ trễ và chi phí thời gian: Do cần chờ trang tải đầy đủ (bao gồm thực thi JavaScript và yêu cầu AJAX), chi phí thời gian thu thập dữ liệu từ các trang động có thể cao, điều này sẽ ảnh hưởng đến hiệu quả của toàn bộ trình thu thập dữ liệu.
- Xử lý đồng thời: Trong điều kiện tải cao, việc xử lý nhiều tác vụ thu thập dữ liệu cùng một lúc có thể gây quá tải hệ thống, dẫn đến lỗi yêu cầu hoặc hết thời gian chờ. Điều này yêu cầu chiến lược lập lịch tác vụ và quản lý tài nguyên hợp lý.
Bạn có ý tưởng tuyệt vời nào hoặc nghi ngờ gì về việc trích xuất dữ liệu web và Browserless?
Hãy xem những gì các nhà phát triển khác đang chia sẻ trên Discord và Telegram!
6 cách hiệu quả để trích xuất dữ liệu từ trang web động
1. Chặn yêu cầu XHR/Fetch
Một phương pháp hiệu quả để chặn các yêu cầu XHR (XMLHttpRequest) và Fetch trong quá trình trích xuất dữ liệu là kiểm tra tab Network của trình duyệt để xác định các điểm cuối API cung cấp nội dung động. Sau khi xác định được các điểm cuối này, có thể sử dụng các máy khách HTTP như thư viện Requests để gửi yêu cầu trực tiếp đến các API này để lấy dữ liệu.
- Ưu điểm: Phương pháp này thường nhanh và có thể trích xuất dữ liệu hiệu quả vì nó chỉ thu thập nội dung cần thiết thay vì toàn bộ trang web.
- Nhược điểm: Điều này có thể gây khó khăn nếu dữ liệu được lưu trữ trong DOM dưới dạng JSON thay vì được trả về bởi API. Ngoài ra, quá trình mô phỏng các yêu cầu API có thể bị ảnh hưởng bởi thay đổi API, giới hạn tốc độ và yêu cầu xác thực, dẫn đến khả năng mở rộng kém.
2. Sử dụng trình duyệt headless
Sử dụng trình duyệt headless như Puppeteer hoặc Selenium cho phép mô phỏng đầy đủ hành vi của người dùng, bao gồm tải trang và tương tác. Những công cụ này có thể xử lý JavaScript và trích xuất nội dung được tạo động.
- Ưu điểm: Phương pháp này có thể trích xuất dữ liệu từ các trang web động cao và hỗ trợ các tương tác người dùng phức tạp.
- Nhược điểm: Tiêu thụ tài nguyên cao, tốc độ thu thập dữ liệu chậm và có thể cần phải xử lý các cấu trúc trang phức tạp và nội dung động.
3. Yêu cầu API
Yêu cầu dữ liệu trực tiếp từ API của trang web là một cách hiệu quả để thu thập dữ liệu. Phân tích các yêu cầu mạng của trang web, tìm điểm cuối API và sử dụng máy khách HTTP để yêu cầu dữ liệu.
- Ưu điểm: Khả năng lấy trực tiếp dữ liệu cần thiết và tránh sự phức tạp của việc phân tích HTML.
- Nhược điểm: Nếu API yêu cầu xác thực hoặc có giới hạn tần suất yêu cầu, nó có thể ảnh hưởng đến hiệu quả thu thập dữ liệu.
4. Thu thập dữ liệu từ các yêu cầu AJAX
Bằng cách theo dõi các yêu cầu mạng, xác định các cuộc gọi AJAX và tái tạo chúng, có thể trích xuất dữ liệu được tải động.
- Ưu điểm: Lấy trực tiếp nguồn dữ liệu và giảm tải không cần thiết.
- Nhược điểm: Cần phải có một số hiểu biết về các tham số và định dạng của các yêu cầu AJAX, và cũng có thể gặp phải các vấn đề xác thực và giới hạn tốc độ.
5. Proxy và luân phiên IP
Để tránh bị chặn bởi trang web, việc sử dụng dịch vụ proxy và luân phiên IP là một chiến lược quan trọng. Điều này có thể giúp phân tán các yêu cầu và giảm nguy cơ bị phát hiện.
- Ưu điểm: Giảm xác suất bị chặn và có thể duy trì hiệu quả trong một số lượng lớn yêu cầu.
- Nhược điểm: Việc sử dụng dịch vụ proxy có thể làm tăng chi phí thu thập dữ liệu và yêu cầu duy trì danh sách proxy.
6. Mô phỏng hành vi của người dùng
Viết các kịch bản để mô phỏng hành vi duyệt web của con người, chẳng hạn như thêm độ trễ giữa các yêu cầu, ngẫu nhiên hóa thứ tự các thao tác, v.v., có thể giúp giảm nguy cơ bị xác định là trình thu thập dữ liệu bởi trang web.
- Ưu điểm: Thu thập dữ liệu có thể được thực hiện tự nhiên hơn, giảm nguy cơ bị phát hiện.
- Nhược điểm: Việc triển khai tương đối phức tạp, và mất thời gian để điều chỉnh và tối ưu hóa hành vi mô phỏng.
Browserless là gì?
Browserless là một dịch vụ headlesschrome đám mây hoạt động các ứng dụng trực tuyến và tự động hóa các kịch bản mà không có giao diện người dùng đồ họa. Đối với các công việc như trích xuất dữ liệu web và các hoạt động tự động khác, nó đặc biệt hữu ích.
Browserless giúp trích xuất dữ liệu từ trang web động dễ dàng
Browserless cũng là một trình duyệt headless mạnh mẽ. Tiếp theo, chúng ta sẽ sử dụng Browserless làm ví dụ để thu thập dữ liệu từ các trang web động.
Điều kiện tiên quyết
Trước khi chúng ta bắt đầu, chúng ta cần phải có một dịch vụ Browserless. Sử dụng Browserless có thể giải quyết các tác vụ thu thập dữ liệu web phức tạp và tự động hóa quy mô lớn, và hiện tại đã đạt được triển khai đám mây được quản lý đầy đủ.
Browserless sử dụng chiến lược tập trung vào trình duyệt, cung cấp khả năng triển khai headless mạnh mẽ và cung cấp hiệu suất và độ tin cậy cao hơn. Bạn có thể nhấp vào đây để tìm hiểu thêm về cấu hình dịch vụ Browserless.
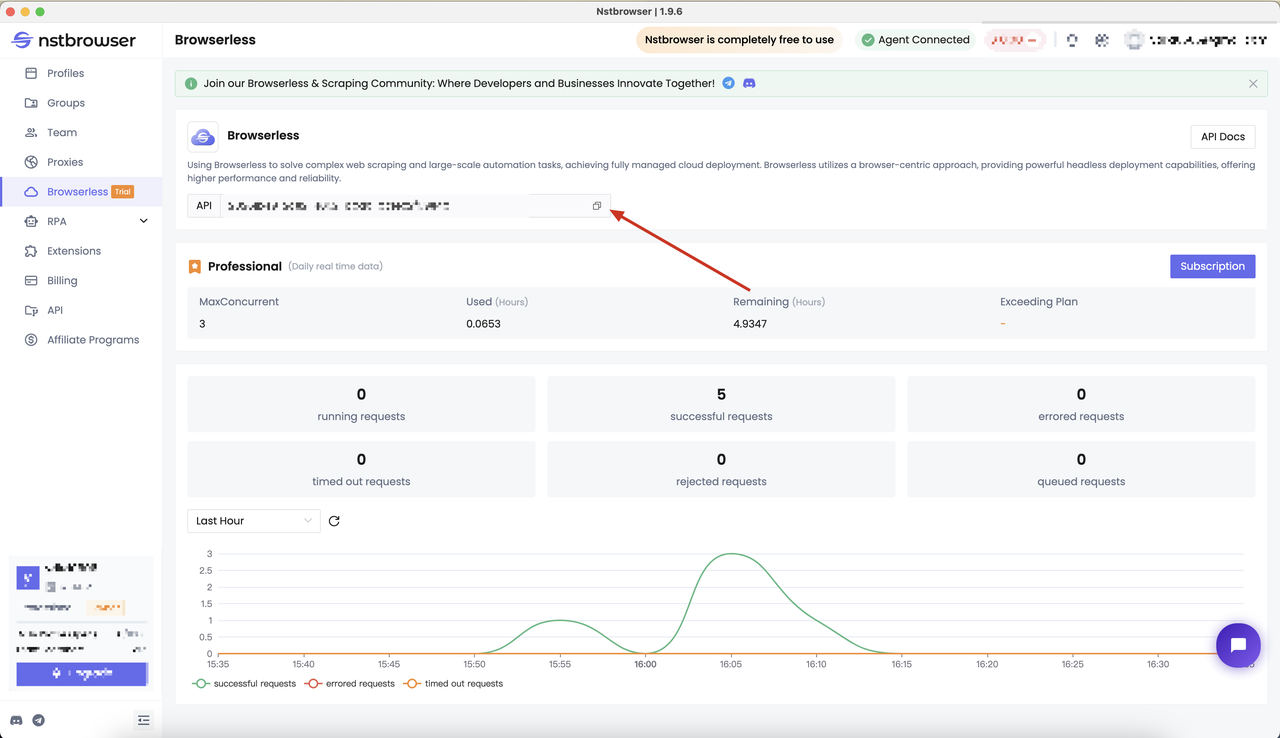
Ngay từ đầu, chúng ta cần lấy API KEY của Nstbrowser. Bạn có thể truy cập trang menu Browserless của khách hàng Nstbrowser, hoặc bạn có thể nhấp vào đây để truy cập.
Xác định mục tiêu thu thập dữ liệu
Trước khi chúng ta bắt đầu, hãy xác định mục tiêu của thử nghiệm này. Chúng ta sẽ sử dụng Puppeteer và Playwright để lấy nội dung tiêu đề trang của các trang web động:
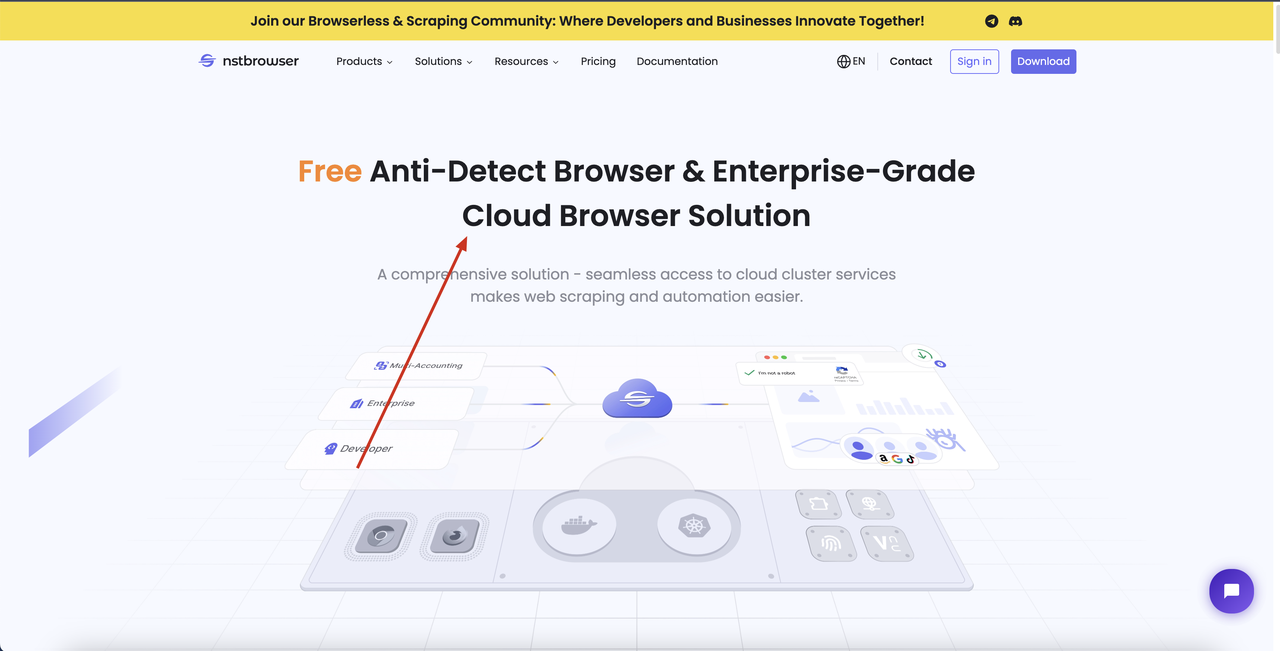
- Truy cập trang web mục tiêu: https://www.nstbrowser.io/en
- Lấy nội dung tiêu đề trang động
Khởi tạo dự án
Làm theo các bước bên dưới để cài đặt các phụ thuộc:
- Bước 1: Tạo một thư mục mới trong Vs code
- Bước 2: Mở terminal Vs code và chạy các lệnh sau để cài đặt các phụ thuộc liên quan
SQL
npm init -y
pnpm add playwright puppeteer-core
Thu thập dữ liệu từ trang web động bằng Playwright và Browserless
- Tạo một kịch bản thu thập dữ liệu
TypeScript
const { chromium } = require('playwright');

async function createBrowser() {
  const token = ''; // bắt buộc
  const config = {
    proxy:
      '', // bắt buộc; định dạng đầu vào: schema://user:password@host:port ví dụ: http://user:password@localhost:8080
    // platform: 'windows', // hỗ trợ: windows, mac, linux
    // kernel: 'chromium', // chỉ hỗ trợ: chromium
    // kernelMilestone: '124', // hỗ trợ: 113, 120, 124
    // args: {
    //   '--proxy-bypass-list': 'detect.nstbrowser.io',
    // }, // đối số trình duyệt
    // fingerprint: {
    //   userAgent:
    //     'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36',
    // },
  };
  const query = new URLSearchParams({
    token: token, // bắt buộc
    config: JSON.stringify(config),
  });

  const browserWSEndpoint = `ws://less.nstbrowser.io/connect?${query.toString()}`;
  const browser = await chromium.connectOverCDP(browserWSEndpoint);
  const context = await browser.newContext();
  const page = await context.newPage();

  page.goto('https://www.nstbrowser.io/en');

  // ngủ trong 5 giây
  await new Promise((resolve) => setTimeout(resolve, 5000));

  const h1Element = await page.$('h1');
  const content = await h1Element?.textContent();
  console.log(`Playwright: Nội dung của phần tử h1 là: ${content}`)

  await page.close();
  await page.context().close();
}

createBrowser().then();- Kiểm tra kết quả thu thập dữ liệu

Thu thập dữ liệu từ trang web động bằng Puppeteer và Browserless
- Tạo một kịch bản thu thập dữ liệu
TypeScript
const puppeteer = require('puppeteer-core');

async function createBrowser() {
  const token = ''; // bắt buộc
  const config = {
    proxy:
      '', // bắt buộc; định dạng đầu vào: schema://user:password@host:port ví dụ: http://user:password@localhost:8080
    // platform: 'windows', // hỗ trợ: windows, mac, linux
    // kernel: 'chromium', // chỉ hỗ trợ: chromium
    // kernelMilestone: '124', // hỗ trợ: 113, 120, 124
    // args: {
    //   '--proxy-bypass-list': 'detect.nstbrowser.io',
    // }, // đối số trình duyệt
    // fingerprint: {
    //   userAgent:
    //     'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36',
    // },
  };
  const query = new URLSearchParams({
    token: token, // bắt buộc
    config: JSON.stringify(config),
  });

  const browserWSEndpoint = `ws://less.nstbrowser.io/connect?${query.toString()}`;
  const browser = await puppeteer.connect({
    browserWSEndpoint: browserWSEndpoint,
    defaultViewport: null,
  });
  const page = await browser.newPage();

  await page.goto('https://www.nstbrowser.io/en');

  // ngủ trong 5 giây
  await new Promise((resolve) => setTimeout(resolve, 5000));

  const h1Element = await page.$('h1');

  if (h1Element) {
    const content = await page.evaluate((el) => el.textContent, h1Element); // sử dụng page.evaluate để lấy nội dung văn bản của phần tử h1
    console.log(`Puppeteer: Nội dung của phần tử h1 là: ${content}`);
  } else {
    console.log('Không tìm thấy phần tử h1.');
  }

  await page.close();
}

createBrowser().then();- Kiểm tra kết quả thu thập dữ liệu

Kết luận
Thu thập dữ liệu từ trang web động luôn phức tạp hơn so với thu thập dữ liệu từ trang web thông thường. Rất dễ gặp phải nhiều vấn đề trong quá trình thu thập dữ liệu. Qua phần giới thiệu của bài viết này, bạn chắc chắn đã học được:
- 6 cách hiệu quả để thu thập dữ liệu từ trang web động
- Sử dụng Browserless để dễ dàng thu thập dữ liệu từ trang web động
Hơn