Browserless
Cách sử dụng Browserless với Ubuntu 22.04?
Ubuntu 22.04 là một hệ thống mạnh mẽ cho mọi nhà phát triển! Nó hoạt động với Browserless như thế nào? Tất cả chi tiết bạn sẽ tìm thấy trong blog tuyệt vời này.
Sep 26, 2024Tạ Quí Lĩnh
Ubuntu 22.04 là một hệ điều hành Linux dựa trên Debian, là phiên bản hỗ trợ dài hạn (LTS), cung cấp năm năm hỗ trợ chính thức và cập nhật bảo mật.
Nó sử dụng môi trường desktop GNOME hiện đại, tối ưu hóa hiệu suất và độ ổn định, đồng thời chứa các gói và công cụ mới nhất để hỗ trợ phần cứng mới. Ngoài ra, Ubuntu 22.04 tăng cường bảo mật và cung cấp các cài đặt bảo mật mặc định nghiêm ngặt hơn và bảo vệ quyền riêng tư.
Ubuntu 22.04 có còn được hỗ trợ không?
Có!
Ubuntu 22.04 có tên mã là Jammy Jellyfish. Nó được phát hành vào ngày 21 tháng 4 năm 2022 và là bản phát hành hỗ trợ dài hạn, được hỗ trợ trong năm năm, cho đến tháng 4 năm 2027.
Browserless là gì?
Browserless là một giải pháp trình duyệt mạnh mẽ. Được dựa trên các cụm đám mây, Browserless được thiết kế để tạo điều kiện thuận lợi cho các tác vụ tự động hóa trình duyệt phức tạp, thu thập dữ liệu web và thử nghiệm theo cách có thể mở rộng và hiệu quả. Nó được xây dựng dựa trên thư viện dấu vân tay toàn diện của Nstbrowser và cung cấp chuyển đổi dấu vân tay ngẫu nhiên để đáp ứng nhu cầu của người dùng về thu thập dữ liệu và các tác vụ tự động hóa.
Bạn có ý tưởng tuyệt vời và nghi ngờ nào về web scraping và Browserless?
Hãy xem những gì các nhà phát triển khác đang chia sẻ trên Discord và Telegram!
Cách sử dụng Browserless trên Ubuntu 22.04?
Điều kiện tiên quyết
Trước khi sử dụng Browserless, bạn cần cấu hình NodeJS trước.
Ubuntu 22.04 đi kèm với gói Node.js. Mặc dù phiên bản mặc định có thể không phải là phiên bản mới nhất, nhưng nó đủ để đáp ứng nhu cầu phát triển cơ bản. Chúng ta sử dụng apt để cài đặt nó, đây là một cách đơn giản.
Bước 1. Cập nhật chỉ mục gói cục bộ.
Trước khi cài đặt Node.js, hãy cập nhật chỉ mục gói cục bộ:
Shell
sudo apt updateBước 2. Cài đặt Node.js.
Cài đặt Node.js bằng trình quản lý gói apt:
Shell
sudo apt install nodejs -yBước 3. Cài đặt trình quản lý gói node.
npm được sử dụng để quản lý các mô-đun và gói Node.js
Shell
sudo apt install npm -yBước 4. Xác minh rằng Node.js và npm được cài đặt thành công.
Sau khi cài đặt hoàn tất, bạn có thể kiểm tra phiên bản Node.js đã cài đặt bằng lệnh sau:
Shell
node -v
npm -v
Nếu đầu ra hiển thị thông tin phiên bản, điều đó có nghĩa là cài đặt thành công.
Sử dụng Browserless
Bước 1. Xây dựng dự án
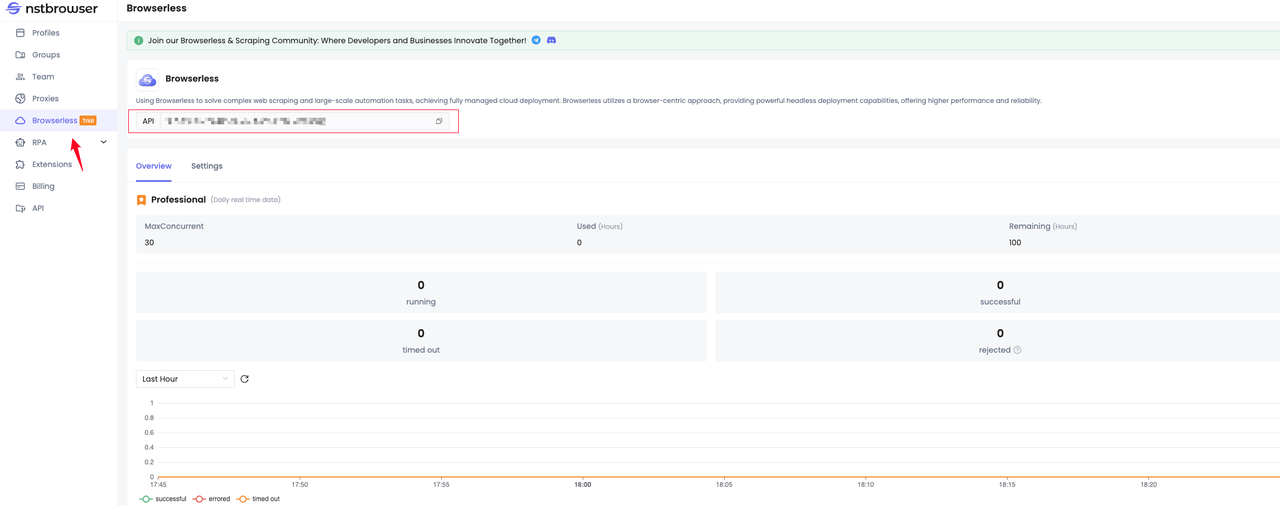
- Theo Tài liệu API browserless của Nstbrowser, đầu tiên, chúng ta cần lấy API Key:
- Tiếp theo, hãy tạo một dự án node
Bash
mkdir nst-browserless && cd nst-browserless
npm init -y- Sau đó, chỉ cần chọn IDE bất kỳ bạn thích. Chúng ta sử dụng VisualStudio ở đây:
Bash
code .Hiện tại, Browserless chỉ hỗ trợ Puppeteer và Playwright. Trong hướng dẫn này, chúng ta chọn sử dụng puppeteer. Tiếp theo, đã đến lúc cài đặt các phụ thuộc:
Bash
npm i --save puppeteer-coreCho đến nay, chúng ta đã hoàn thành việc xây dựng dự án.
Bước 2. Mã hóa
Truy cập Browserless
Đầu tiên, hãy viết một quy trình đơn giản để xác minh xem Browserless có thể được truy cập bình thường hay không:
JavaScript
import puppeteer from "puppeteer-core";

const token = "your token"; // required
const config = {
    proxy: 'your proxy', // required
};
const query = new URLSearchParams({
    token: token, // required
    config: JSON.stringify(config),
});
const browserWSEndpoint = `https://less.nstbrowser.io/connect?${query.toString()}`;

const getBrowser = async () => puppeteer.connect({
    browserWSEndpoint,
    defaultViewport: null,
});

(async () => {
    let browser = null;
    await getBrowser()
        .then(async (browser) => {
            const page = await browser.newPage();
            await page.goto("https://nstbrowser.io");
            await page.screenshot({ path: "screenshot.png", fullPage: true });
            await page.close();
            await browser.close();
        })
        .catch((error) => {
            console.log(error);
        })
        .finally(() => browser?.close());
})()
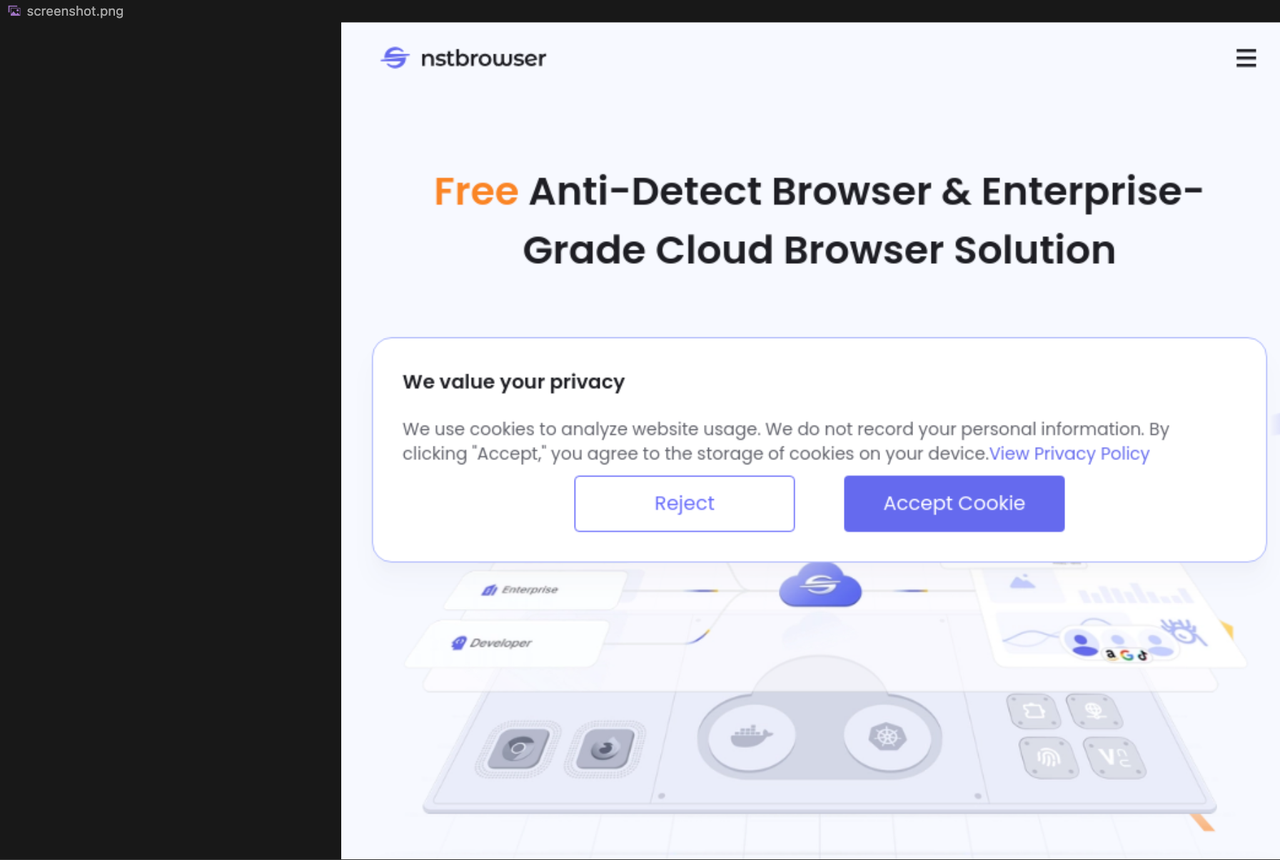
Khả năng tạo ảnh chụp màn hình cho thấy chúng ta có thể sử dụng Browserless bình thường:
Scraping hình ảnh
Tiếp theo, chúng ta truy cập trang web Pixels để thu thập một số hình ảnh:
- nhập trang phụ từ điều hướng danh mục Wall Art ở đầu trang chủ
- lấy sáu địa chỉ hình ảnh đầu tiên và in kết quả.
- Phân tích trang web
Tìm liên kết menu điều hướng:
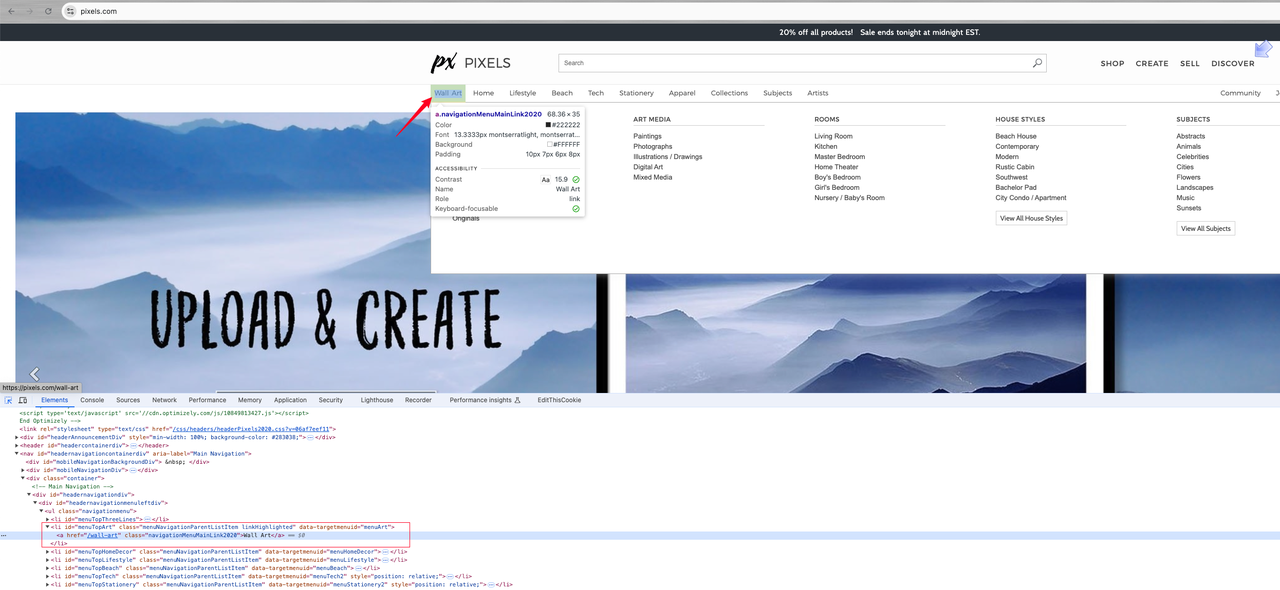
Sau khi phân tích, chúng ta có thể thấy rằng liên kết chúng ta cần nhấp vào là một thẻ a nằm dưới phần tử li có id menuTopArt. Tiếp theo, hãy phân tích thêm phần tử cần thu thập dữ liệu:
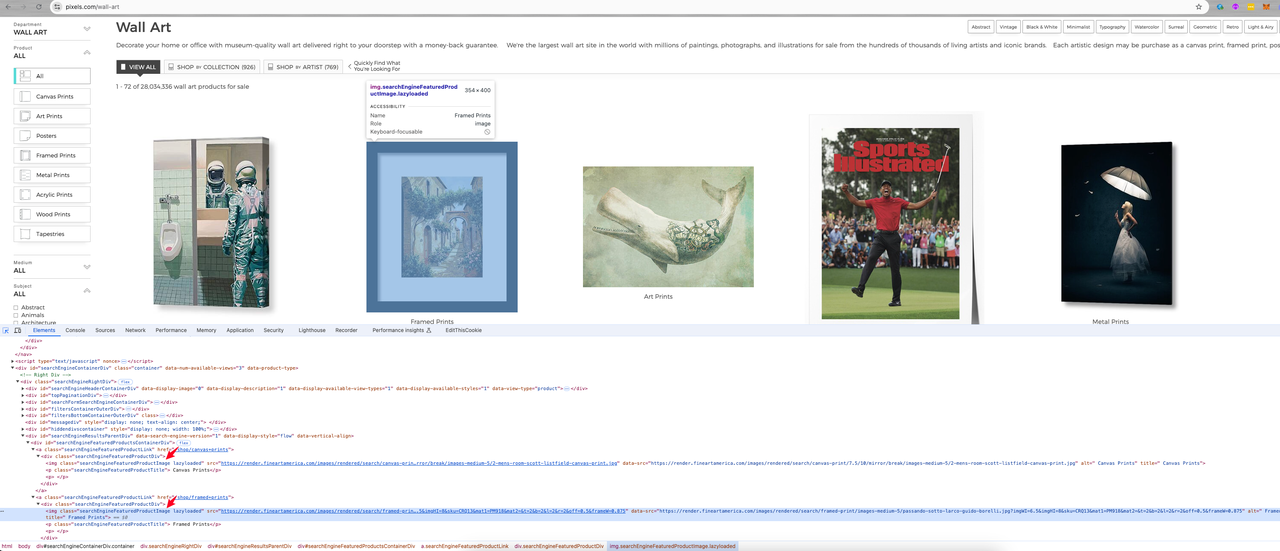
Nó cho thấy phần tử nơi hình ảnh chúng ta muốn nằm trong giá trị src của phần tử img có tên lớp là searchEngineFeaturedProductImage được tải chậm.
- Thu thập dữ liệu hình ảnh
Sửa đổi mã chúng ta đã viết trước đó để hoàn thành công việc thu thập dữ liệu:
JavaScript
import puppeteer from "puppeteer-core";

const token = "your api token";
const config = {
    proxy: 'your proxy', // required
};
const query = new URLSearchParams({
    token: token, // required
    config: JSON.stringify(config),
});
const browserWSEndpoint = `https://less.nstbrowser.io/connect?${query.toString()}`;

const getBrowser = async () => puppeteer.connect({
    browserWSEndpoint,
    defaultViewport: null,
});

(async () => {
    let browser = null;
    const pixelsWebsite = "https://pixels.com";
    await getBrowser()
        .then(async (browser) => {
            const page = await browser.newPage();
            await page.goto(pixelsWebsite);
            await page.waitForSelector("#menuTopArt", { timeout: 30000 });
            await page.click("#menuTopArt a"); // click 'Wall Art' menu
            await page.waitForSelector(".searchEngineFeaturedProductImage", { timeout: 30000 });
            const imageElements = await page.$$('.searchEngineFeaturedProductImage');
            for (const imageElement of imageElements) {
                const src = await page.evaluate(el => el.src, imageElement);
                if (src.includes("Blank.jpg")) { // break if Blank.jgp comes
                    break
                }
                console.log(src);
                // TODO: Add further processing for the image if needed
            }
            await page.close();
            await browser.close();
        })
        .catch((error) => {
            console.log(error);
        })
        .finally(() => browser?.close());
})()
Tuyệt vời! Ở đây bạn có thể tìm thấy kết quả thu thập dữ liệu:

Ghi chú
Ubuntu thật tuyệt vời! Trong bài viết này, chúng ta đã học được rằng:
- Các bước để cài đặt NodeJS trên Ubuntu 22.04
- Sử dụng Browserless thông qua Puppeteer để thu thập dữ liệu liên kết địa chỉ hình ảnh trên trang web Pixels
Bạn có thể thấy rằng toàn bộ quá trình rất nhẹ và nhanh chóng, và quá trình cũng rất đơn giản.
Bây giờ hãy bắt đầu tìm hiểu thêm về cách chơi Browserless của riêng bạn!
Hơn