Browserless
Cách lấy dữ liệu sản phẩm Amazon bằng Puppeteer và Browserless?
Lấy dữ liệu từ Amazon sẽ giúp bạn tránh được nhiều vấn đề tốn thời gian và công sức. Hãy đọc hướng dẫn này và tìm cách hiệu quả để lấy dữ liệu từ Amazon.
Nov 08, 2024Tạ Quí Lĩnh
Bạn luôn có thể tìm thấy tất cả thông tin liên quan và có giá trị về sản phẩm, người bán, đánh giá, xếp hạng, khuyến mãi, tin tức, v.v. trên Amazon. Cho dù là người bán đang nghiên cứu thị trường hay cá nhân thu thập dữ liệu, sử dụng một công cụ chất lượng cao, tiện lợi và nhanh chóng sẽ giúp bạn thu thập chính xác nhiều thông tin khác nhau trên Amazon đến mức độ lớn.
Tại sao việc thu thập dữ liệu sản phẩm Amazon lại quan trọng?
Amazon tập hợp thông tin có giá trị ở một nơi: sản phẩm, đánh giá, xếp hạng, ưu đãi độc quyền, tin tức, v.v. Do đó, thu thập dữ liệu trên Amazon sẽ phần lớn tránh được các vấn đề tốn thời gian và tốn nhiều công sức. Là một doanh nghiệp, việc sử dụng trình thu thập sản phẩm Amazon có thể mang lại cho bạn ít nhất 4 lợi ích quan trọng sau:
- Hiểu giá cả trên thị trường địa phương hoặc thậm chí toàn cầu và so sánh giá
- Phân tích sự khác biệt với đối thủ cạnh tranh
- Xác định nhóm mục tiêu
- Cải thiện hình ảnh sản phẩm
- Dự đoán nhu cầu của người dùng
- Thu thập thông tin khách hàng
Lý do điển hình để thu thập sản phẩm Amazon
- Giám sát giá cả và sản phẩm của đối thủ cạnh tranh
- Hiểu xu hướng thị trường
- Tối ưu hóa chiến lược tiếp thị
- Cải thiện danh sách sản phẩm
- Tối ưu hóa giá cả
- Nâng cao nghiên cứu sản phẩm
- Theo dõi tâm lý khách hàng
Browserless có giúp xây dựng trình thu thập sản phẩm Amazon không?
Trình duyệt không đầu rất xuất sắc trong việc thực hiện công việc tự động? Đúng vậy, chúng ta sẽ sử dụng dịch vụ trình duyệt không đầu mạnh mẽ nhất của Nstbrowser: Browserless để thu thập thông tin sản phẩm Amazon.
Khi thu thập dữ liệu sản phẩm Amazon, chúng ta luôn gặp phải một loạt các thách thức nghiêm trọng như phát hiện robot, nhận dạng mã xác thực và chặn IP. Sử dụng Browserless có thể tránh hoàn toàn những cơn đau đầu này!
Browserless của Nstbrowser cung cấp dấu vân tay trình duyệt người dùng thực, và mỗi dấu vân tay là duy nhất. Ngoài ra, tham gia vào gói đăng ký của chúng tôi có thể đạt được việc bỏ qua captcha hoàn toàn, hộ tống trải nghiệm truy cập không bị cản trở của bạn. Tham gia chương trình giới thiệu Discord của chúng tôi để chia sẻ 1.500 đô la tiền mặt ngay bây giờ!
Tìm hiểu thêm chi tiết về Browserless trong video của chúng tôi!
Làm cách nào chúng ta có thể thu thập dữ liệu sản phẩm Amazon?
Không cần phải nói thêm nữa, bây giờ hãy chính thức bắt đầu sử dụng Browserless để thu thập dữ liệu!
Điều kiện tiên quyết
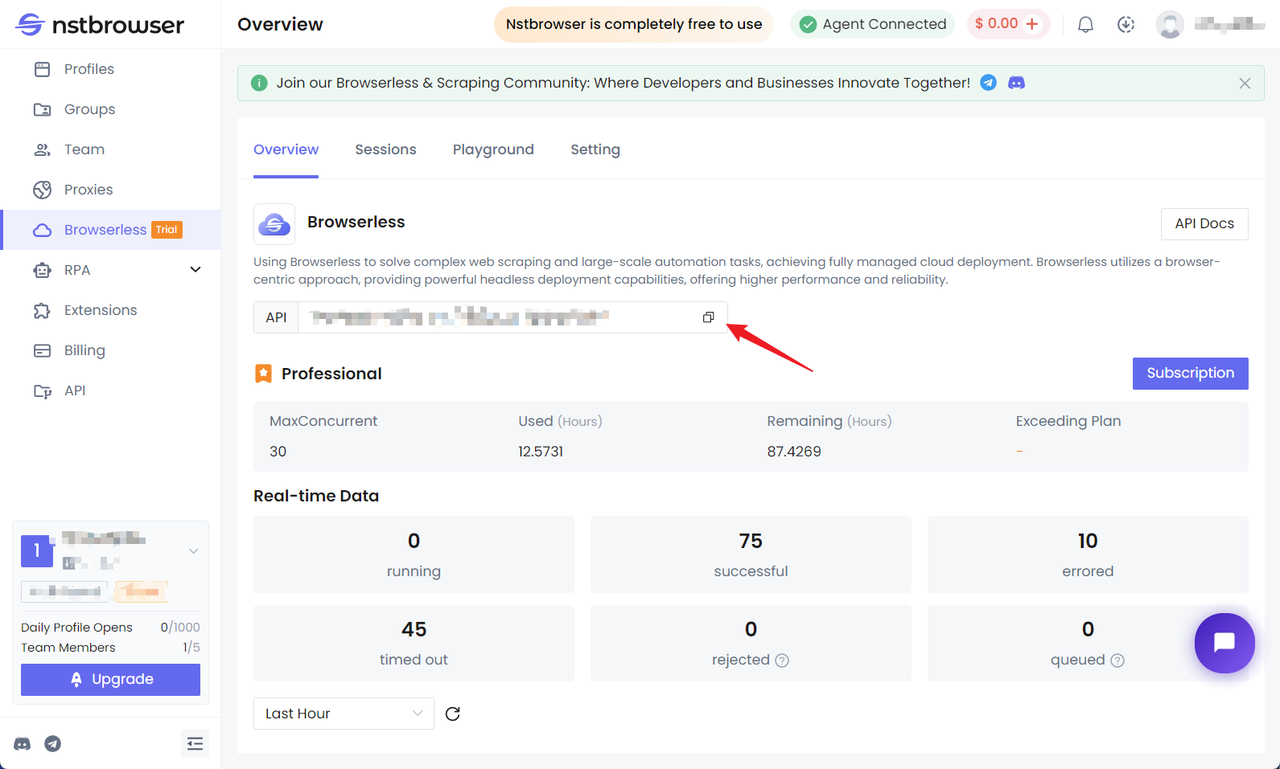
Trước khi bắt đầu, chúng ta cần kết nối với dịch vụ Browserless. Sử dụng Browserless có thể giải quyết các nhiệm vụ thu thập web phức tạp và tự động quy mô lớn, và bạn thực sự có thể tận hưởng việc triển khai đám mây được quản lý đầy đủ.
Browserless áp dụng khái niệm tập trung vào trình duyệt, cung cấp khả năng triển khai không đầu mạnh mẽ và mang lại hiệu suất và độ tin cậy cao hơn. Để biết thêm thông tin về Browserless, bạn có thể tham khảo tài liệu liên quan của chúng tôi.
Lấy API KEY và đi đến trang menu Browserless của khách hàng Nstbrowser, hoặc bạn có thể nhấp vào đây để truy cập trực tiếp.
Cài đặt Puppeteer và kết nối với Browserless
- Cài đặt Puppeteer. puppeteer-core nhẹ hơn là lựa chọn tốt hơn.
Bash
# pnpm
pnpm i puppeteer-core
# yarn
yarn add puppeteer-core
# npm
npm i --save puppeteer-core- Chúng tôi đã chuẩn bị mã để gọi Browserless. Bạn chỉ cần điền apiKey và proxy để bắt đầu hoạt động thu thập sản phẩm Amazon tiếp theo:
JavaScript
const apiKey = "your ApiKey"; // bắt buộc
const config = {
    proxy: 'your proxy', // bắt buộc; định dạng đầu vào: schema://user:password@host:port eg: http://user:password@localhost:8080
    // platform: 'windows', // hỗ trợ: windows, mac, linux
    // kernel: 'chromium', // chỉ hỗ trợ: chromium
    // kernelMilestone: '128', // hỗ trợ: 128
    // args: {
    //     "--proxy-bypass-list": "detect.nstbrowser.io"
    // }, // đối số trình duyệt
    // fingerprint: {
    //     userAgent: 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36', // userAgent được hỗ trợ kể từ v0.15.0
    // },
};
const query = new URLSearchParams({
    token: apiKey, // bắt buộc
    config: JSON.stringify(config),
});
const browserlessWSEndpoint = `https://less.nstbrowser.io/connect?${query.toString()}`;
Bắt đầu thu thập
Bước 1: Kiểm tra trang mục tiêu
Trước khi thu thập, chúng ta có thể thử truy cập https://www.amazon.com/. Nếu đây là lần đầu tiên truy cập, rất có khả năng một mã xác thực sẽ xuất hiện:
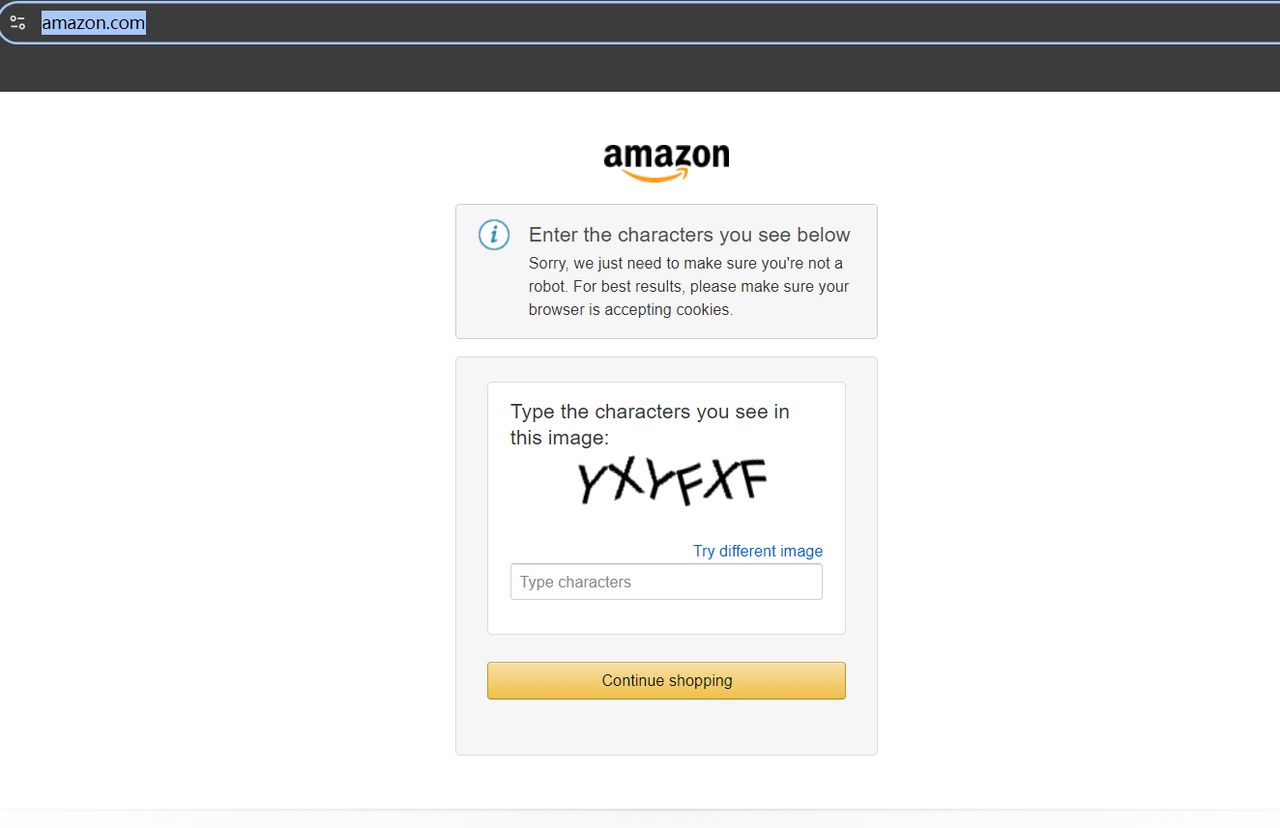
Nhưng không sao, chúng ta không cần phải cố gắng hết sức để tìm một công cụ giải mã mã xác thực. Tại thời điểm này, bạn chỉ cần truy cập tên miền Amazon trong khu vực của mình hoặc khu vực của proxy, và mã xác thực sẽ không bị kích hoạt.
Ví dụ: hãy truy cập: https://www.amazon.co.uk/: tên miền Amazon ở Vương quốc Anh. Chúng ta có thể thấy trang chạy mượt mà, sau đó thử nhập từ khóa sản phẩm mà chúng ta muốn vào thanh tìm kiếm ở trên cùng hoặc truy cập trực tiếp thông qua URL, như:
Bash
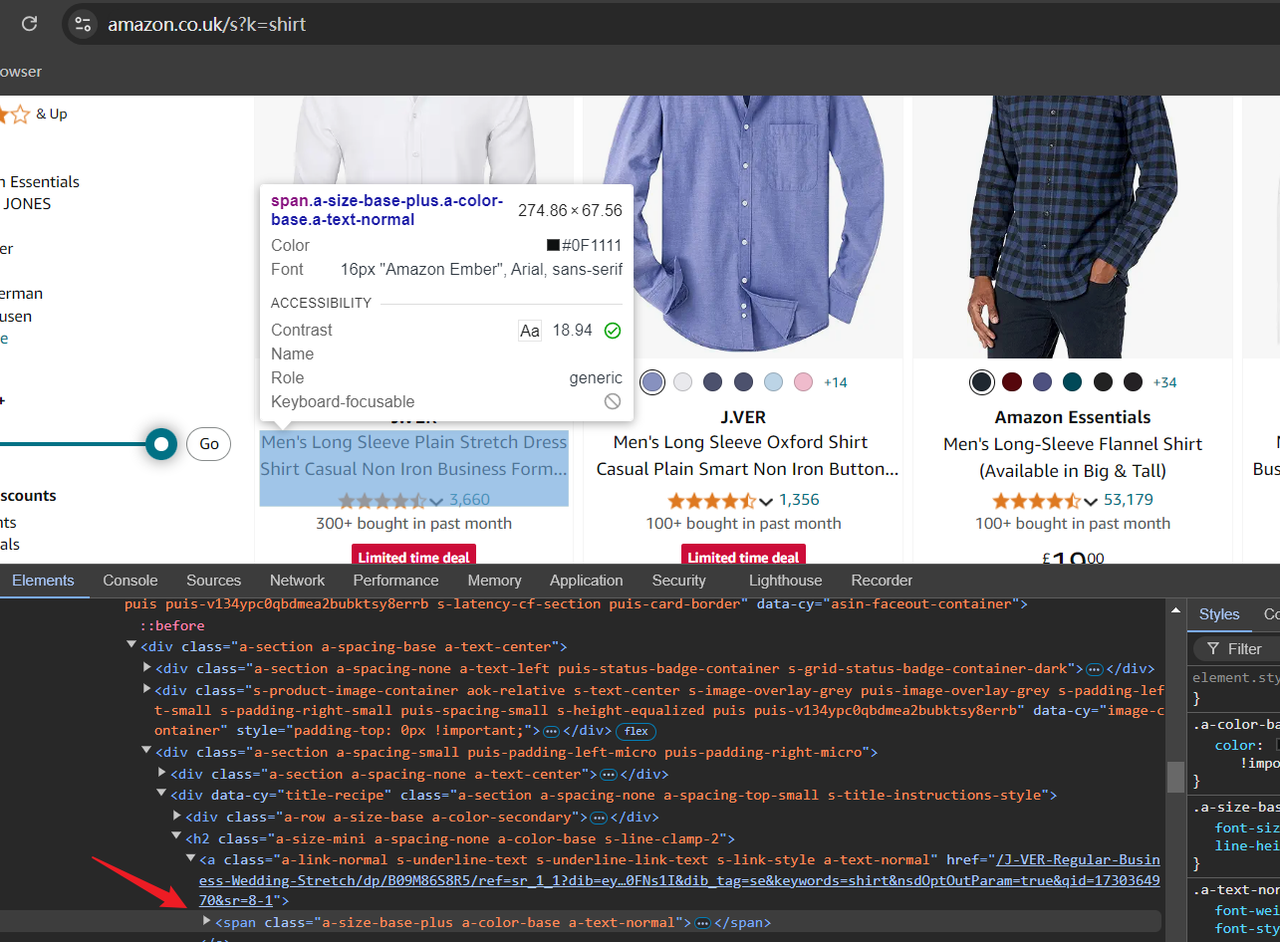
https://www.amazon.co.uk/s?k=shirtGiá trị sau /s?k= trong URL là từ khóa của sản phẩm. Bằng cách truy cập URL ở trên, bạn sẽ thấy các sản phẩm liên quan đến áo sơ mi trên Amazon. Bây giờ bạn có thể mở "Công cụ dành cho nhà phát triển" (F12) để kiểm tra cấu trúc HTML của trang và xác nhận dữ liệu mà chúng ta cần thu thập sau này bằng cách định vị con trỏ.
Bước 2: Viết kịch bản
Đầu tiên, tôi đã thêm một chuỗi mã ở đầu kịch bản. Mã sau sử dụng tham số kịch bản đầu tiên làm từ khóa sản phẩm Amazon, và các kịch bản tiếp theo cũng sẽ sử dụng tham số này để thu thập:
JavaScript
const productName = process.argv.slice(2);

if (productName.length !== 1) {
  console.error('product name CLI arguments missing!');
  process.exit(2);
}
Tiếp theo, chúng ta cần:
- Nhập Puppeteer và kết nối với Browserless
- Đi đến trang kết quả truy vấn sản phẩm tương ứng với Amazon
- Thêm ảnh chụp màn hình để xác minh xem quyền truy cập có thành công hay không
JavaScript
import puppeteer from "puppeteer-core";

const browser = await puppeteer.connect({
  browserWSEndpoint: browserlessWSEndpoint,
  defaultViewport: null,
})
console.info('Connected!');

const page = await browser.newPage();

await page.goto(`https://www.amazon.co.uk/s?k=${productName}`);

// Thêm ảnh chụp màn hình để hỗ trợ khắc phục sự cố sau này
await page.screenshot({ path: 'amazon_page.png' })
Bây giờ chúng ta sử dụng page.$$ để lấy danh sách tất cả các sản phẩm, lặp qua danh sách sản phẩm và lấy dữ liệu liên quan một lần một lần trong vòng lặp. Sau đó, thu thập dữ liệu này vào mảng productDataList và in ra:
JavaScript
// Lấy phần tử chứa của tất cả kết quả tìm kiếm
const productContainers = await page.$$('div[data-component-type="s-search-result"]')

const productDataList = []

// Lấy nhiều thông tin về sản phẩm: tiêu đề, đánh giá, liên kết hình ảnh, giá cả
for (const product of productContainers) {

  async function safeEval(selector, evalFn) {
    try {
      return await product.$eval(selector, evalFn);
    } catch (e) {
      return null;
    }
  }

  const title = await safeEval('.s-title-instructions-style > h2 > a > span', node => node.textContent)
  const rate = await safeEval('a > i.a-icon.a-icon-star-small > span', node => node.textContent)
  const img = await safeEval('span[data-component-type="s-product-image"] img', node => node.getAttribute('src'))
  const price = await safeEval('div[data-cy="price-recipe"] .a-offscreen', node => node.textContent)

  productDataList.push({ title, rate, img, price })
}

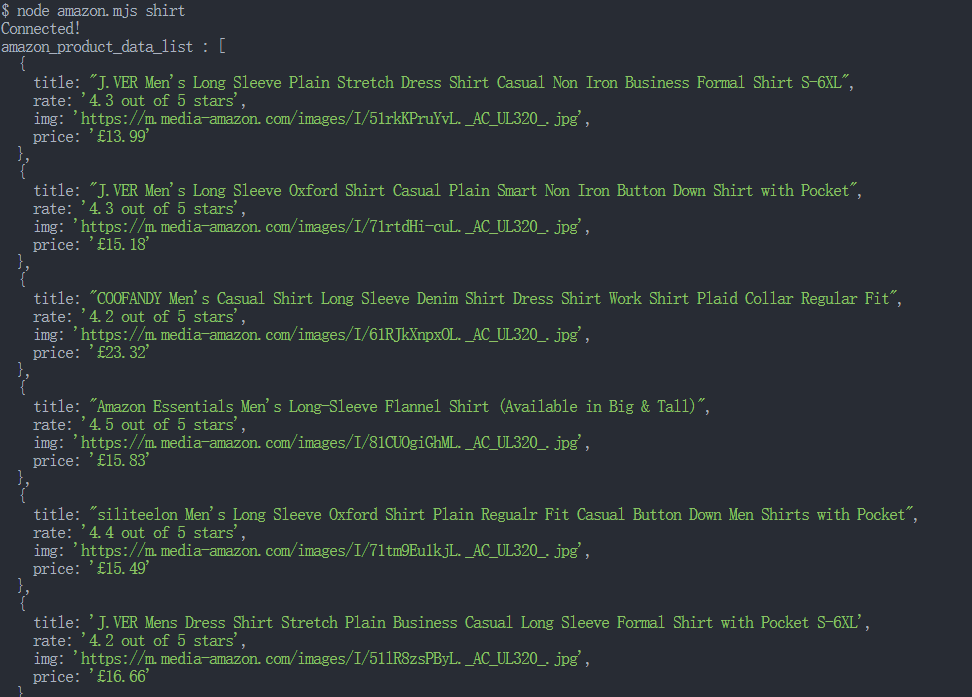
console.log('amazon_product_data_list :', productDataList);

await browser.close();
Chạy kịch bản:
Bash
node amazon.mjs shirtNếu thành công, kết quả sau sẽ được in trên bảng điều khiển:
Bước 3: Xuất dữ liệu thu thập dưới dạng tệp JSON
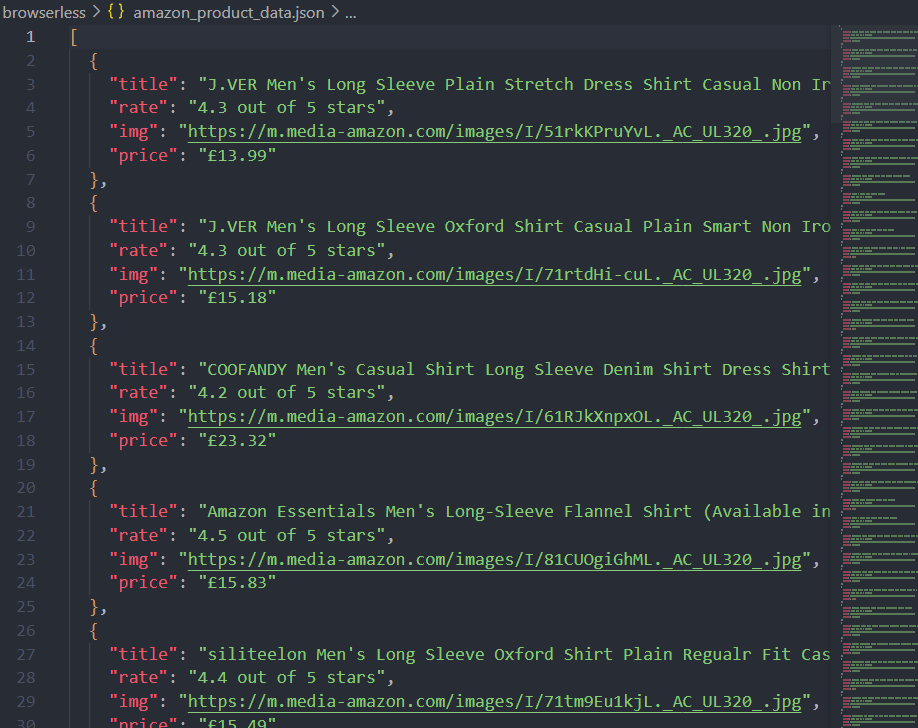
Rõ ràng, để phân tích dữ liệu tốt hơn, việc chỉ in dữ liệu trong bảng điều khiển là không đủ. Dưới đây là một ví dụ đơn giản: nhanh chóng chuyển đổi đối tượng JS thành tệp JSON thông qua mô-đun fs:
JavaScript
import fs from 'fs'

function saveObjectToJson(obj, filename) {
  const jsonString = JSON.stringify(obj, null, 2)
  fs.writeFile(filename, jsonString, 'utf8', (err) => {
    err ? console.error(err) : console.log(`File saved successfully: ${filename}`);
  });
}

saveObjectToJson(productDataList, 'amazon_product_data.json')
Được rồi, hãy xem xét mã đầy đủ của chúng tôi:
JavaScript
import puppeteer from "puppeteer-core";
import fs from 'fs'

const productName = process.argv.slice(2);

if (productName.length !== 1) {
  console.error('product name CLI arguments missing!');
  process.exit(2);
}

const apiKey = "your ApiKey"; // 'your proxy'

const config = {
  proxy: 'your proxy', // bắt buộc; định dạng đầu vào: schema://user:password@host:port eg: http://user:password@localhost:8080
  // platform: 'windows', // hỗ trợ: windows, mac, linux
  // kernel: 'chromium', // chỉ hỗ trợ: chromium
  // kernelMilestone: '128', // hỗ trợ: 128
  // args: {
  //     "--proxy-bypass-list": "detect.nstbrowser.io"
  // }, // đối số trình duyệt
  // fingerprint: {
  //     userAgent: 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36', // userAgent được hỗ trợ kể từ v0.15.0
  // },
};

const query = new URLSearchParams({
  token: apiKey, // bắt buộc
  config: JSON.stringify(config),
});

const browserlessWSEndpoint = `https://less.nstbrowser.io/connect?${query.toString()}`;

const browser = await puppeteer.connect({
  browserWSEndpoint: browserlessWSEndpoint,
  defaultViewport: null,
})
console.info('Connected!');

const page = await browser.newPage();

await page.goto(`https://www.amazon.co.uk/s?k=${productName}`);

// Thêm ảnh chụp màn hình để hỗ trợ khắc phục sự cố sau này
await page.screenshot({ path: 'amazon_page.png' })

// Lấy phần tử chứa của tất cả kết quả tìm kiếm
const productContainers = await page.$$('div[data-component-type="s-search-result"]')

const productDataList = []

// Lấy nhiều thông tin về sản phẩm: tiêu đề, đánh giá, liên kết hình ảnh, giá cả
for (const product of productContainers) {

  async function safeEval(selector, evalFn) {
    try {
      return await product.$eval(selector, evalFn);
    } catch (e) {
      console.log(`Error fetching ${selector}:`, e);
      return null;
    }
  }

  const title = await safeEval('.s-title-instructions-style > h2 > a > span', node => node.textContent)
  const rate = await safeEval('a > i.a-icon.a-icon-star-small > span', node => node.textContent)
  const img = await safeEval('span[data-component-type="s-product-image"] img', node => node.getAttribute('src'))
  const price = await safeEval('div[data-cy="price-recipe"] .a-offscreen', node => node.textContent)

  productDataList.push({ title, rate, img, price })
}

function saveObjectToJson(obj, filename) {
  const jsonString = JSON.stringify(obj, null, 2)
  fs.writeFile(filename, jsonString, 'utf8', (err) => {
    err ? console.error(err) : console.log(`File saved successfully: ${filename}`);
  });
}

saveObjectToJson(productDataList, 'amazon_product_data.json')

console.log('amazon_product_data_list :', productDataList);

await browser.close();
Bây giờ, sau khi chạy kịch bản, bạn không chỉ thấy bảng điều khiển in ra, mà còn tệp amazon_product_data.json được viết dưới đường dẫn hiện tại.
Kiểm tra bảng điều khiển Browserless
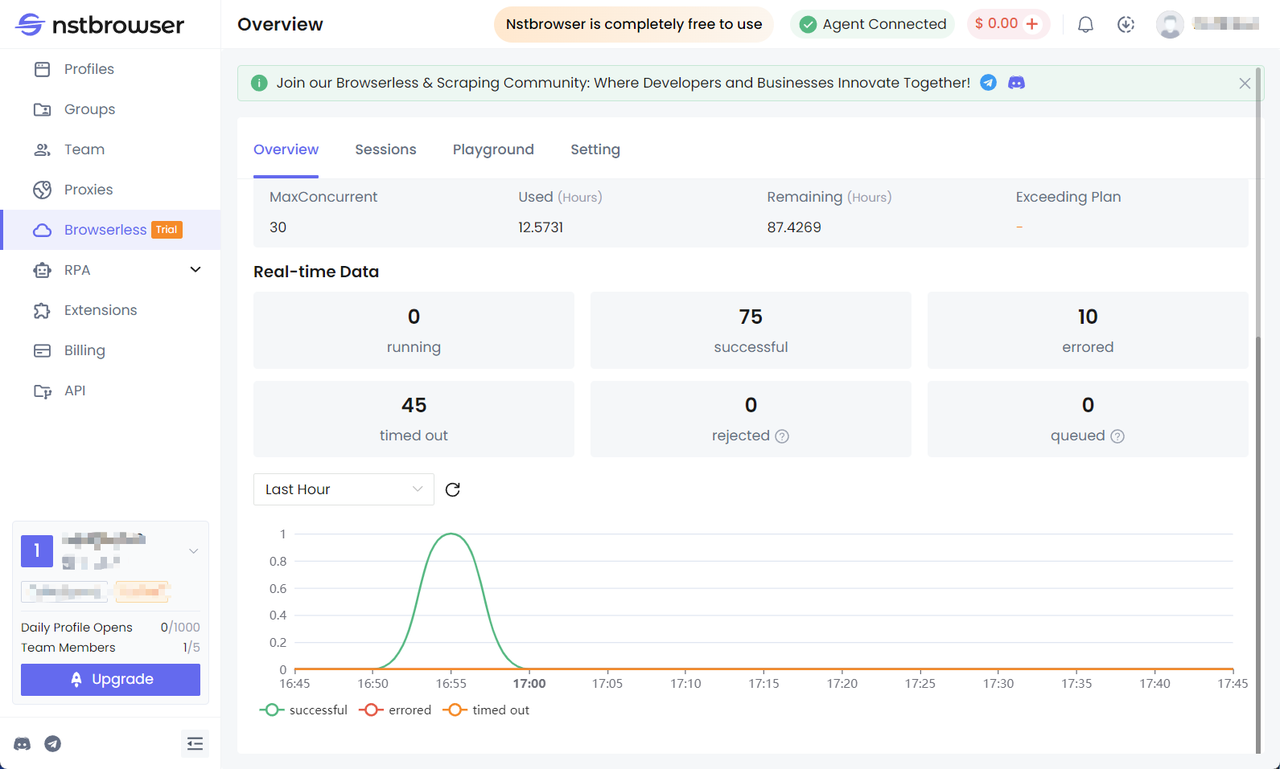
Bạn có thể xem thống kê cho các yêu cầu gần đây và thời gian phiên còn lại trong menu Browserless của khách hàng Nstbrowser.
Nstbrowser RPA: Cách dễ dàng hơn để xây dựng trình thu thập sản phẩm Amazon của bạn
Sử dụng các công cụ RPA để thu thập dữ liệu web là một phương pháp thu thập dữ liệu phổ biến. Sử dụng các công cụ RPA có thể cải thiện đáng kể hiệu quả thu thập dữ liệu và giảm chi phí thu thập. Chức năng Nstbrowser RPA có thể mang lại cho bạn trải nghiệm RPA tốt nhất và hiệu quả công việc tốt nhất.
Sau khi đọc hướng dẫn này, bạn sẽ:
- Hiểu cách sử dụng RPA để thu thập dữ liệu
- Hiểu cách lưu trữ dữ liệu được RPA thu thập
Chuẩn bị
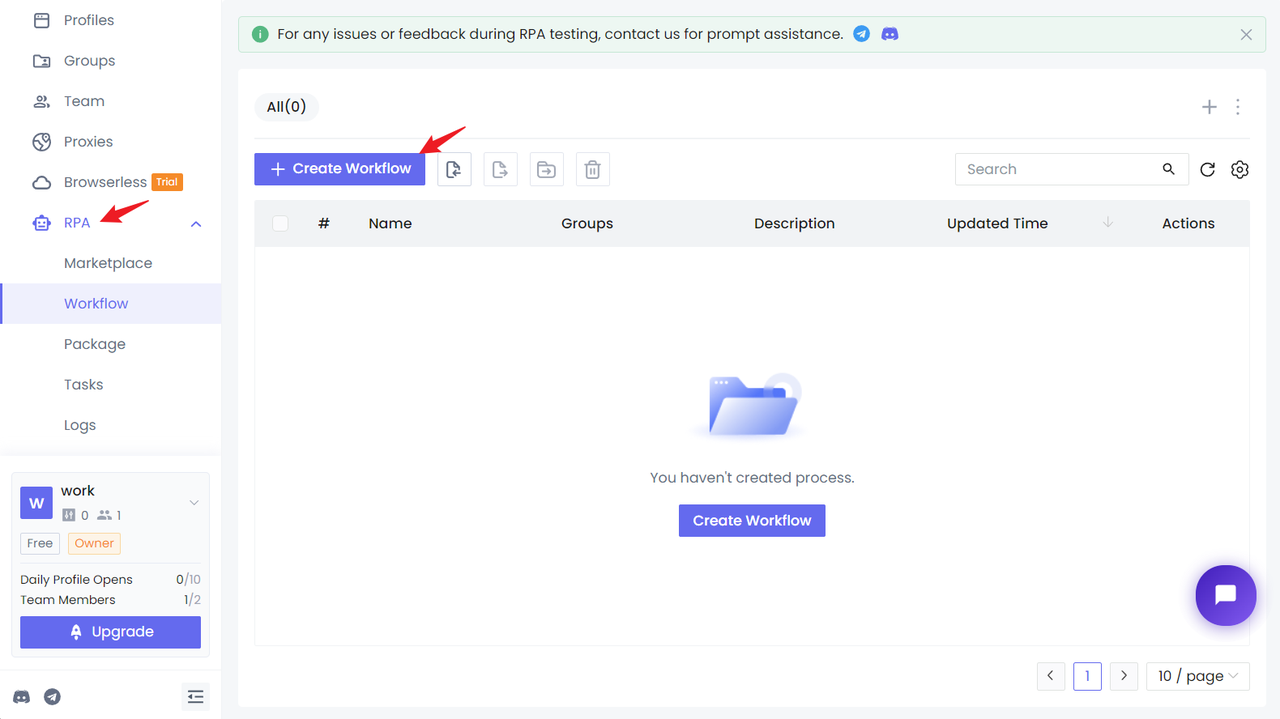
Đầu tiên, bạn cần có tài khoản Nstbrowser, sau đó đăng nhập vào khách hàng Nstbrowser, nhập trang luồng công việc của mô-đun RPA và nhấp vào Luồng công việc mới.
Bây giờ, chúng ta có thể bắt đầu cấu hình luồng công việc thu thập RPA dựa trên kết quả tìm kiếm sản phẩm Amazon.
Bước 1. Truy cập trang web mục tiêu
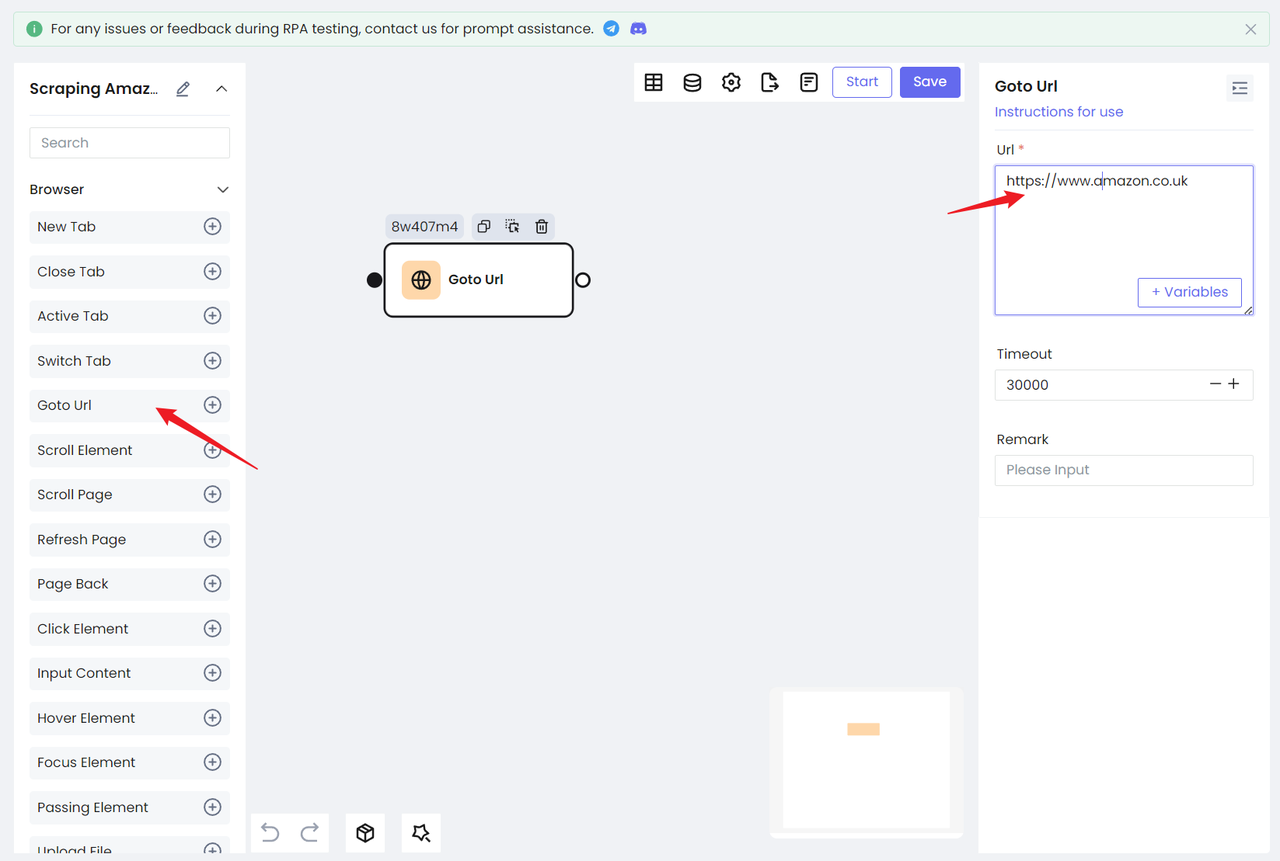
- Chúng ta cần truy cập trang web mục tiêu của mình: https://www.amazon.co.uk;
- Bạn cũng có thể sử dụng trang web chính của Amazon trực tiếp: https://www.amazon.com/, nhưng bạn cần xử lý thủ công mã xác thực cho lần truy cập đầu tiên;
- Sử dụng nút
Goto Url, cấu hình URL trang web và bạn có thể truy cập trang web mục tiêu:
Bước 2. Tìm kiếm nội dung mục tiêu
Lần này chúng ta sẽ không sử dụng phương pháp truy vấn sản phẩm tương ứng thông qua URL, mà sẽ sử dụng RPA để hỗ trợ nhập vào hộp nhập liệu trên trang chủ và sau đó kích hoạt chuyển hướng truy vấn. Điều này không chỉ giúp chúng ta làm quen với hoạt động của RPA, mà còn tránh kiểm soát rủi ro trang web đến mức độ lớn hơn.
Được rồi, sau khi truy cập trang web mục tiêu, chúng ta cần tìm kiếm địa chỉ mục tiêu trước. Ở đây chúng ta cần sử dụng công cụ Chrome Devtool để định vị phần tử HTML.
- Mở công cụ Devtool và chọn hộp tìm kiếm bằng chuột. Chúng ta có thể thấy:
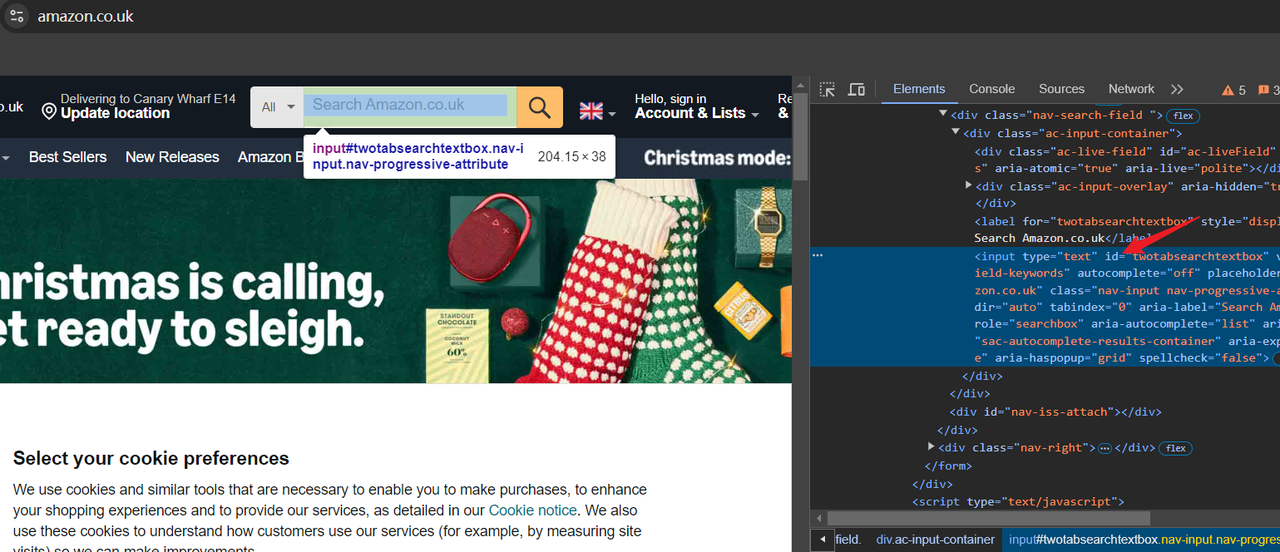
- Hộp nhập liệu mục tiêu của chúng ta có thuộc tính id, có thể được sử dụng làm bộ chọn CSS để định vị hộp nhập liệu.
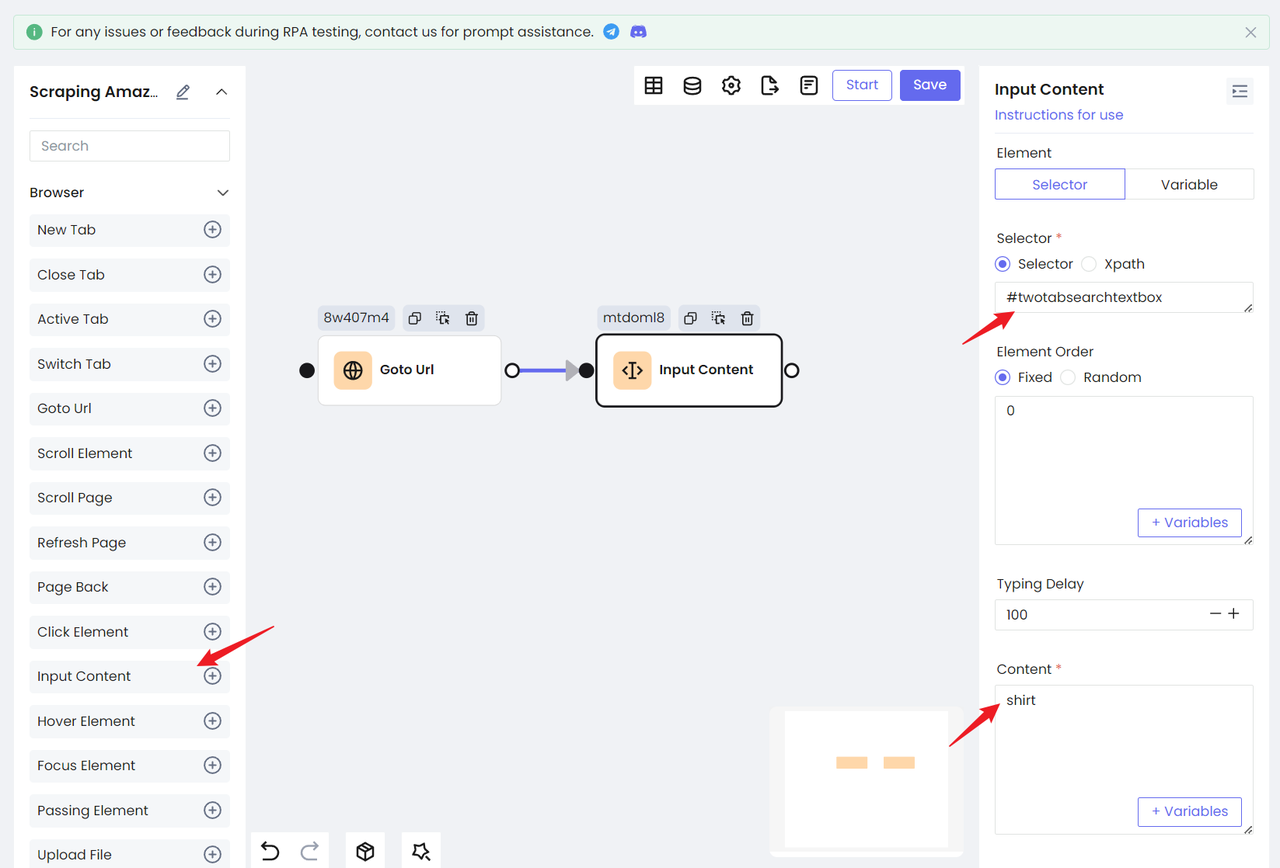
Thêm nút Input Content:
- Chọn Bộ chọn trong tùy chọn Phần tử. Tùy chọn này đồng nhất chọn Bộ chọn.
- Điền bộ chọn CSS của
idmà chúng tôi đã định vị trong hộp nhập liệu - sau đó nhập nội dung mà chúng ta muốn tìm kiếm trong tùy chọn Nội dung.
Bằng cách này, chúng ta đã hoàn thành hành động nhập vào hộp nhập liệu.
- Sau đó sử dụng nút
Keyboardđể mô phỏng hành động enter của bàn phím để tìm kiếm sản phẩm:
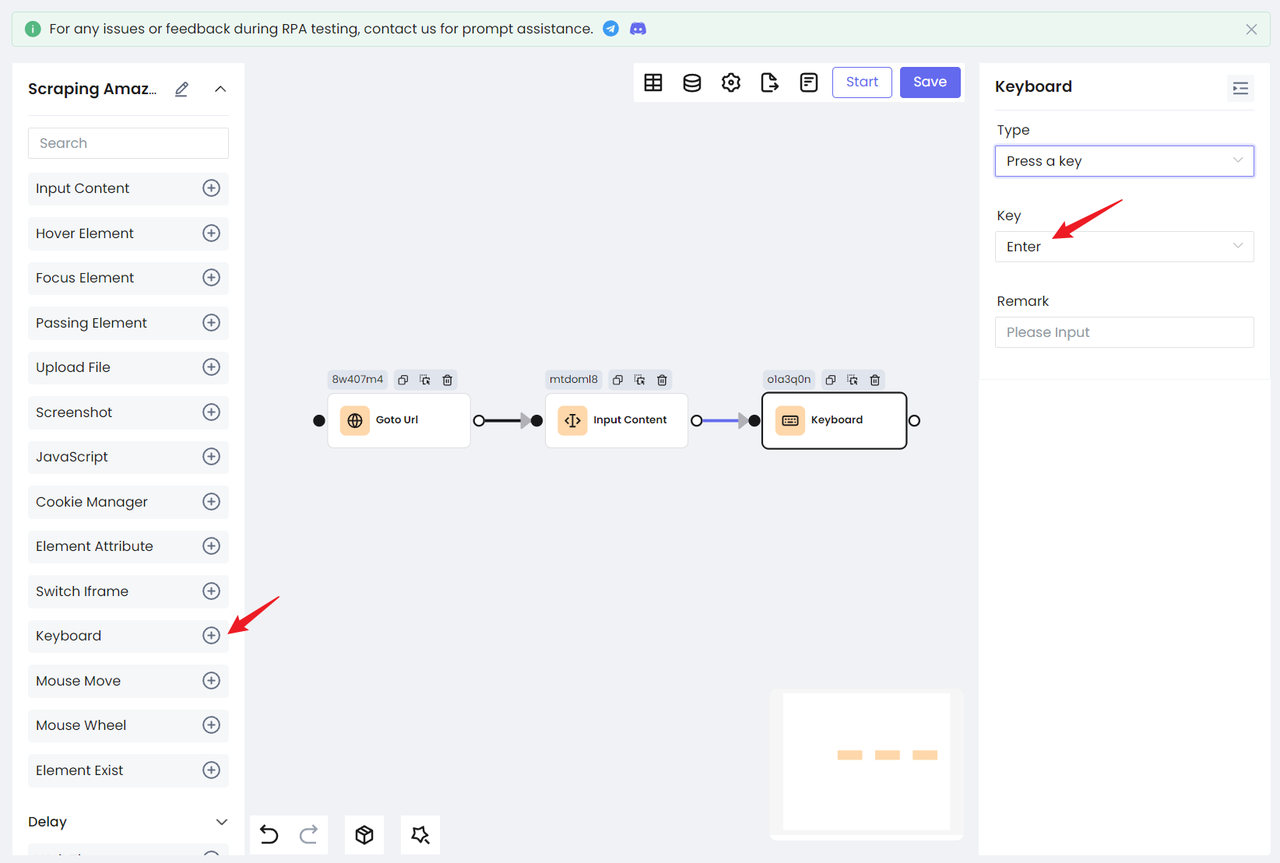
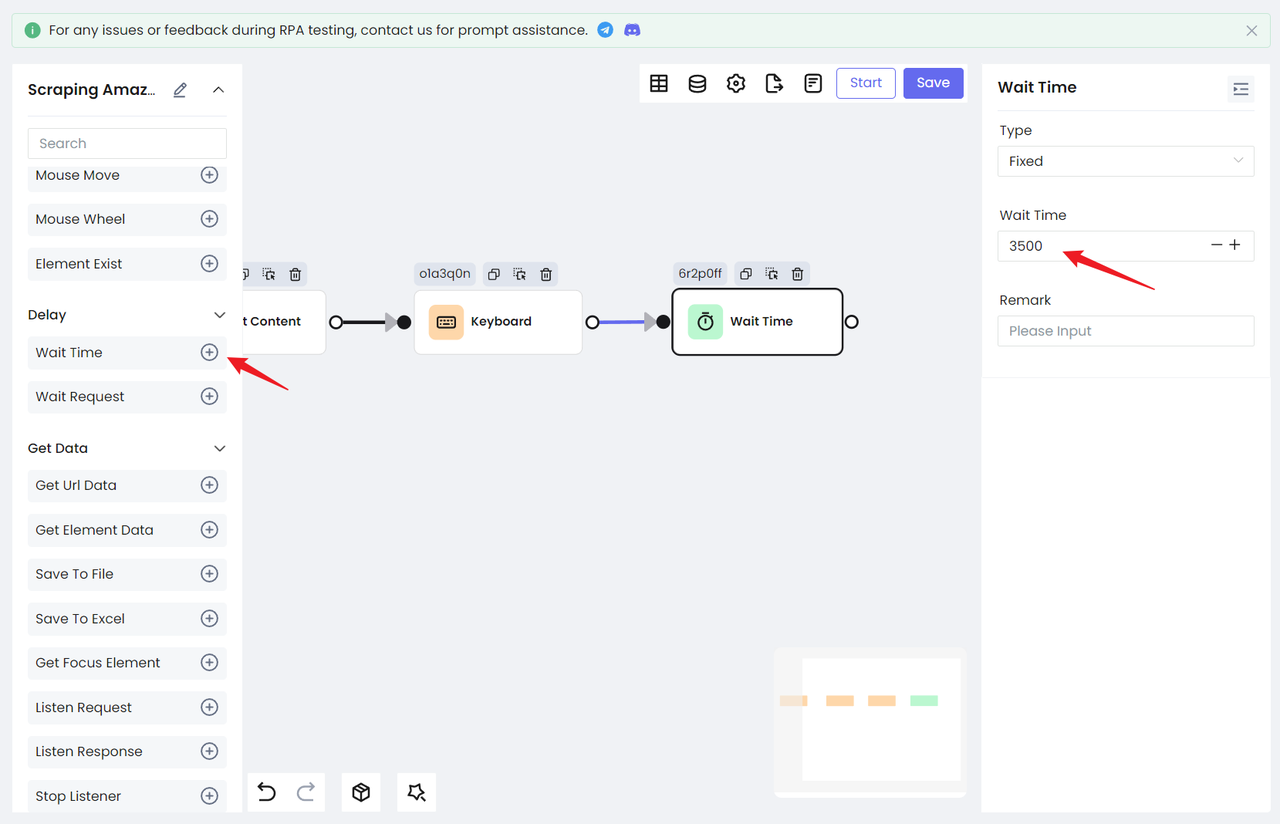
Bởi vì trang tìm kiếm sẽ chuyển hướng đến một trang mới, chúng ta cần thêm hành động chờ để đảm bảo rằng chúng ta đã tải thành công trang kết quả. Nstbrowser RPA cung cấp hai hành vi chờ: Wait Time và Wait Request.
Wait Time: được sử dụng để chờ một khoảng thời gian. Bạn có thể chọn thời gian cố định hoặc thời gian ngẫu nhiên tùy theo tình huống cụ thể của mình.Wait Request: được sử dụng để chờ yêu cầu mạng kết thúc. Áp dụng cho trường hợp thu thập dữ liệu thông qua yêu cầu mạng.
Bước 3. Duyệt qua danh sách sản phẩm
Được rồi, bây giờ chúng ta có thể thấy thành công trang tìm kiếm sản phẩm mới, và bước tiếp theo là thu thập các nội dung này.
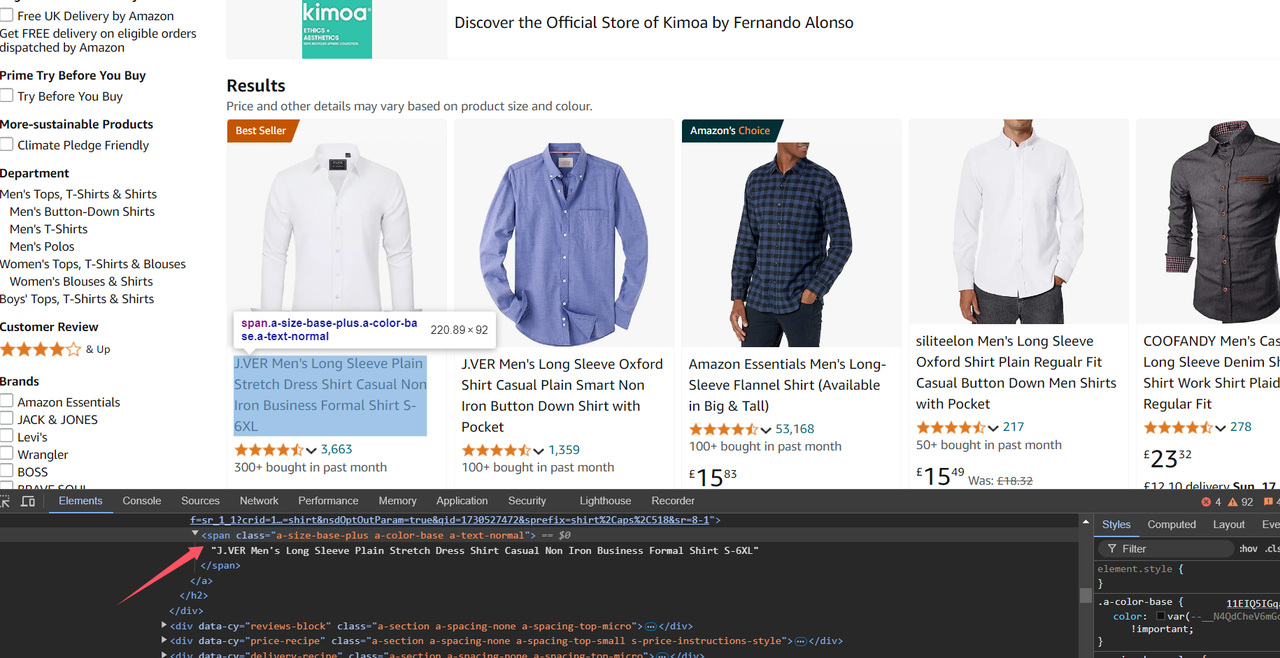
Bằng cách quan sát, chúng ta có thể thấy rằng kết quả tìm kiếm của Amazon được hiển thị dưới dạng danh sách thẻ. Đây là một phương pháp hiển thị rất cổ điển:
Tương tự như vậy, mở công cụ Devtool và định vị từng dữ liệu trong thẻ:
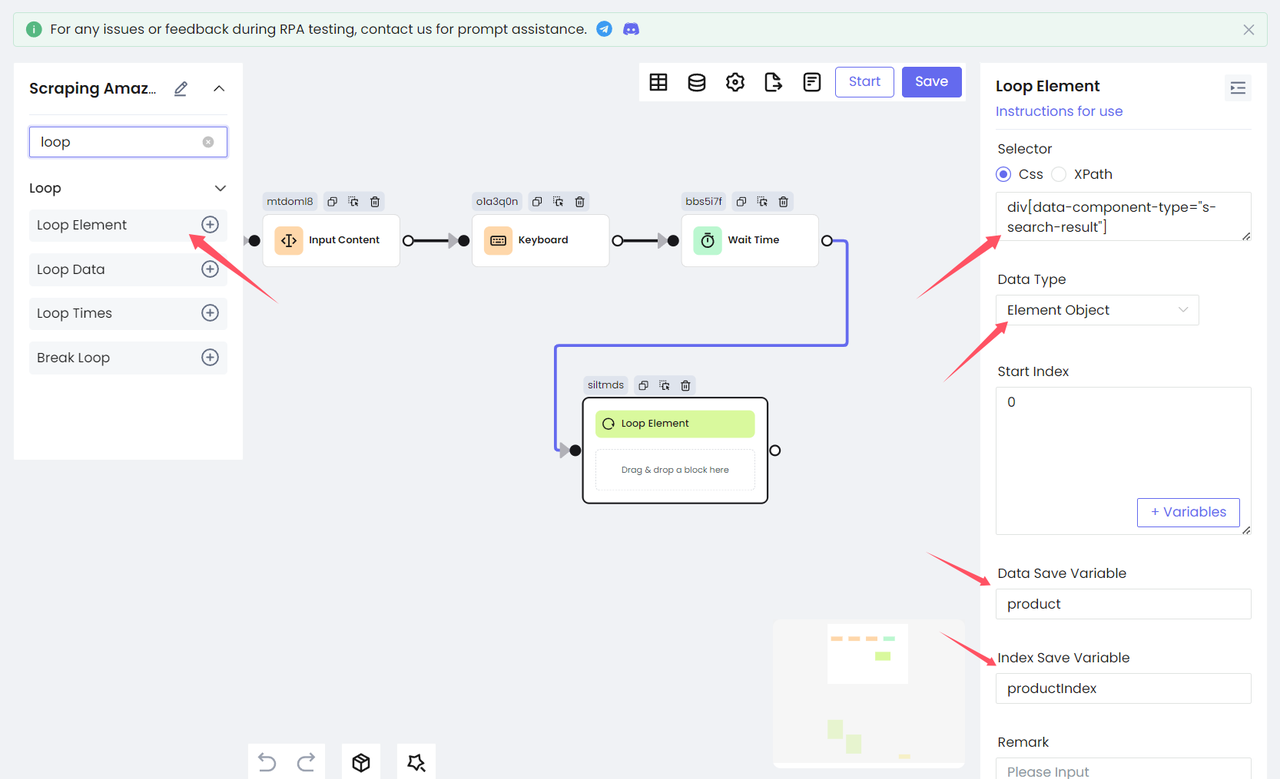
Bởi vì mỗi mục trong danh sách thẻ là một phần tử HTML, chúng ta cần sử dụng nút Loop Element để duyệt qua tất cả kết quả truy vấn. Chúng ta điền bộ chọn CSS của danh sách product trong Bộ chọn và chọn Element Object cho Kiểu dữ liệu, có nghĩa là lấy phần tử mục tiêu và lưu nó dưới dạng đối tượng phần tử vào một biến. Đặt tên biến thành product thông qua Lưu biến dữ liệu và lưu chỉ mục dưới dạng productIndex.
Bước 4. Lấy dữ liệu
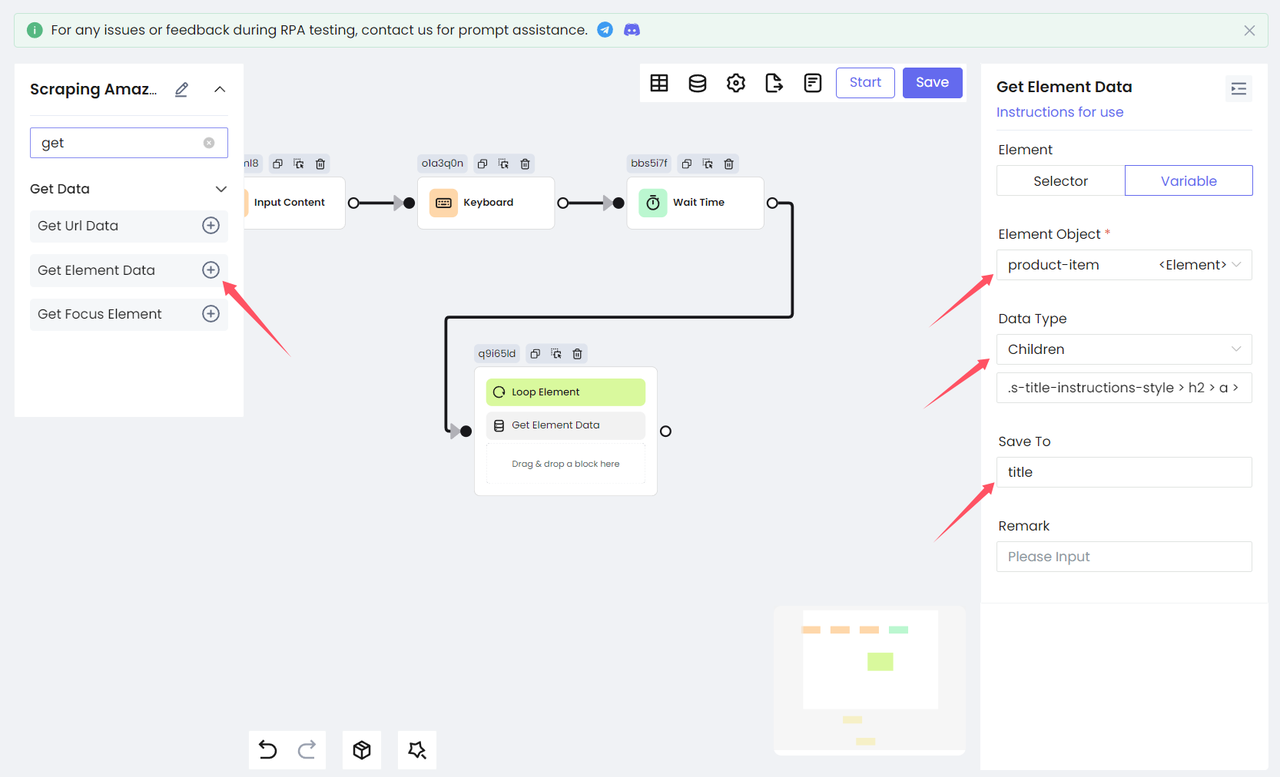
Tiếp theo, chúng ta cần xử lý từng phần tử được duyệt qua và lấy thông tin mà chúng ta cần từ product. Chúng ta lấy phần tử tiêu đề của sản phẩm. Ở đây chúng ta cần sử dụng nút Get Element Data để lấy và cuối cùng lưu nó dưới dạng biến title.
Chọn Children làm Kiểu dữ liệu, có nghĩa là lấy các phần tử con của phần tử mục tiêu và lưu nó dưới dạng đối tượng phần tử trong biến title. Bạn cần điền bộ chọn phần tử của phần tử con. Bộ chọn CSS được nhập vào đây là bộ chọn CSS của tiêu đề sản phẩm:
Sau đó, chúng ta sử dụng cùng một phương pháp để chuyển đổi thông tin sản phẩm còn lại: xếp hạng, liên kết hình ảnh và giá cả, tất cả thành quy trình RPA.
- Tên biến và bộ chọn CSS của Children:
Bash
'title' .s-title-instructions-style > h2 > a > span
'rate' a > i.a-icon.a-icon-star-small > span
'img' span[data-component-type="s-product-image"] img
'price' div[data-cy="price-recipe"] .a-offscreen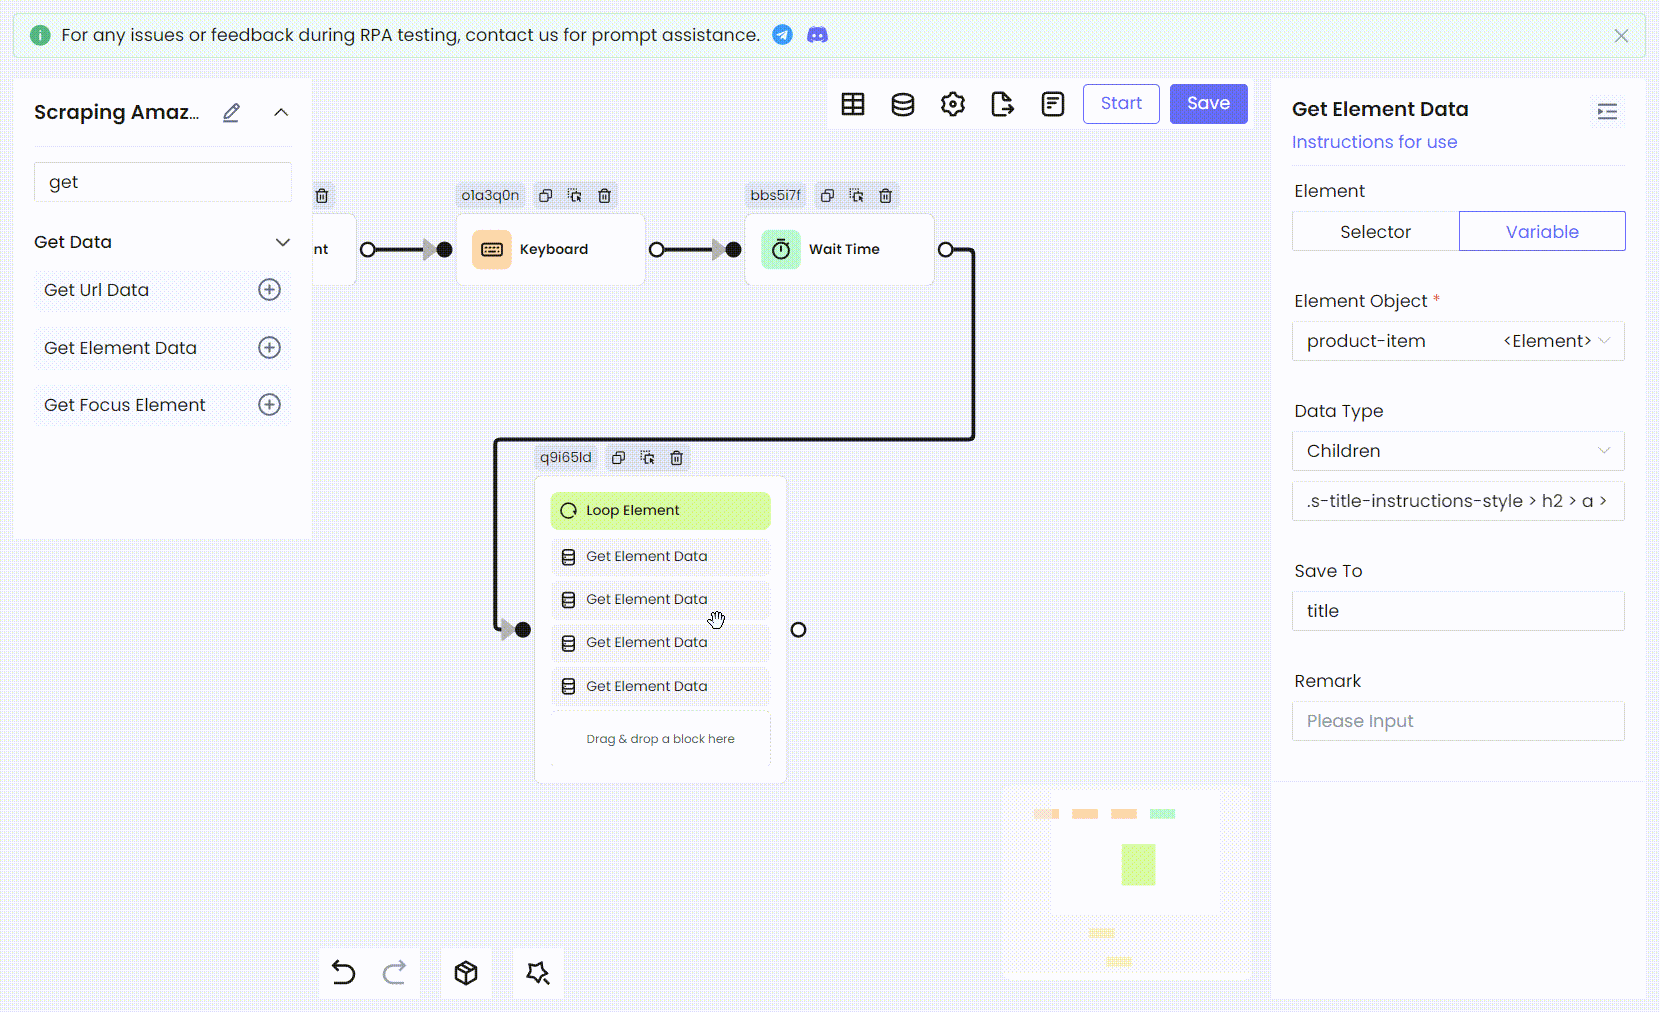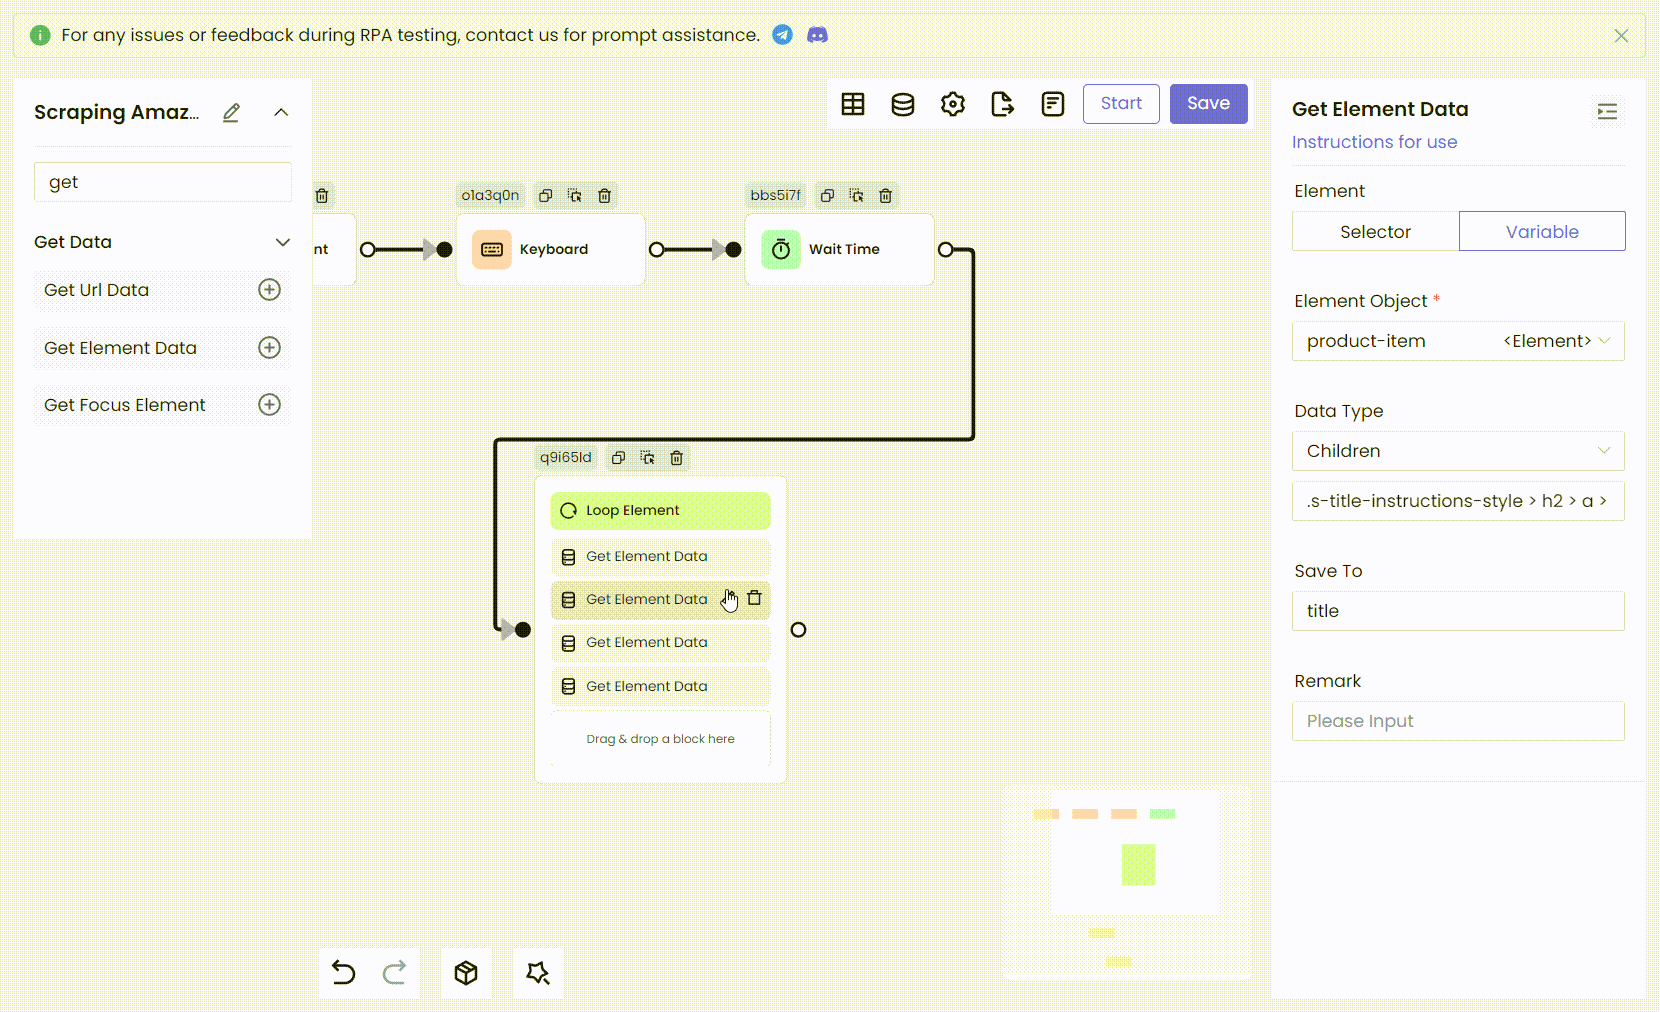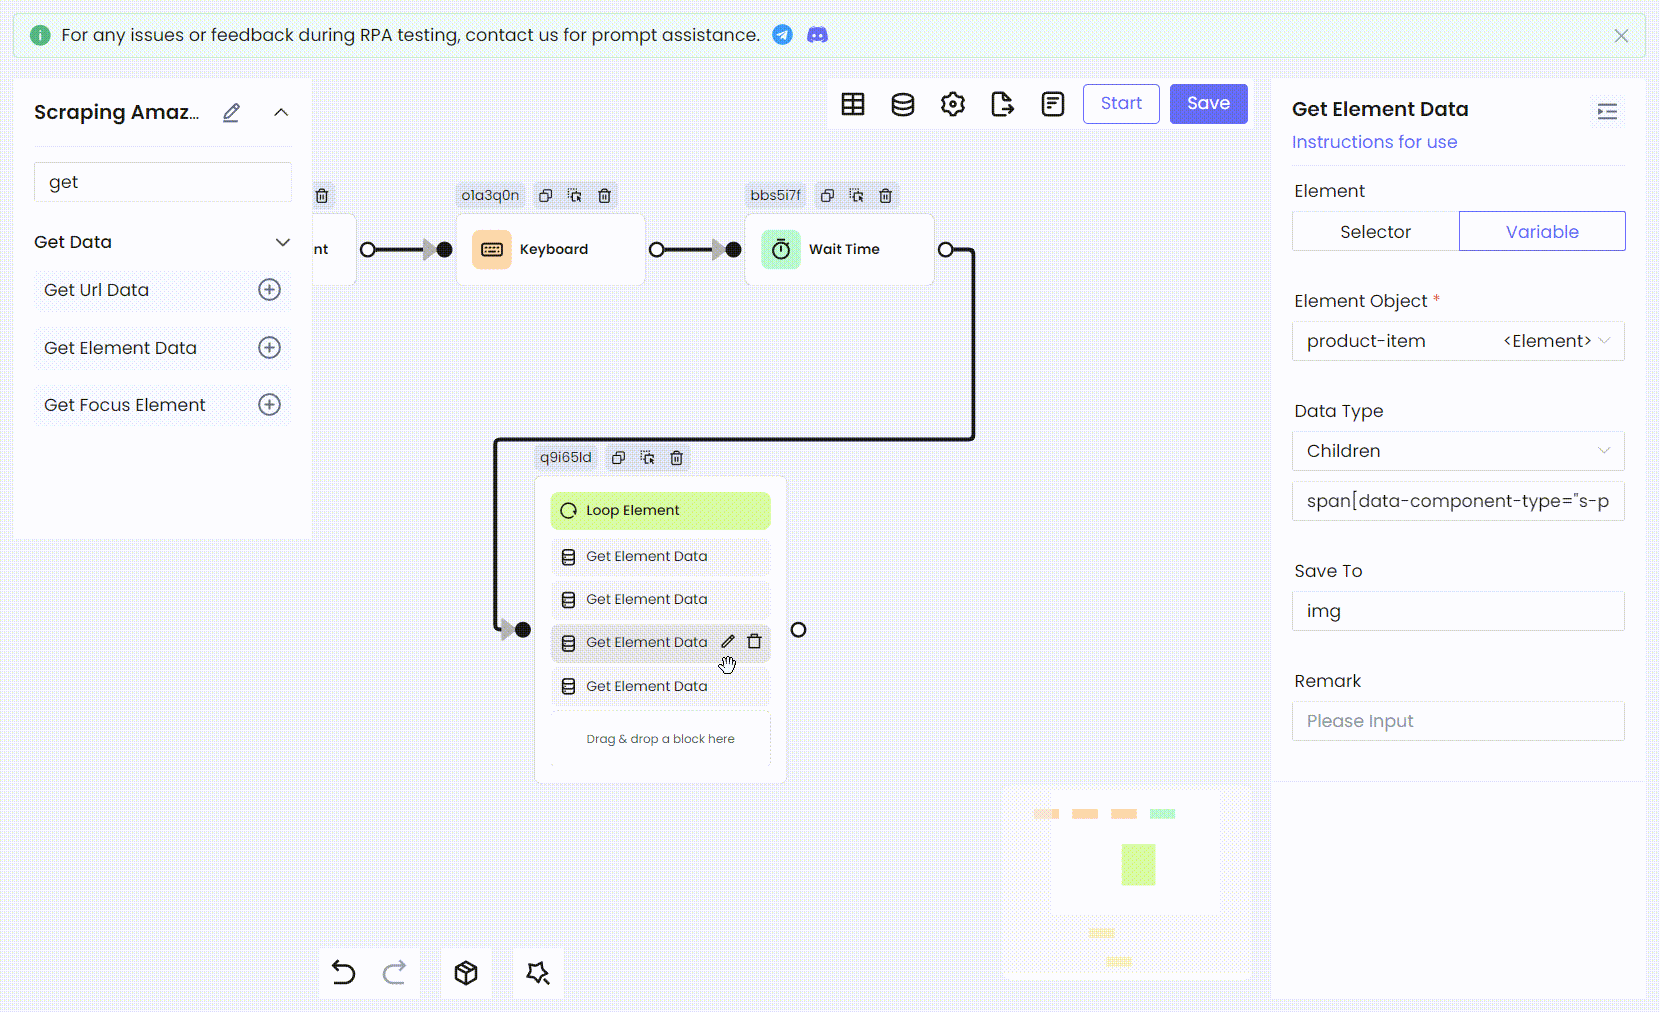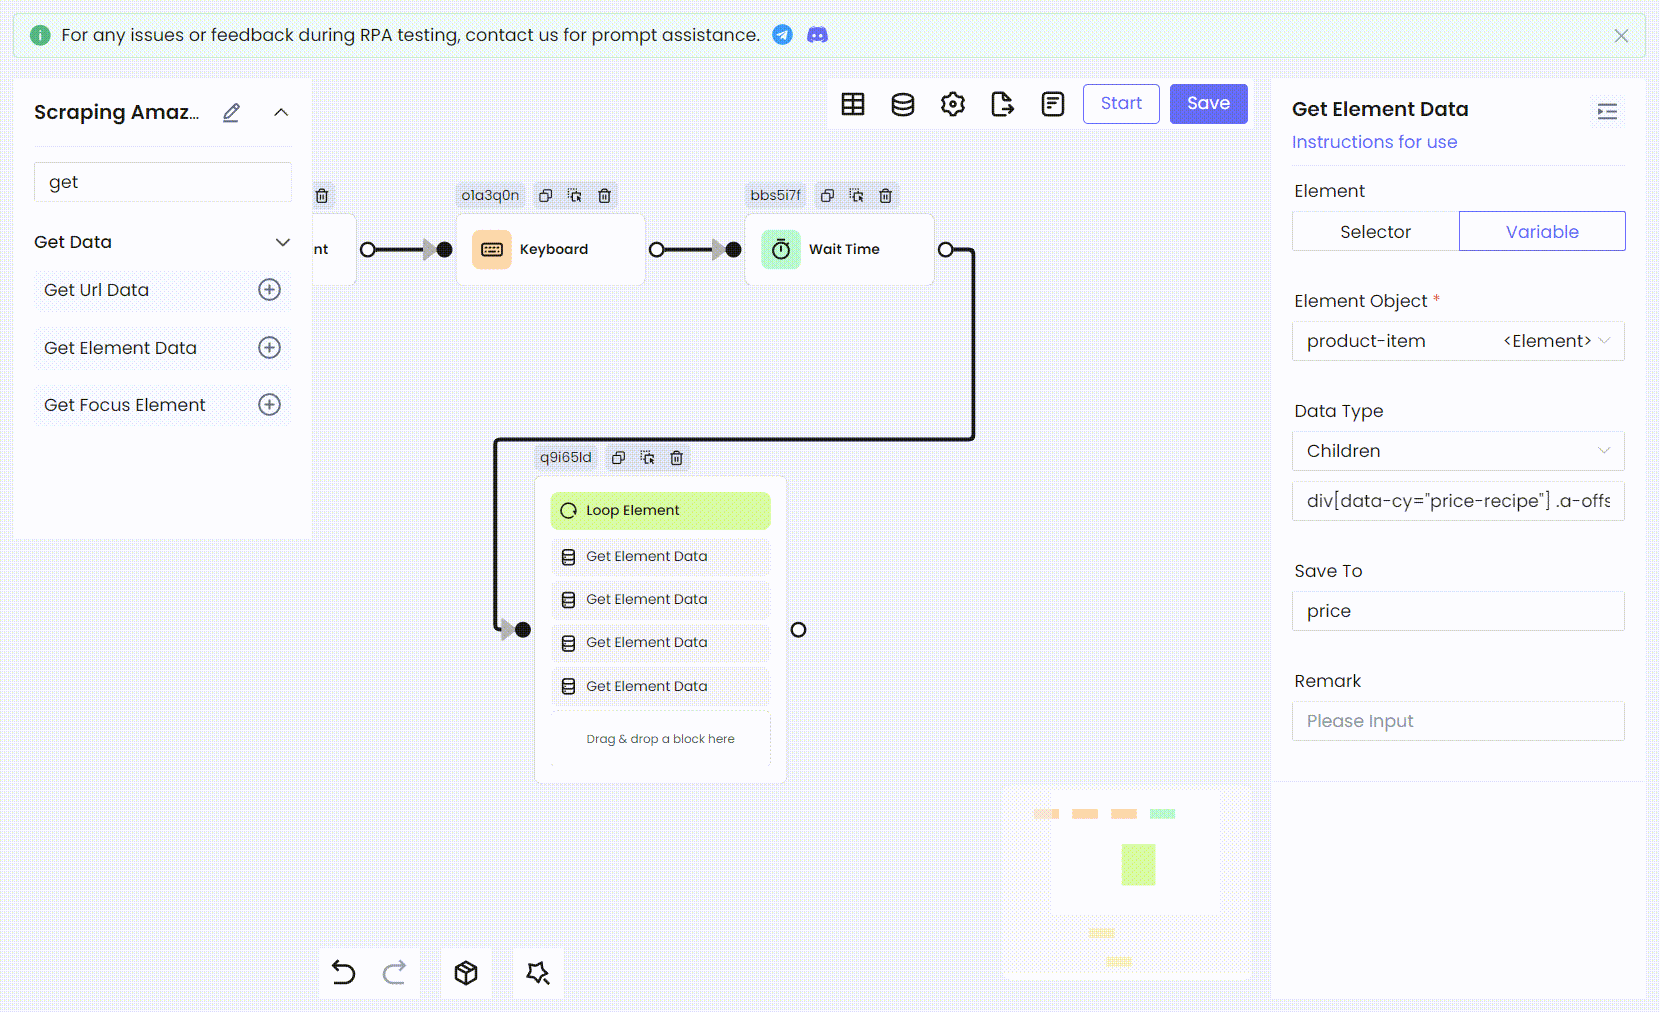
Tuy nhiên, dữ liệu biến thu được ở trên thực chất là các phần tử HTML. Chúng ta vẫn cần xử lý chúng để xuất văn bản trong các phần tử HTML và chuẩn bị cho việc lưu trữ dữ liệu sau này.
- Thiết lập bảng
Chúng ta cần
- Thiết lập bảng
- Và tạo Excel tương ứng dựa trên các trường của bảng này:
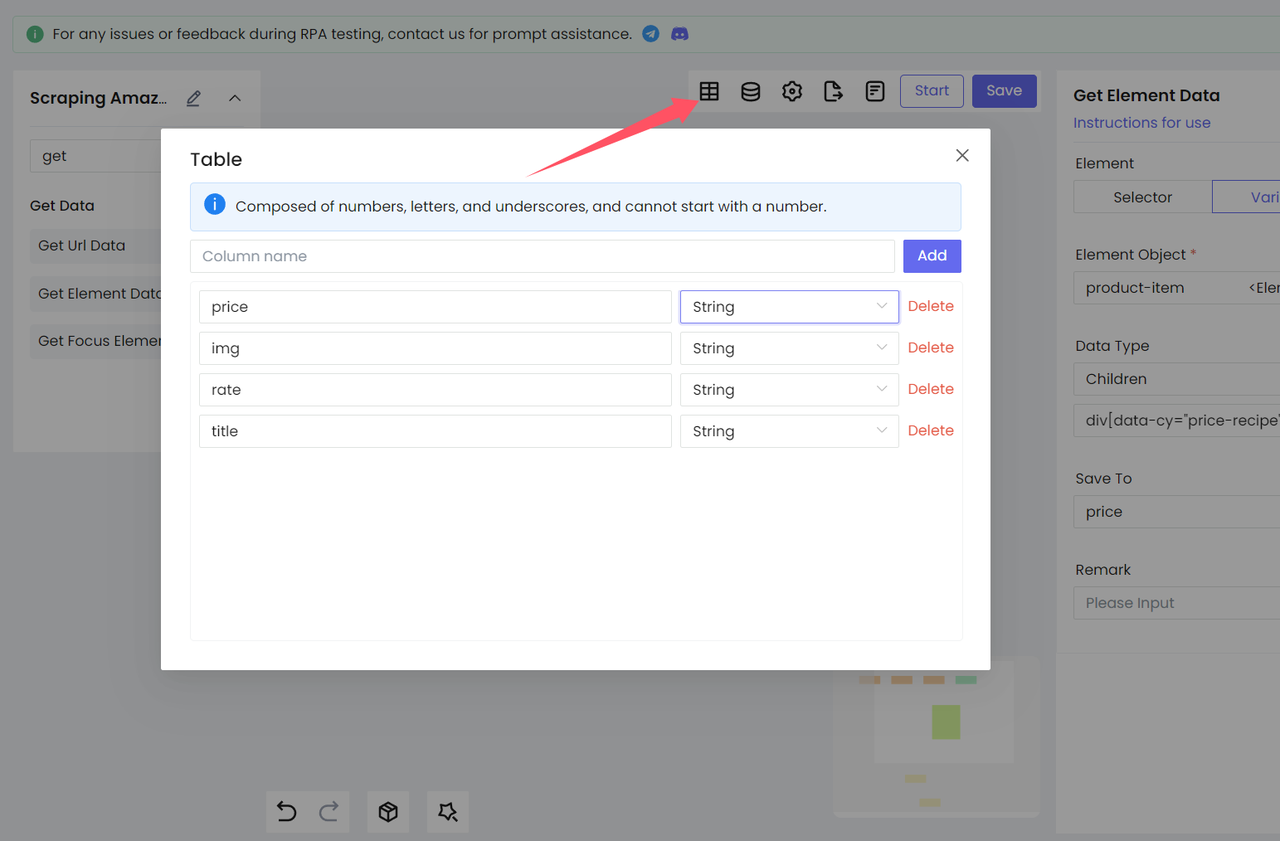
- Lấy văn bản của phần tử
Thêm nút Get Element Data một lần nữa để xuất các biến thu được ở trên dưới dạng văn bản và lưu chúng vào biến bảng để lưu trữ dữ liệu sau này. Chọn Kiểu dữ liệu là Text để lấy innerText của phần tử mục tiêu. (Hình dưới đây cho thấy việc xử lý biến title)
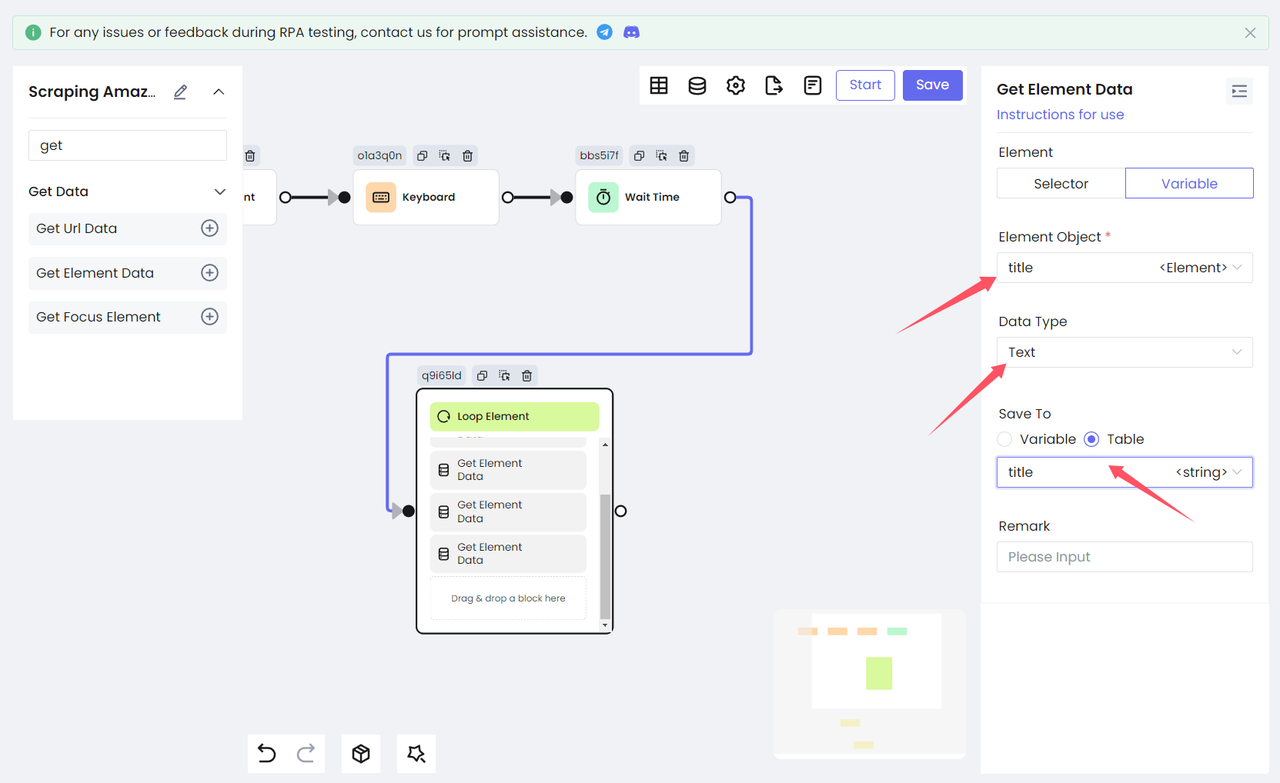
- Lấy liên kết đến hình ảnh
Sau đó, chúng ta sử dụng cùng một phương pháp để chuyển đổi xếp hạng và giá của sản phẩm thành thông tin văn bản cuối cùng.
Liên kết hình ảnh cần xử lý thêm. Ở đây chúng ta sử dụng nút javascript để lấy src hình ảnh của sản phẩm được duyệt hiện tại. Lưu ý rằng biến chỉ mục productIndex được lưu bởi nút Loop Element cần được tiêm vào kịch bản và cuối cùng được lưu dưới dạng biến imgSrc.
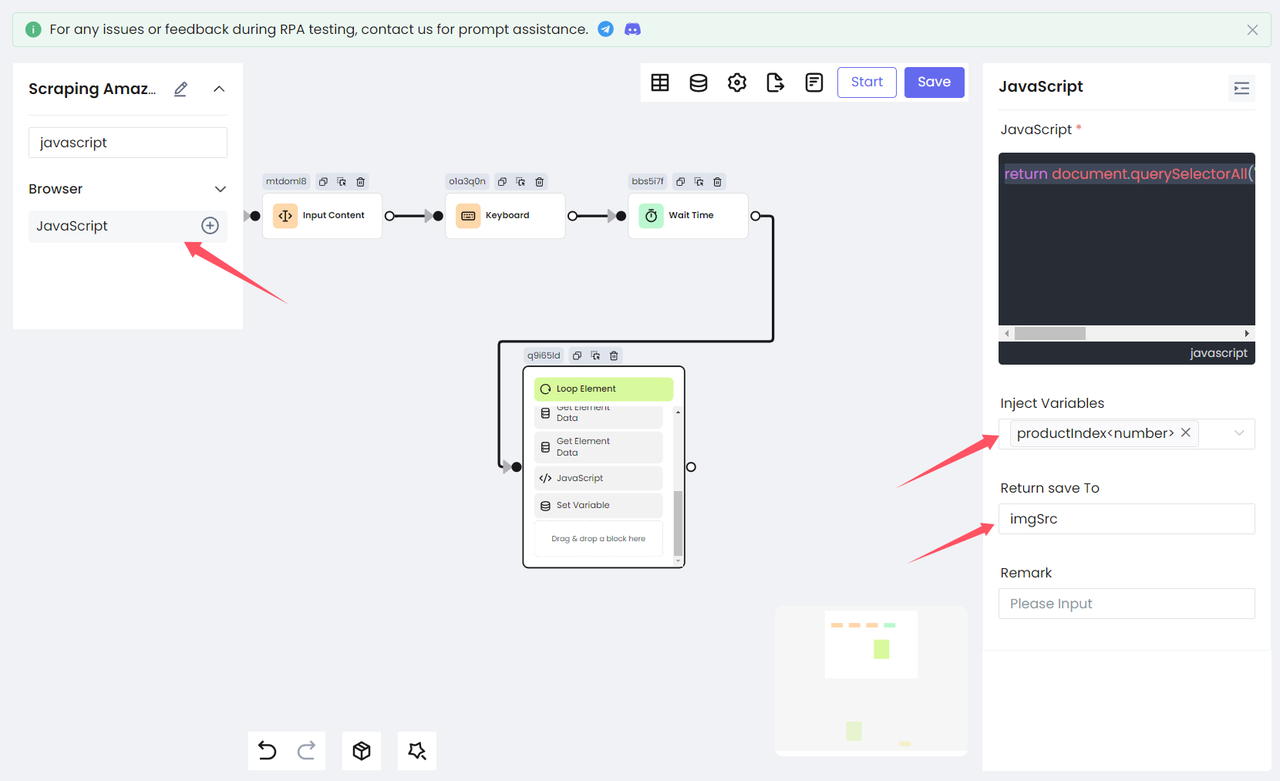
JavaScript
return document.querySelectorAll('[data-image-latency="s-product-image"]')[productIndex].getAttribute('src')Cuối cùng, chúng ta sử dụng nút Set Variable để lưu biến imgSrc trong bảng:

Bước 5. Lưu kết quả
Tại thời điểm này, chúng ta đã thu được tất cả dữ liệu mà chúng ta muốn thu thập, và đã đến lúc lưu trữ dữ liệu này.
- Nstbrowser RPA cung cấp hai cách để lưu dữ liệu:
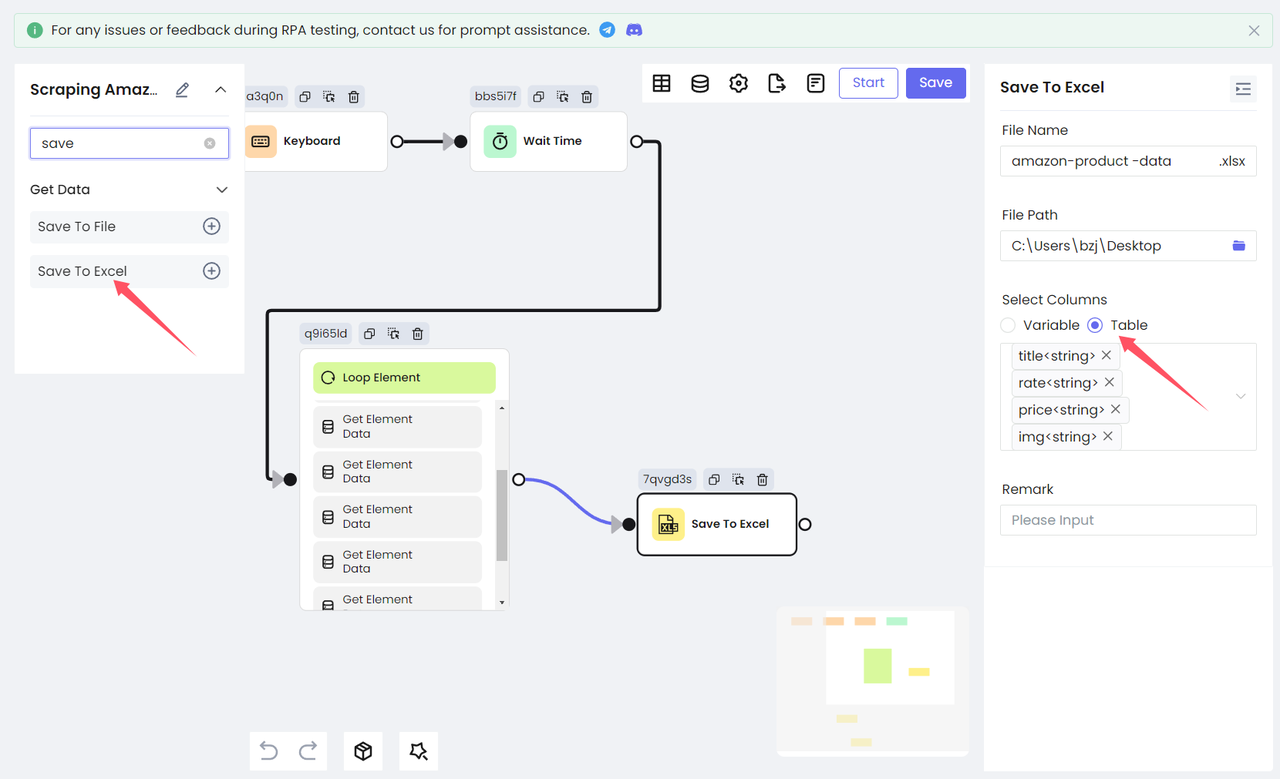
Save To FilevàSave To Excel.
Save To Filecung cấp ba loại tệp để bạn lựa chọn .txt, .CSV và .JSON.Save To Excelchỉ có thể lưu dữ liệu vào tệp Excel.
Để dễ dàng xem, chúng tôi chọn lưu trữ dữ liệu thu thập vào Excel. Thêm nút Save To Excel, cấu hình đường dẫn tệp và tên tệp cần lưu, chọn nội dung bảng cần lưu và bạn đã hoàn thành!
Thực thi RPA
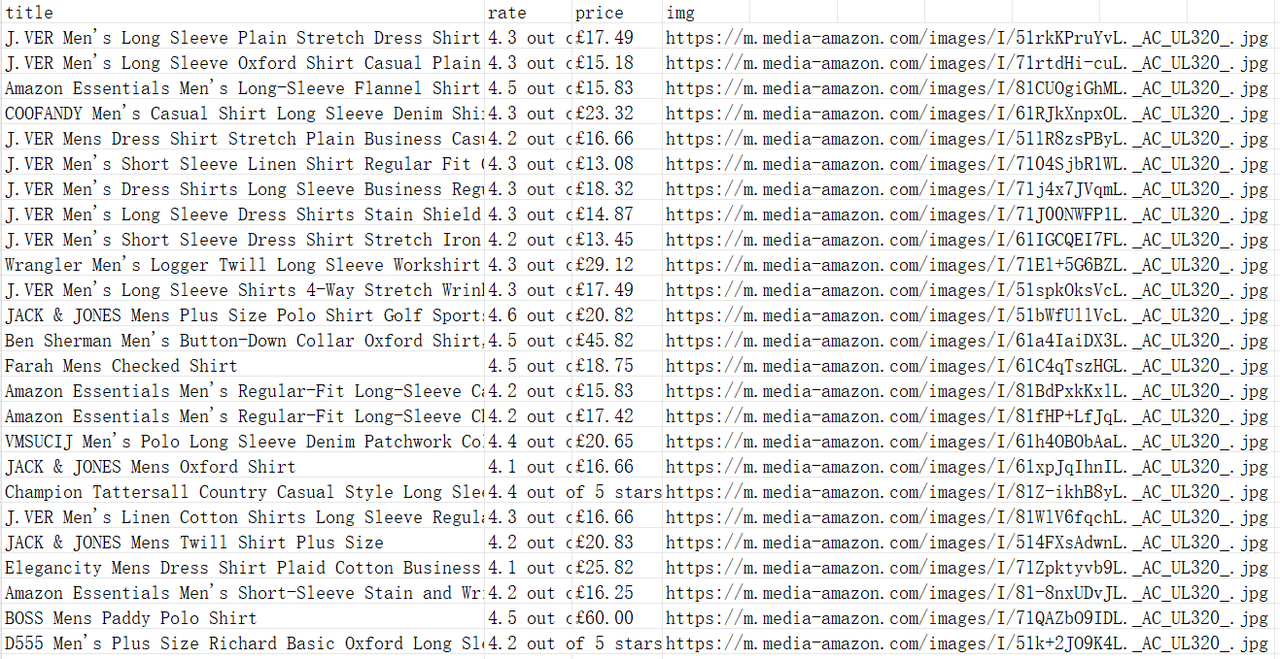
Lưu luồng công việc mà chúng tôi đã cấu hình trước, sau đó bạn có thể chạy nó trực tiếp trên trang hiện tại, hoặc quay lại trang trước, tạo tác vụ mới và nhấp vào nút Run để chạy nó. Tại thời điểm này, chúng ta có thể bắt đầu thu thập dữ liệu sản phẩm của Amazon!
Sau khi thực thi hoàn tất, bạn có thể thấy tệp amazon-product-data.xlsx được tạo trên màn hình nền.
Lời kết
Cách dễ nhất để thu thập sản phẩm Amazon là xây dựng trình thu thập sản phẩm Amazon của riêng bạn bằng cách sử dụng Browserless. Bài viết hướng dẫn toàn diện nhất năm 2024 này giải thích rõ ràng cho bạn:
- Lợi ích của việc thu thập sản phẩm Amazon.
- Chức năng mạnh mẽ của trình thu thập sản phẩm Amazon Browserless.
- Cách tạo trình thu thập dễ dàng hơn bằng cách sử dụng RPA của Nstbrower.
Bạn có đặc biệt quan tâm đến dữ liệu web? Vui lòng xem chợ RPA của chúng tôi. Nstbrowser đã chuẩn bị 20 chương trình RPA mạnh mẽ có thể giải quyết mọi vấn đề của bạn trong mọi khía cạnh.
Nếu bạn có nhu cầu đặc biệt về Browserless, thu thập dữ liệu hoặc tự động hóa, vui lòng liên hệ với chúng tôi kịp thời. Chúng tôi sẵn sàng cung cấp cho bạn dịch vụ tùy chỉnh chất lượng cao.
Lưu ý: Bất kỳ dữ liệu và trang web nào được đề cập trong bài viết này chỉ nhằm mục đích minh họa. Chúng tôi phản đối mạnh mẽ các hoạt động bất hợp pháp và vi phạm. Nếu bạn có bất kỳ câu hỏi hoặc thắc mắc nào, vui lòng liên hệ với chúng tôi ngay lập tức.
Hơn