Browserless
Как делать веб-скрейпинг с помощью Browserless в облаке?
Разблокируйте возможности облачных браузеров! Узнайте, почему Browserless - это ваш идеальный выбор для беспроблемного веб-скрейпинга, и как начать работу в облаке!
Sep 24, 2024Luke Ulyanov
Что такое облачные браузеры?
Облачный браузер — это облачная комбинация веб-браузера с виртуальным контейнером, реализующим концепцию изоляции браузера на удаленном сервере. Разработчики могут автоматизировать веб-браузеры с помощью популярных инструментов, таких как Playwright и Puppeteer для веб-скрапинга и веб-тестирования.
Облачный браузер выполняет команды из сети в безопасном контейнере, отдельно от конечной точки пользователя, и доступен через протокол удаленного отображения. В результате веб-браузеры становятся более централизованными, простыми в управлении, более экономичными, масштабируемыми и защищенными.
Зачем использовать Browserless для скрапинга?
Browserless — это мощное облачное решение для бесшовной автоматизации браузера, веб-скрапинга и тестирования. Основная цель Browserless — упростить и масштабировать задачи автоматизации веб-браузеров, такие как тестирование и скрапинг, и это можно сделать двумя способами:
- Запуск нескольких экземпляров браузера на Docker или Kubernetes.
- Использование существующих прокси-серверов Web Driver, таких как Selenium Grid.
Как выполнять веб-скрапинг с помощью Browserless в облаке?
Шаг 1: Подготовка
Прежде чем начать, нам нужен сервис Browserless. Использование Browserless может решить сложные задачи веб-краулинга и автоматизации в масштабе, и теперь оно достигло полностью управляемого облачного развертывания.
Browserless использует браузероцентричный подход, обеспечивает мощные возможности развертывания без графического интерфейса и обеспечивает более высокую производительность и надежность. Для получения дополнительной информации о Browserless вы можете получить документацию, чтобы узнать больше.
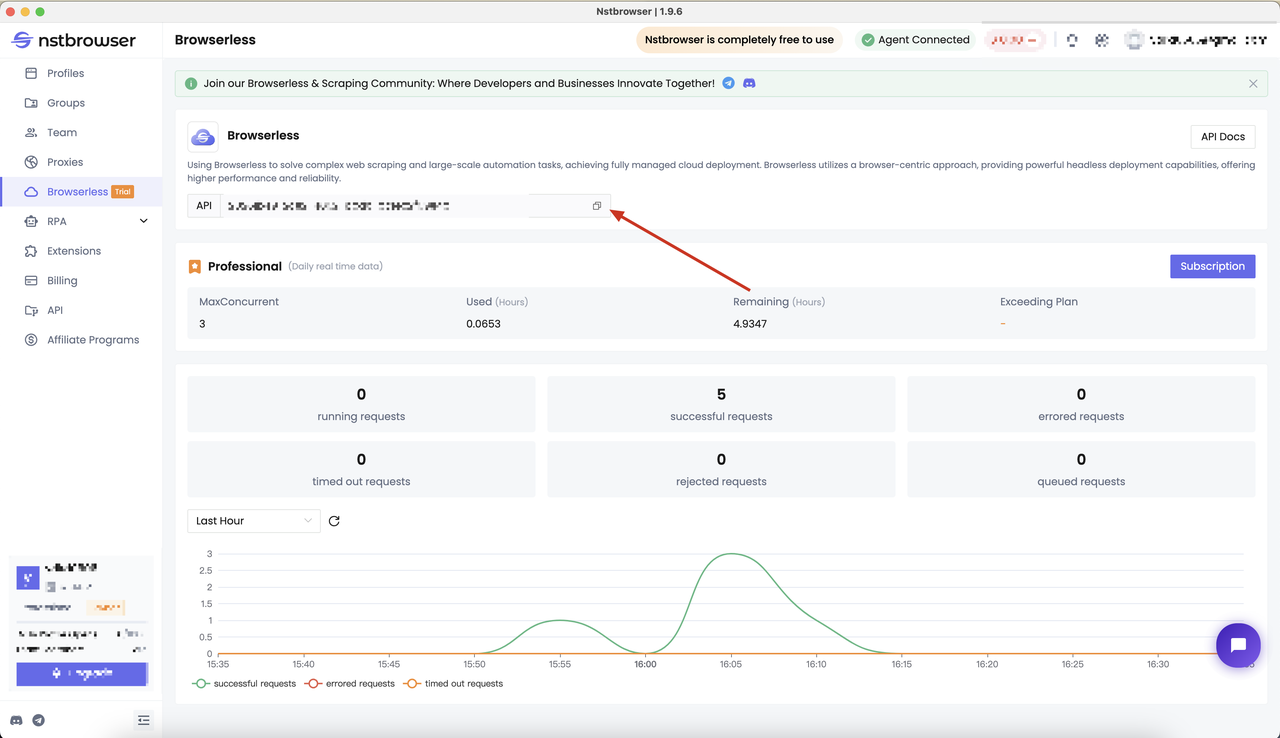
- Получите API KEY и перейдите на страницу меню Browserless в клиенте Nstbrowser, или вы можете перейти к клиенту Nstbrowser, чтобы получить доступ.
Есть ли у вас замечательные идеи и сомнения по поводу веб-скрапинга и Browserless?
Давайте посмотрим, чем делятся другие разработчики на Discord и Telegram!
Шаг 2: Подтвердите целевой сайт для краулинга
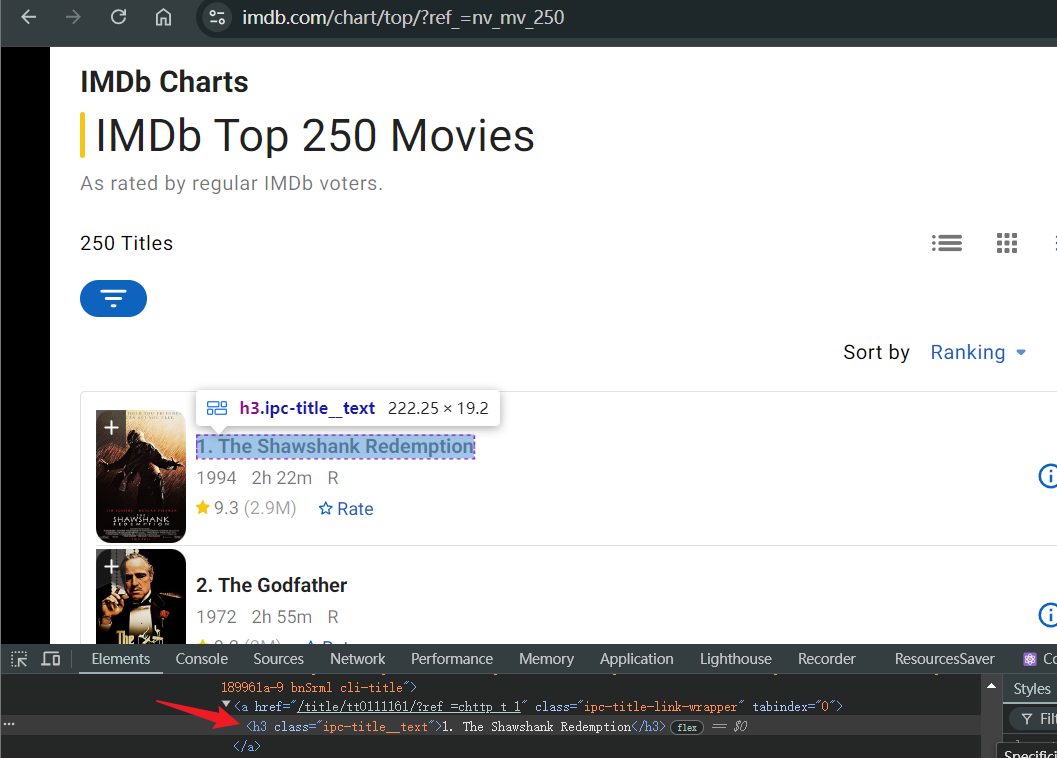
Прежде чем начать, нам нужно убедиться, что мы собираемся краулить. В следующем примере мы попытаемся сканировать названия фильмов в IMDb's Top 250 Movies. После открытия страницы:
- Дождитесь нормальной загрузки страницы и найдите страницу с названием фильма в разделе IMDb Top 250 Movies
- Откройте консоль отладки и определите HTML-элемент названия фильма
- Используйте вашу любимую библиотеку, чтобы получить название фильма
Шаг 3: Начните краулинг
Все готово, начинайте краулинг! Мы решили использовать мощный облачный Browserless, предоставляемый Nstbrowser, чтобы сканировать вышеуказанное содержимое. Ниже мы перечислим некоторые из часто используемых библиотек.
Puppeteer
Если вы еще не выбрали библиотеку, мы настоятельно рекомендуем Puppeteer, так как он очень активен и имеет много разработчиков. Он также создан разработчиками Chrome, поэтому является одной из библиотек самого высокого качества.
- Установите puppeteer-core
Bash
# pnpm
pnpm i puppeteer-core
# yarn
yarn add puppeteer-core
# npm
npm i --save puppeteer-core- Скрипт кода
JavaScript
import puppeteer from "puppeteer-core";

const token = "your api key"; // 'your proxy'

const config = {
  proxy: 'your proxy', // required; input format: schema://user:password@host:port eg: http://user:password@localhost:8080
  // platform: 'windows', // support: windows, mac, linux
  // kernel: 'chromium', // only support: chromium
  // kernelMilestone: '128', // support: 128
  // args: {
  //     "--proxy-bypass-list": "detect.nstbrowser.io"
  // }, // browser args
  // fingerprint: {
  //     userAgent: 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36', // userAgent supportted since v0.15.0
  // },
};

const query = new URLSearchParams({
  token: token, // required
  config: JSON.stringify(config),
});

const browserWSEndpoint = `https://less.nstbrowser.io/connect?${query.toString()}`;
// Connect browserless
const browser = await puppeteer.connect({
  browserWSEndpoint,
  defaultViewport: null,
})
console.info('Connected!');

// Create new page
const page = await browser.newPage()

// Visit IMDb top 250 page
await page.goto('https://www.imdb.com/chart/top/?ref_=nv_mv_250')

// Wait for the movie list to load
await page.waitForSelector('.ipc-metadata-list')

// Get a list of movie titles
const moviesList = await page.$$eval('.ipc-metadata-list h3.ipc-title__text', nodes => nodes.map(node => node.textContent));

console.log('[IMDb Top 250 Movies]===>', moviesList);

// Close browser
await browser.close();
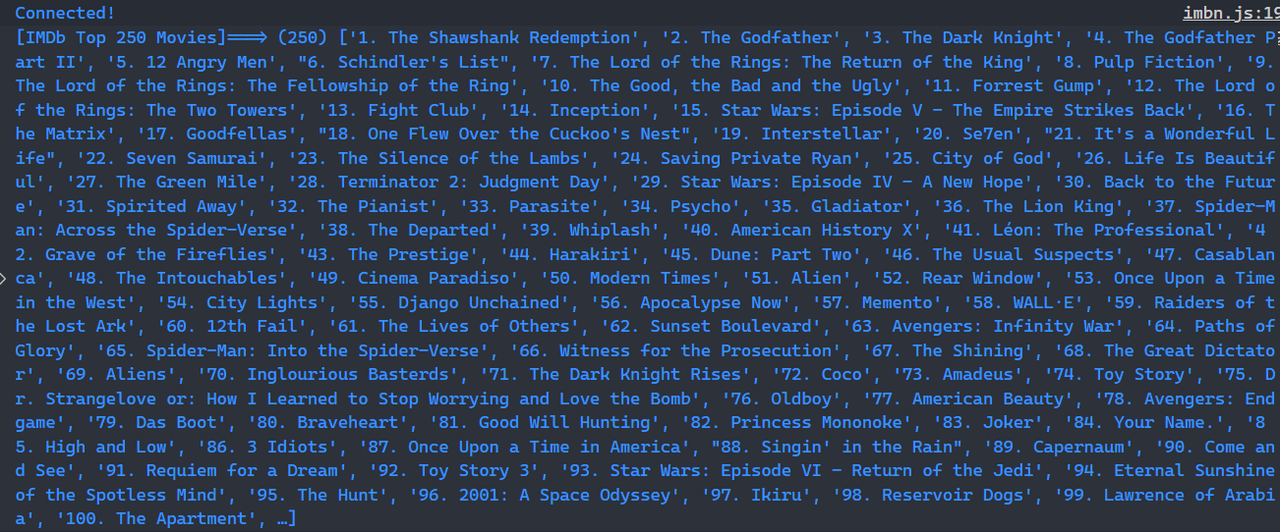
Поздравляем! Мы завершили нашу задачу по скрапингу. Вы можете увидеть результат 250 фильмов в консоли:
Playwright
Это активный проект с открытым исходным кодом с большим количеством участников. Playwright был разработан Microsoft и поддерживает несколько браузеров (Chromium, Firefox и WebKit), а также несколько языков программирования (Nodejs, Python, .NET и Java), что делает его одним из самых универсальных и высококачественных инструментов автоматизации браузеров.
Использование в Nodejs
- Установите Playwright
Bash
# pnpm
pnpm create playwright
# yarn
yarn create playwright
# npm
npm init playwright@latest- Скрипт кода
JavaScript
import { chromium } from 'playwright'

const token = "your api key"; // 'your proxy'

const config = {
  proxy: 'your proxy', // required; input format: schema://user:password@host:port eg: http://user:password@localhost:8080
  // platform: 'windows', // support: windows, mac, linux
  // kernel: 'chromium', // only support: chromium
  // kernelMilestone: '128', // support: 128
  // args: {
  //     "--proxy-bypass-list": "detect.nstbrowser.io"
  // }, // browser args
  // fingerprint: {
  //     userAgent: 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36', // userAgent supportted since v0.15.0
  // },
};

const query = new URLSearchParams({
  token: token, // required
  config: JSON.stringify(config),
});

const browserWSEndpoint = `ws://less.nstbrowser.io/connect?${query.toString()}`;
// Connect browserless
const browser = await chromium.connectOverCDP(browserWSEndpoint);
console.info('Connected!');

// Create new page
const page = await browser.newPage();

// Visit IMDb's top 250 page
await page.goto('https://www.imdb.com/chart/top/?ref_=nv_mv_250');

// Wait for movie list to load
await page.waitForSelector('.ipc-metadata-list');

// Get a list of movie titles
const moviesList = await page.$$eval('.ipc-metadata-list h3.ipc-title__text', nodes => nodes.map(node => node.textContent));

console.log('[IMDb Top 250 Movies]===>', moviesList);

// Close browser
await browser.close();
Здесь мы можем найти списки после запуска нашего проекта:
Использование в Python
- Установите Playwright
Bash
pip install pytest-playwright- Скрипт кода
Python
from playwright.sync_api import sync_playwright
from urllib.parse import urlencode
import json

token = "your api key"  # 'your proxy'

config = {
    "proxy": "your proxy",  # required; input format: schema://user:password@host:port eg: http://user:password@localhost:8080
    # platform: 'windows', // support: windows, mac, linux
    # kernel: 'chromium', // only support: chromium
    # kernelMilestone: '128', // support: 128
    # args: {
    #     "--proxy-bypass-list": "detect.nstbrowser.io"
    # }, // browser args
    # fingerprint: {
    #     userAgent: 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36', // userAgent supportted since v0.15.0
    # },
}

query = urlencode({"token": token, "config": json.dumps(config)})

browser_ws_endpoint = f"ws://less.nstbrowser.io/connect?{query}"

def scrape_imdb_top_250():
    with sync_playwright() as p:
        # Connect browserless
        browser = p.chromium.connect_over_cdp(browser_ws_endpoint)
        print("Connected!")

        # Create new page
        page = browser.new_page()

        # Visit IMDb top 250 page
        page.goto("https://www.imdb.com/chart/top/?ref_=nv_mv_250")

        # Wait for movie list to load
        page.wait_for_selector(".ipc-metadata-list")

        # Get a list of movie titles
        movies_list = page.eval_on_selector_all(
            ".ipc-metadata-list h3.ipc-title__text",
            "nodes => nodes.map(node => node.textContent)",
        )

        print("[IMDb Top 250 Movies]===>", movies_list)

        # Close browser
        browser.close()

scrape_imdb_top_250()
Конечно, вот результат скрапинга:
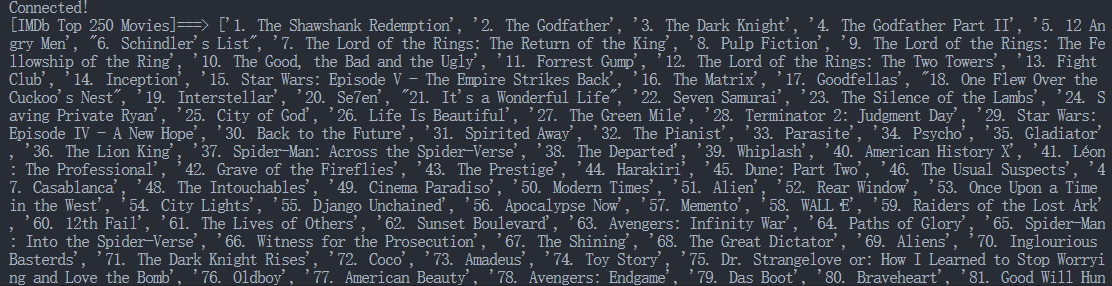
Выберите свой любимый язык и библиотеку, запустите соответствующий скрипт, и вы увидите результаты краулинга!
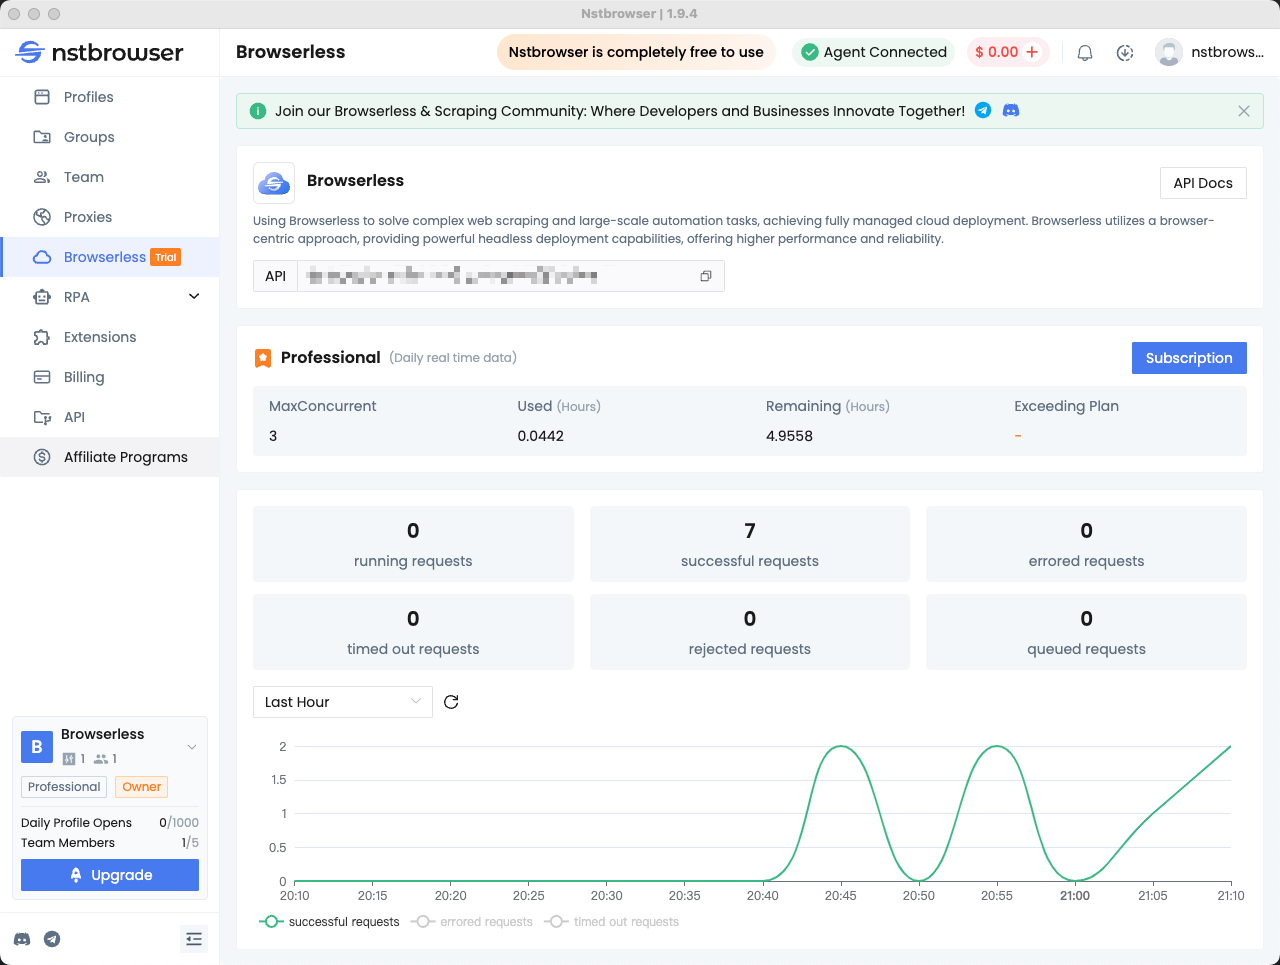
Шаг 4: Просмотр панели управления Browserless
Вы можете просмотреть всю статистику по последним запросам и оставшемуся времени сеанса в меню Browserless в клиенте Nstbrowser.
5 советов по обходу блокировки скрапера с помощью Browserless?
Существуют некоторые ключевые различия между браузерами без графического интерфейса и обычными браузерами. Сервис защиты от ботов обнаруживает браузеры без графического интерфейса, выявляя эти различия.
Обход блокировки скрапера с помощью Browserless включает в себя несколько ключевых стратегий:
- Используйте браузеры без графического интерфейса: Browserless позволяет вам запускать браузеры без графического интерфейса, такие как Puppeteer, которые могут имитировать поведение реальных пользователей и снизить риски обнаружения.
- Поменяйте User Agent: Рандомизация User Agent может помочь избежать блокировки, заставляя ваши запросы казаться исходящими от разных браузеров.
- Реализуйте ротацию прокси: Используйте вращающиеся прокси, чтобы часто менять IP-адреса, минимизируя вероятность блокировки целевыми сайтами.
- Ограничьте запросы: Имитируйте поведение, подобное человеческому, вводя задержки между запросами, предотвращая быстрые запросы, которые запускают меры безопасности.
- Управляйте файлами cookie и сеансами: Правильно обрабатывайте файлы cookie и данные сеанса, чтобы поддерживать непрерывность и избежать обнаружения, поскольку постоянные сеансы реже помечаются.
В чем разница между Browserless и браузером без графического интерфейса?
- Определение:
Browserless: Сервис или платформа, предоставляющая облачную автоматизацию браузера, позволяющая пользователям запускать браузеры без графического интерфейса без управления базовой инфраструктурой.
Браузер без графического интерфейса: Веб-браузер без графического интерфейса (GUI), который можно запускать в среде командной строки, полезный для автоматизации веб-задач.
- Управление:
Browserless: Предлагает управляемые сервисы, абстрагируя сложность настройки и обслуживания экземпляров браузера. Пользователи взаимодействуют с API для запуска задач.
Браузер без графического интерфейса: Требует от пользователей настройки и управления средой браузера, включая зависимости и конфигурации.
- Масштабируемость:
Browserless: Разработан для масштабируемости, позволяя пользователям легко запускать несколько экземпляров браузера параллельно, используя облачные ресурсы.
Браузер без графического интерфейса: Масштабирование может потребовать больше ручной работы, например, управления несколькими экземплярами и серверными ресурсами.
- Сценарии использования:
Browserless: Идеально подходит для разработчиков и команд, которым нужна масштабируемая автоматизация для веб-скрапинга, тестирования и извлечения данных без проблем с инфраструктурой.
Браузер без графического интерфейса: Подходит для разработчиков, которые предпочитают прямой контроль над задачами автоматизации и умеют управлять своей собственной средой.
- Интеграция:
Browserless: Часто предоставляет интеграцию с различными инструментами и сервисами, что упрощает включение в существующие рабочие процессы.
Браузер без графического интерфейса: Требует индивидуальных усилий по интеграции для подключения к другим инструментам или сервисам.
В завершение
Как выполнять веб-скрапинг с помощью Browserless в облаке? Мы уже рассмотрели 4 подробных шага. Просто выберите свою любимую библиотеку, а затем соскребите нужные данные.
Кроме того, мы также узнали, что:
- Что такое облачный браузер?
- Преимущества Browserless
- 5 эффективных способов избежать блокировки
Начните использовать Browserless, чтобы упростить все!
Больше