Browserless
Cómo hacer Web Scraping con Browserless en la nube?
¡Desbloquea el poder de los navegadores en la nube! Descubre por qué Browserless es tu solución ideal para la extracción web sin problemas y aprende cómo empezar en la nube.
Sep 24, 2024Robin Brown
¿Qué son los navegadores en la nube?
Cloud Browser es una combinación basada en la nube de una aplicación de navegador web con un contenedor virtualizado que implementa el concepto de aislamiento de navegador remoto. Los desarrolladores pueden automatizar los navegadores web utilizando herramientas populares como Playwright y Puppeteer para el raspado web y las pruebas web.
Cloud Browser ejecuta comandos desde la red en un contenedor seguro, separado del punto final del usuario, y se accede a él a través de un protocolo de visualización remoto. Como resultado, las aplicaciones de navegador son más centralizadas, más fáciles de administrar, más rentables, escalables y protegidas.
¿Por qué raspar con Browserless?
Browserless es una poderosa solución basada en la nube para la automatización de navegadores fluida, el raspado web y las pruebas. El objetivo principal de Browserless es simplificar y escalar las tareas de automatización del navegador web, como las pruebas y el raspado, y esto se puede abordar de dos maneras:
- Ejecutar múltiples instancias de navegador en Docker o Kubernetes.
- Utilizar servidores proxy de Web Driver existentes como Selenium Grid.
¿Cómo hacer raspado web con Browserless en la nube?
Paso 1: Preparación
Antes de comenzar, necesitamos tener un servicio Browserless. El uso de Browserless puede resolver tareas complejas de rastreo web y automatización a gran escala, y ahora ha logrado una implementación en la nube totalmente administrada.
Browserless adopta un enfoque centrado en el navegador, proporciona potentes capacidades de implementación sin cabeza y ofrece un rendimiento y confiabilidad más altos. Para obtener más información sobre Browserless, puede obtener el documento para obtener más información.
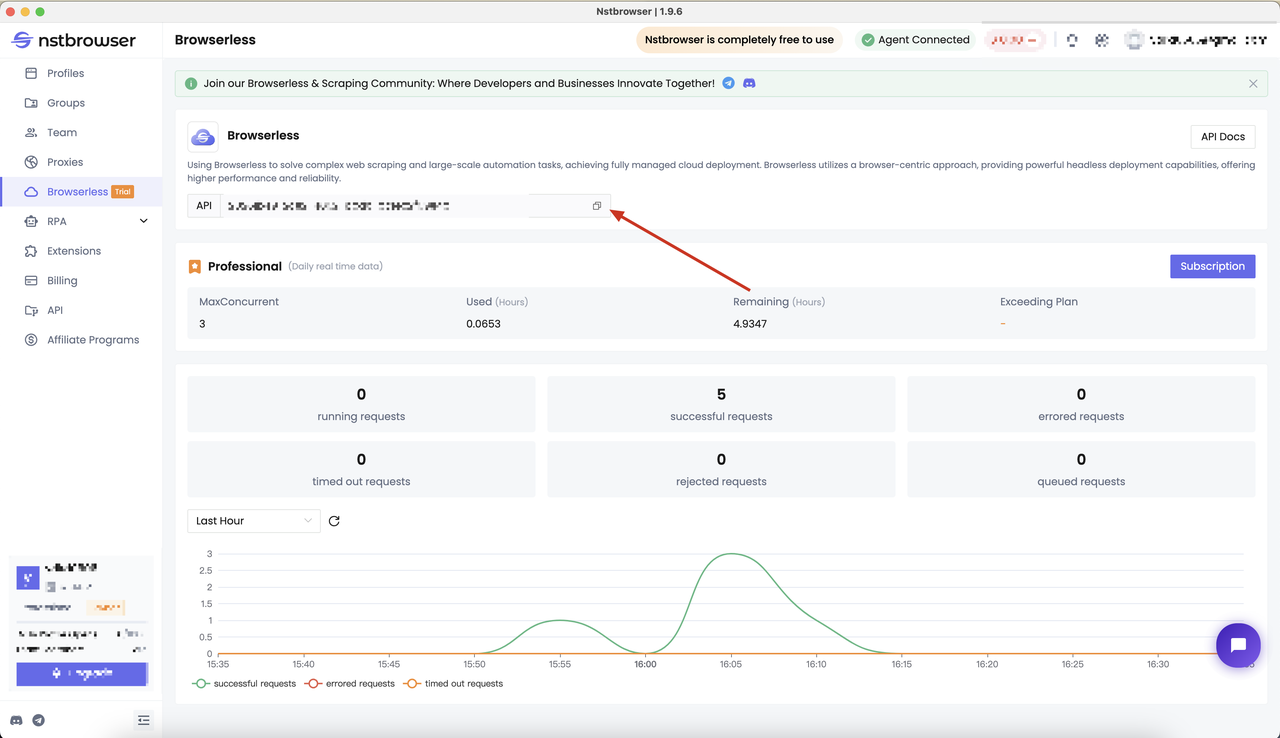
- Obtenga la CLAVE API y vaya a la página del menú Browserless del cliente Nstbrowser, o puede ir al cliente Nstbrowser para acceder
¿Tiene alguna idea maravillosa y duda sobre el raspado web y Browserless?
¡Veamos lo que otros desarrolladores están compartiendo en Discord y Telegram!
Paso 2: Confirmar el objetivo de rastreo
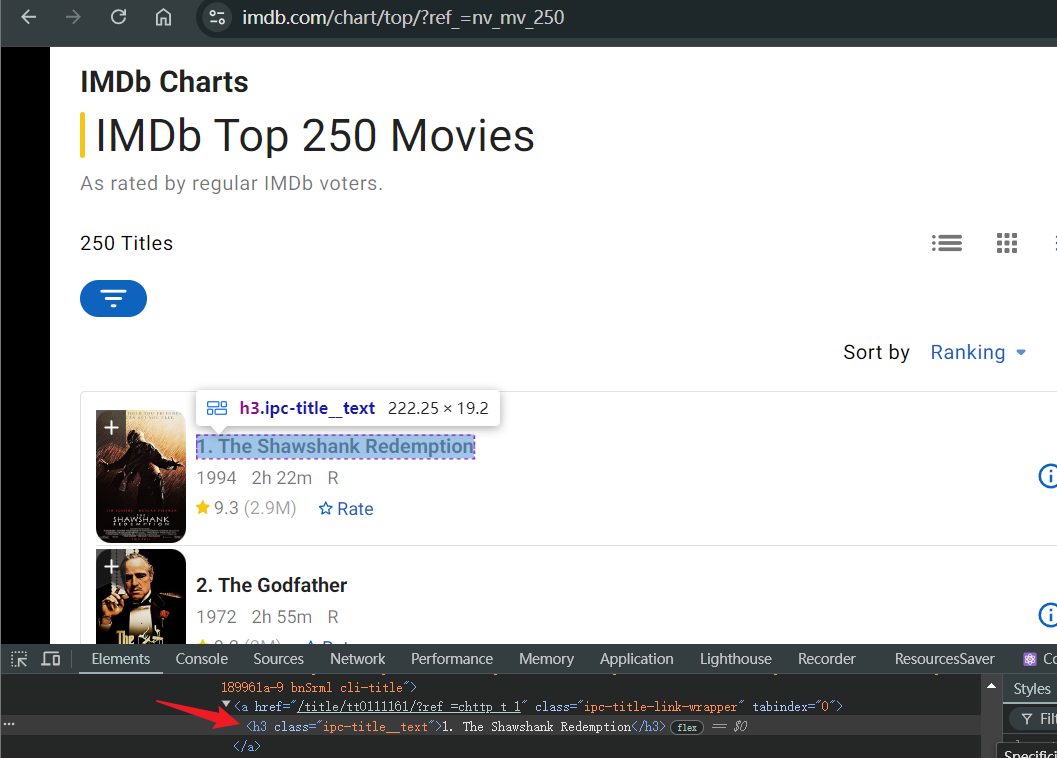
Antes de comenzar, debemos asegurarnos de lo que vamos a rastrear. En el siguiente ejemplo, intentamos rastrear los títulos de las películas en IMDb's Top 250 Películas. Después de abrir la página:
- Espere a que la página se cargue normalmente y ubique la página al título de la película en IMDb Top 250 Movies
- Abra la consola de depuración e identifique el elemento html del título de la película
- Utilice su biblioteca favorita para obtener el título de la película
Paso 3: Comenzar a rastrear
¡Todo está listo, comience a rastrear! Elegimos utilizar el poderoso Browserless en la nube proporcionado por Nstbrowser para rastrear el contenido anterior. A continuación, enumeraremos algunas de las bibliotecas comunes que se utilizan juntas.
Puppeteer
Si aún no ha elegido una biblioteca, le recomendamos encarecidamente Puppeteer porque es muy activa y tiene muchos mantenedores. También está construido por los desarrolladores de Chrome, por lo que es una de las bibliotecas de mayor calidad.
- Instalar puppeteer-core
Bash
# pnpm
pnpm i puppeteer-core
# yarn
yarn add puppeteer-core
# npm
npm i --save puppeteer-core- Guion de código
JavaScript
import puppeteer from "puppeteer-core";

const token = "su clave api"; // 'su proxy'

const config = {
  proxy: 'su proxy', // requerido; formato de entrada: schema://user:password@host:port p. ej.: http://user:password@localhost:8080
  // platform: 'windows', // soporte: windows, mac, linux
  // kernel: 'chromium', // solo admite: chromium
  // kernelMilestone: '128', // soporte: 128
  // args: {
  //     "--proxy-bypass-list": "detect.nstbrowser.io"
  // }, // argumentos del navegador
  // fingerprint: {
  //     userAgent: 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36', // userAgent admitido desde la v0.15.0
  // },
};

const query = new URLSearchParams({
  token: token, // requerido
  config: JSON.stringify(config),
});

const browserWSEndpoint = `https://less.nstbrowser.io/connect?${query.toString()}`;
// Conectar browserless
const browser = await puppeteer.connect({
  browserWSEndpoint,
  defaultViewport: null,
})
console.info('¡Conectado!');

// Crear una nueva página
const page = await browser.newPage()

// Visitar la página de las 250 mejores de IMDb
await page.goto('https://www.imdb.com/chart/top/?ref_=nv_mv_250')

// Espere a que la lista de películas se cargue
await page.waitForSelector('.ipc-metadata-list')

// Obtenga una lista de títulos de películas
const moviesList = await page.$$eval('.ipc-metadata-list h3.ipc-title__text', nodes => nodes.map(node => node.textContent));

console.log('[Películas de las 250 mejores de IMDb]===>', moviesList);

// Cerrar el navegador
await browser.close();
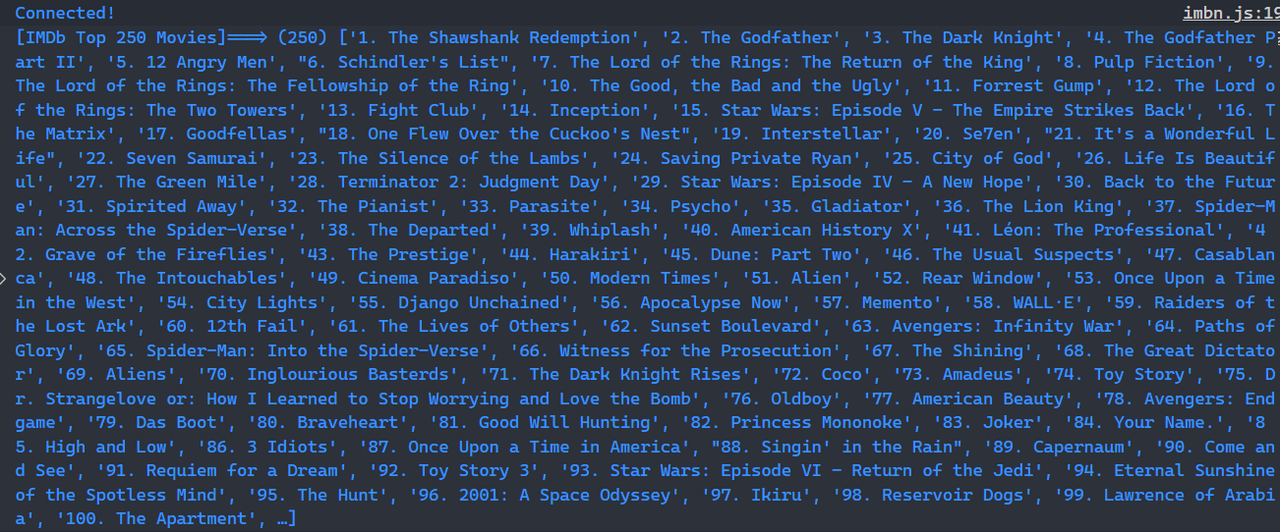
¡Felicidades! Hemos terminado nuestra tarea de raspado. Puede ver el resultado de 250 películas en la consola:
Playwright
Es un proyecto de código abierto activo con un gran número de colaboradores. Playwright fue desarrollado por Microsoft y admite múltiples navegadores (Chromium, Firefox y WebKit) y múltiples lenguajes de programación (Nodejs, Python, .NET y Java), lo que lo convierte en una de las herramientas de automatización de navegadores más versátiles y de alta calidad.
Utilizar en Nodejs
- Instalar Playwright
Bash
# pnpm
pnpm create playwright
# yarn
yarn create playwright
# npm
npm init playwright@latest- Guion de código
JavaScript
import { chromium } from 'playwright'

const token = "su clave api"; // 'su proxy'

const config = {
  proxy: 'su proxy', // requerido; formato de entrada: schema://user:password@host:port p. ej.: http://user:password@localhost:8080
  // platform: 'windows', // soporte: windows, mac, linux
  // kernel: 'chromium', // solo admite: chromium
  // kernelMilestone: '128', // soporte: 128
  // args: {
  //     "--proxy-bypass-list": "detect.nstbrowser.io"
  // }, // argumentos del navegador
  // fingerprint: {
  //     userAgent: 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36', // userAgent admitido desde la v0.15.0
  // },
};

const query = new URLSearchParams({
  token: token, // requerido
  config: JSON.stringify(config),
});

const browserWSEndpoint = `ws://less.nstbrowser.io/connect?${query.toString()}`;
// Conectar browserless
const browser = await chromium.connectOverCDP(browserWSEndpoint);
console.info('¡Conectado!');

// Crear una nueva página
const page = await browser.newPage();

// Visitar la página de las 250 mejores de IMDb
await page.goto('https://www.imdb.com/chart/top/?ref_=nv_mv_250');

// Espere a que se cargue la lista de películas
await page.waitForSelector('.ipc-metadata-list');

// Obtenga una lista de títulos de películas
const moviesList = await page.$$eval('.ipc-metadata-list h3.ipc-title__text', nodes => nodes.map(node => node.textContent));

console.log('[Películas de las 250 mejores de IMDb]===>', moviesList);

// Cerrar el navegador
await browser.close();
Aquí podemos averiguar las listas después de ejecutar nuestro proyecto:
Utilizar en Python
- Instalar Playwright
Bash
pip install pytest-playwright- Guion de código
Python
from playwright.sync_api import sync_playwright
from urllib.parse import urlencode
import json

token = "su clave api"  # 'su proxy'

config = {
    "proxy": "su proxy",  # requerido; formato de entrada: schema://user:password@host:port p. ej.: http://user:password@localhost:8080
    # platform: 'windows', // soporte: windows, mac, linux
    # kernel: 'chromium', // solo admite: chromium
    # kernelMilestone: '128', // soporte: 128
    # args: {
    #     "--proxy-bypass-list": "detect.nstbrowser.io"
    # }, // argumentos del navegador
    # fingerprint: {
    #     userAgent: 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36', // userAgent admitido desde la v0.15.0
    # },
}

query = urlencode({"token": token, "config": json.dumps(config)})

browser_ws_endpoint = f"ws://less.nstbrowser.io/connect?{query}"

def scrape_imdb_top_250():
    with sync_playwright() as p:
        # Conectar browserless
        browser = p.chromium.connect_over_cdp(browser_ws_endpoint)
        print("¡Conectado!")

        # Crear una nueva página
        page = browser.new_page()

        # Visitar la página de las 250 mejores de IMDb
        page.goto("https://www.imdb.com/chart/top/?ref_=nv_mv_250")

        # Espere a que se cargue la lista de películas
        page.wait_for_selector(".ipc-metadata-list")

        # Obtenga una lista de títulos de películas
        movies_list = page.eval_on_selector_all(
            ".ipc-metadata-list h3.ipc-title__text",
            "nodes => nodes.map(node => node.textContent)",
        )

        print("[Películas de las 250 mejores de IMDb]===>", movies_list)

        # Cerrar el navegador
        browser.close()

scrape_imdb_top_250()
Por supuesto, el siguiente es el resultado del raspado:
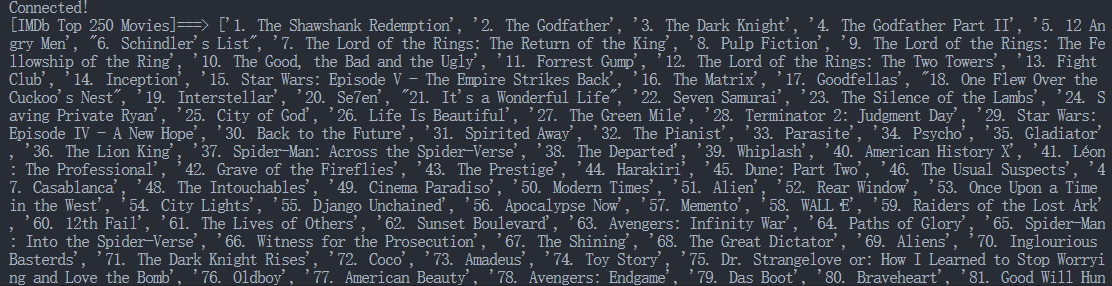
¡Seleccione su idioma y biblioteca favoritos, ejecute el script correspondiente y podrá ver los resultados rastreados!
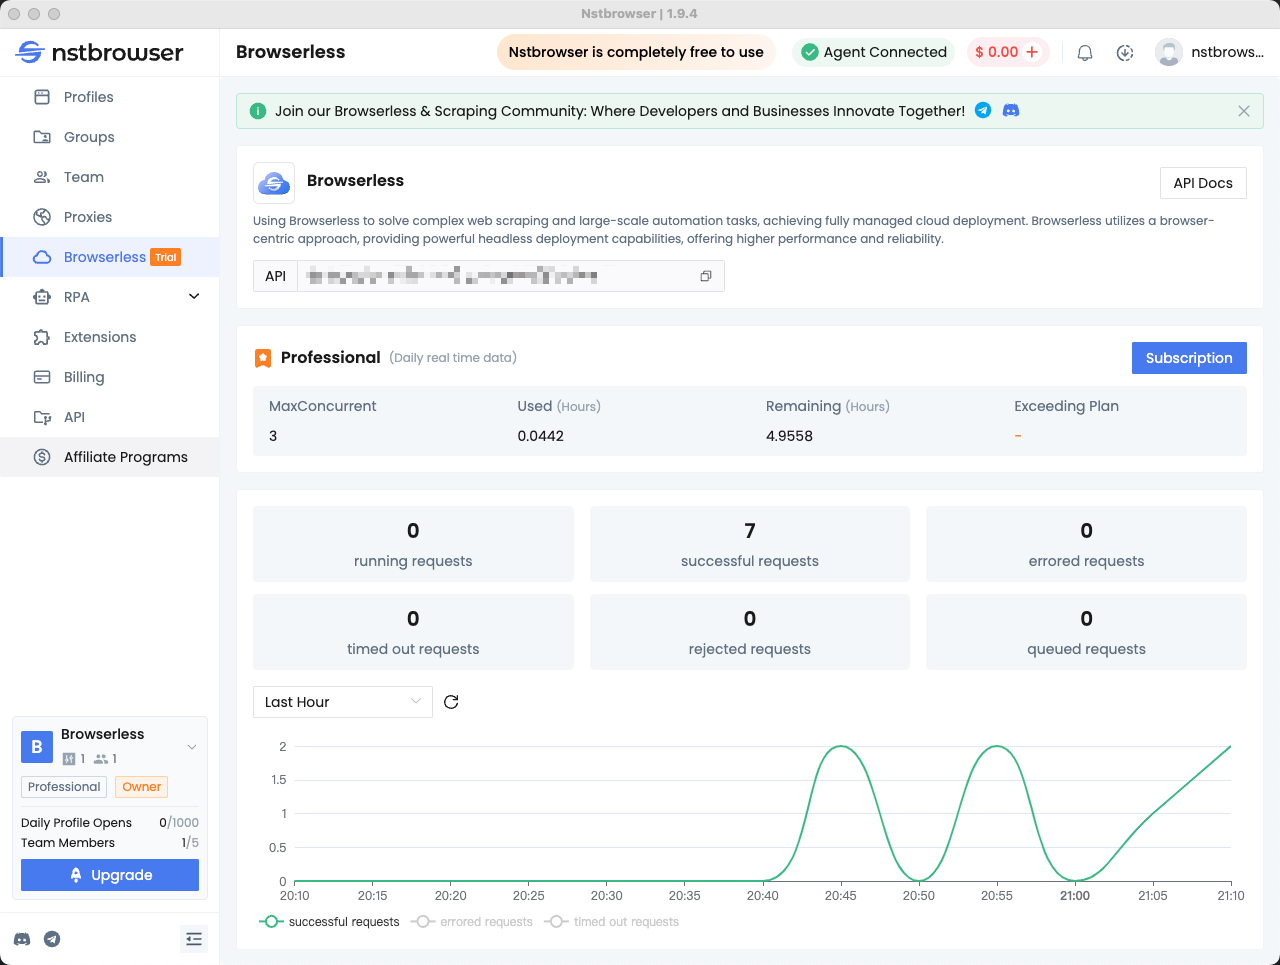
Paso 4: Ver el panel de Browserless
Puede ver todas las estadísticas para las solicitudes recientes y el tiempo de sesión restante en el menú Browserless del cliente Nstbrowser.
5 consejos para omitir el bloqueo de raspadores con Browserless?
Hay algunas diferencias clave entre los navegadores sin cabeza y los navegadores normales. El servicio anti-bot detecta los navegadores sin cabeza al detectar estas diferencias.
Omitir el bloqueo de raspadores con Browserless implica varias estrategias clave:
- Utilizar navegadores sin cabeza: Browserless le permite ejecutar navegadores sin cabeza como Puppeteer, que pueden imitar el comportamiento del usuario real y reducir los riesgos de detección.
- Rotar los agentes de usuario: La aleatorización de los agentes de usuario puede ayudar a evitar el bloqueo haciendo que sus solicitudes parezcan provenir de diferentes navegadores.
- Implementar la rotación de proxy: Utilice proxies rotativos para cambiar las direcciones IP con frecuencia, minimizando las posibilidades de ser bloqueado por los sitios web de destino.
- Acelerar las solicitudes: Imite el comportamiento de navegación similar al humano introduciendo demoras entre las solicitudes, evitando solicitudes de disparo rápido que activan las medidas de seguridad.
- Gestionar las cookies y las sesiones: Maneje adecuadamente las cookies y los datos de sesión para mantener la continuidad y evitar la detección, ya que las sesiones persistentes tienen menos probabilidades de ser marcadas.
¿Cuáles son las diferencias entre Browserless y el navegador sin cabeza?
- Definición:
Browserless: un servicio o plataforma que proporciona automatización de navegadores basada en la nube, lo que permite a los usuarios ejecutar navegadores sin cabeza sin administrar la infraestructura subyacente.
Navegador sin cabeza: un navegador web sin interfaz gráfica de usuario (GUI) que se puede ejecutar en un entorno de línea de comandos, útil para automatizar tareas web.
- Gestión:
Browserless: ofrece servicios administrados, abstraendo la complejidad de configurar y mantener instancias de navegador. Los usuarios interactúan con una API para iniciar tareas.
Navegador sin cabeza: requiere que los usuarios configuren y administren el entorno del navegador, incluidas las dependencias y las configuraciones.
- Escalabilidad:
Browserless: diseñado para la escalabilidad, lo que permite a los usuarios ejecutar múltiples instancias de navegador en paralelo fácilmente, aprovechando los recursos en la nube.
Navegador sin cabeza: la escalabilidad puede implicar más trabajo manual, como la administración de múltiples instancias y recursos del servidor.
- Casos de uso:
Browserless: ideal para desarrolladores y equipos que necesitan automatización escalable para el raspado web, las pruebas y la extracción de datos sin preocuparse por la infraestructura.
Navegador sin cabeza: adecuado para desarrolladores que prefieren el control directo sobre sus tareas de automatización y se sienten cómodos administrando su propio entorno.
- Integración:
Browserless: a menudo proporciona integraciones con varias herramientas y servicios, lo que facilita la incorporación en los flujos de trabajo existentes.
Navegador sin cabeza: requiere esfuerzos de integración personalizados para conectarse con otras herramientas o servicios.
Para concluir
¿Cómo hacer raspado web con browserless en la nube? Ya hemos explorado 4 pasos detallados. Simplemente elija su biblioteca favorita y luego raspe los datos que necesita.
Además, también hemos aprendido que:
- ¿Qué es un navegador en la nube?
- Beneficios de Browserless
- 5 eficaz para evitar el bloqueo
¡Empiece a utilizar Browserless para simplificar todo!
Más