Browserless
Как парсить результаты изображений Яндекса с помощью Playwright и Browserless?
Скрапинг данных с поиска картинок Яндекса действительно сложен. Тем не менее, эффективные шаги и код в этой статье помогут вам легко извлечь содержимое.
Oct 24, 2024Luke Ulyanov
Что такое Яндекс?
Яндекс — это российская многонациональная компания, наиболее известная своим поисковиком, который является одним из крупнейших в стране. Помимо поисковых возможностей, Яндекс предоставляет ряд других сервисов. Кроме того, Яндекс предлагает Яндекс Картинки, который позволяет искать фотографии по ключевым словам.
Результаты поиска изображений в Яндексе несколько отличаются от результатов Google и Bing. Яндекс Картинки также поддерживает множество фильтров, включая размер, ориентацию, тип, цвет, формат, новизна и обои.
Тысячи фотографий можно получить для различных целей, включая маркетинг, брендинг, исследования, обучение и творчество.
Парсинг Яндекса очень сложен!
Яндекс использует передовые антибот-меры, предназначенные для обнаружения и блокировки автоматизированных запросов. Это включает в себя внедрение CAPTCHA и строгие ограничения скорости IP-адресов, которые могут затруднить парсинг.
На многих страницах Яндекса представлен динамический контент, который загружается с помощью JavaScript. Это означает, что простые методы парсинга могут не захватывать всю необходимую информацию, что требует использования более сложных инструментов, таких как headless-браузеры.
Кроме того, Яндекс часто обновляет свои алгоритмы и структуру своих страниц. Эта постоянная эволюция может привести к сбою сценариев парсинга, требуя регулярного обслуживания и настройки.
Необходимо учитывать юридические аспекты, поскольку парсинг может нарушать условия обслуживания Яндекса, что может привести к юридическим последствиям для пользователей.
Огромное количество данных, доступных на Яндексе, означает, что эффективная обработка данных имеет важное значение, что добавляет еще один уровень сложности процессу парсинга.
Сочетание этих факторов делает парсинг Яндекса сложной задачей, требующей тщательного планирования и выполнения.
Почему Browserless отлично подходит для парсинга Яндекс Картинок?
Browserless от Nstbrowser — это типичный облачный сервис Headless Chrome, который запускает онлайн-приложения и автоматизирует сценарии без графического интерфейса. Он особенно полезен для задач, таких как веб-парсинг и другие автоматизированные операции.
Nstbrowser интегрирует антидетект, веб-разблокировщик и безголовые функции в Browserless. Browserless абсолютно бесплатен для тестирования. В нашей документации вы найдете более подробную информацию.
Есть ли у вас замечательные идеи или сомнения по поводу веб-парсинга и Browserless?
Давайте посмотрим, чем делятся другие разработчики на Discord!
Как парсить результаты Яндекс Картинок?
Настройка среды
В самом начале нам следует подготовить наш сервис Browserless. Browserless может помочь решить сложные задачи веб-сканирования и масштабной автоматизации, а также реализовать полностью управляемое облачное развертывание.
- Browserless использует браузерно-ориентированный подход, предлагает надежные функции безголового развертывания и обеспечивает повышенную надежность и скорость. Узнайте больше в нашей документации по Browserless.
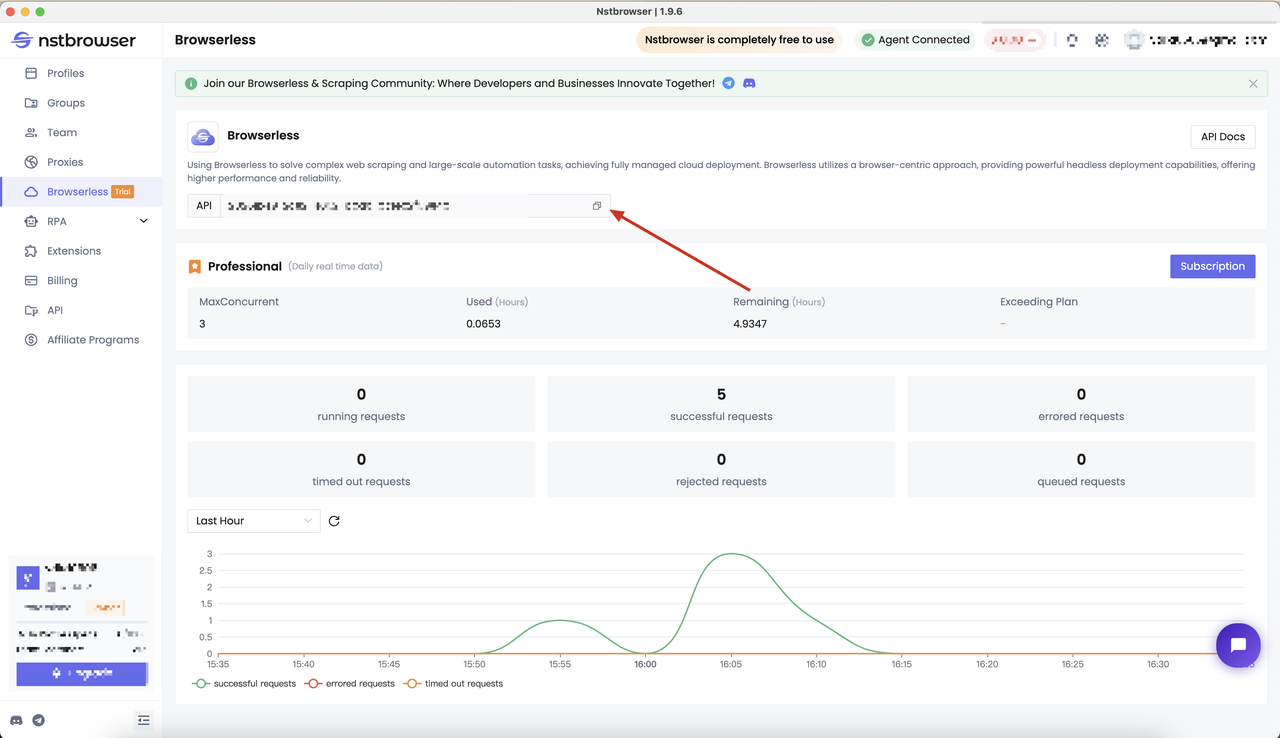
- Перейдите на страницу меню Browserless в клиенте Nstbrowser, чтобы получить API KEY, или вы можете получить его напрямую по ссылке здесь.
Определить целевую цель сканирования
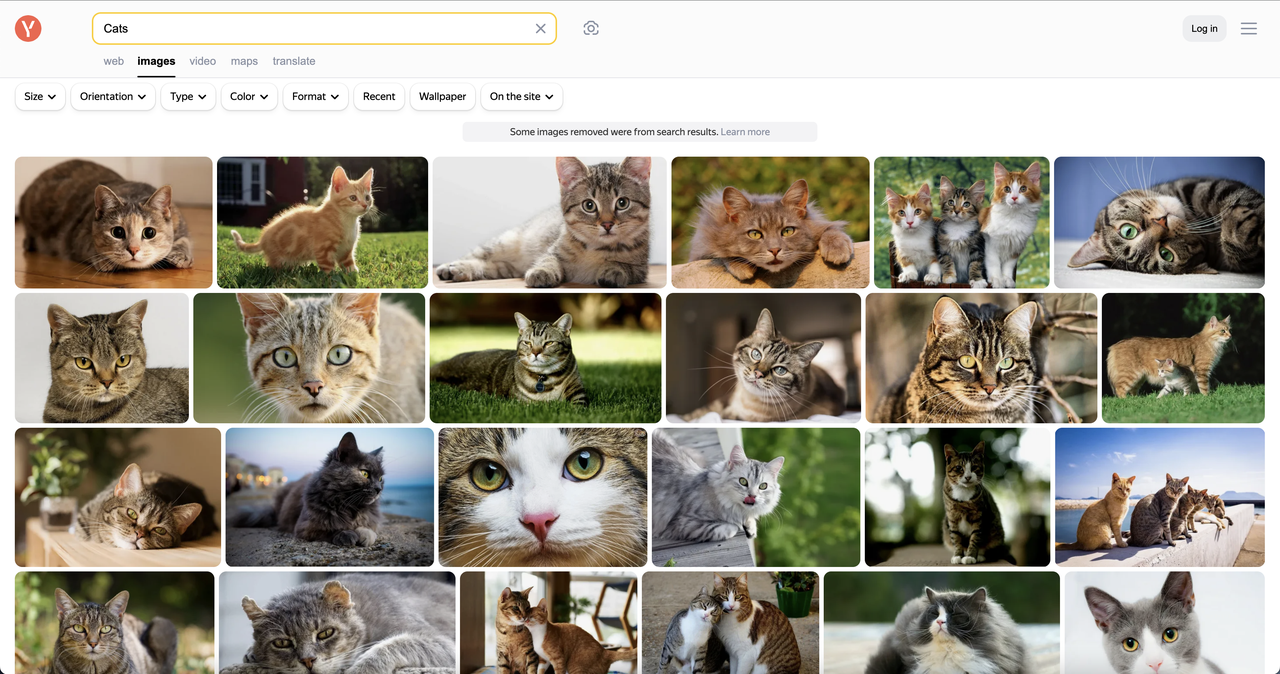
Как и раньше, сначала определим цель парсинга.
Давайте воспользуемся Playwright и объединим его с сервисом Browserless от Nstbrowser для сканирования самых популярных изображений при поиске по ключевому слову "cat".
Нам нужны следующие данные: "адрес изображения", "краткое описание изображения", "ширина изображения" и "высота изображения", а также необходимо сохранить результаты в файл CSV.
Начать сканирование с использованием сервиса Browserless от Nstbrowser
Выполните следующие действия, чтобы создать проект и начать парсинг:
Шаг 1. Создайте файл main.py и новый проект Python.
Шаг 2. Используйте Browserless от Nstbrowser для создания экземпляра браузера.
Python
from playwright.sync_api import sync_playwright

token = "Ваш API-токен" # требуется
config = {
    "proxy": "", # требуется; формат ввода: схема://пользователь:пароль@хост:порт например: http://пользователь:пароль@localhost:8080
    # "platform": "windows",  # поддержка: windows, mac, linux
    # "kernel": "chromium",  # поддержка только: chromium
    # "kernelMilestone": "124",  # поддержка: 113, 120, 124
    # "args": {
    #     "--proxy-bypass-list": "detect.nstbrowser.io"
    # },  # аргументы браузера
    # "fingerprint": {
    #     "userAgent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36",
    # },
}

query = urlencode({
    "token": token,
    "config": json.dumps(config)
})

browser_ws_endpoint = f"ws://less.nstbrowser.io/connect?{query}"

def get_browser():
    playwright = sync_playwright().start()
    return playwright.chromium.connect_over_cdp(browser_ws_endpoint)
Шаг 3. Получить данные об изображении и очистить их
- Определить адрес целевого веб-сайта:
Python
target_website_url = "https://yandex.com/images/search?family=yes&from=tabbar&text=cats"- Здесь Playwright использует метод
page.goto, чтобы открыть целевую веб-страницу.
Этот шаг необходим для того, чтобы браузер мог правильно загрузить страницу и подождать, пока контент DOM веб-страницы полностью загрузится.
Python
page.goto(url, timeout=60000, wait_until="domcontentloaded")- Затем необходимо найти все элементы на странице с атрибутами
data-stateи попытаться найти целевой элемент (элемент, содержащий данные изображения).
Этот шаг использует метод query_selector_all для получения этих элементов и определения элемента, содержащего информацию об изображении, с помощью get_attribute("id") и get_attribute("data-state").
Python
data_states = page.query_selector_all("[data-state]")
images_app = None
for data_state in data_states:
    if "ImagesApp" in data_state.get_attribute("id"):
        images_app = data_state.get_attribute("data-state")
break- После получения целевого элемента код вызывает функцию
get_image_results.
Эта функция анализирует данные JSON в атрибуте data-state целевого элемента и извлекает информацию об изображении.
Python
def get_image_results(images_app):
    images_app_obj = json.loads(images_app)
    images_lists = images_app_obj['initialState']["serpList"]["items"]["entities"]
    imgs = []
    for key in images_lists:
        img = images_lists[key]
        imgs.append({
            "url": img["url"],
            "alt": img["alt"],
            "width": img["width"],
            "height": img["height"],
        })

    return imgs
Шаг 4. Сохранить результаты сканирования и экспортировать их в файл CSV
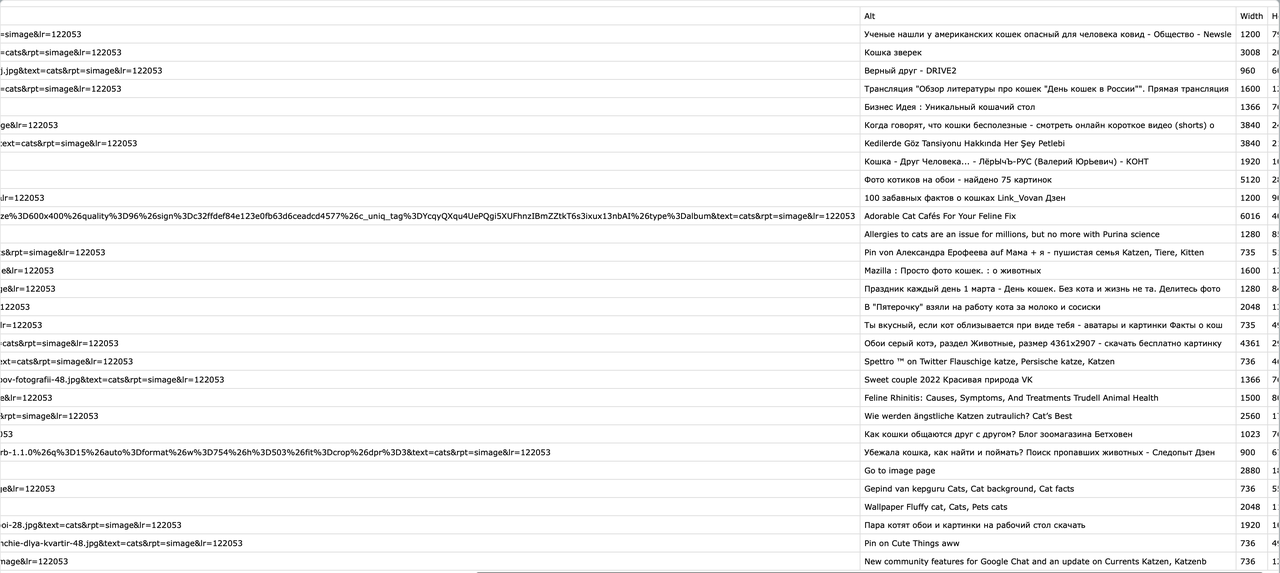
Перед сохранением данных необходимо определить заголовок файла CSV. Здесь определены четыре поля: URL, Alt, Width и Height. Эти поля представляют основные свойства каждого изображения. Используйте функцию open(), чтобы открыть файл с именем yandex_images.csv в режиме записи ('w'). Одновременно задайте формат кодировки как UTF-8 и установите newline='', чтобы избежать пустых строк при записи.
Python
def save_csv(data):
    try:
        header = ["URL", "Alt", "Width", "Height"]
        with open('yandex_images.csv', 'w', encoding='UTF8', newline='') as f:
            writer = csv.writer(f)
            writer.writerow(header)
            for item in data:
                writer.writerow(
                    [
                        item["url"],
                        item["alt"],
                        item["width"],
                        item["height"],
                    ])
        print("Сохранено в yandex_images.csv")
    except Exception as e:
        print(e)
Весь код
Python
import json
import csv
from urllib.parse import urlencode

from playwright.sync_api import sync_playwright

token = ""  # требуется
config = {
    "proxy": "", # требуется; формат ввода: схема://пользователь:пароль@хост:порт например: http://пользователь:пароль@localhost:8080
    # "platform": "windows",  # поддержка: windows, mac, linux
    # "kernel": "chromium",  # поддержка только: chromium
    # "kernelMilestone": "124",  # поддержка: 113, 120, 124
    # "args": {
    #     "--proxy-bypass-list": "detect.nstbrowser.io"
    # },  # аргументы браузера
    # "fingerprint": {
    #     "userAgent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36",
    # },
}

query = urlencode({
    "token": token,
    "config": json.dumps(config)
})

browser_ws_endpoint = f"ws://less.nstbrowser.io/connect?{query}"
target_website_url = "https://yandex.com/images/search?family=yes&from=tabbar&text=cats"


def get_browser():
    playwright = sync_playwright().start()
    return playwright.chromium.connect_over_cdp(browser_ws_endpoint)


def get_image_results(images_app):
    try:
        images_app_obj = json.loads(images_app)
        images_lists = images_app_obj['initialState']["serpList"]["items"]["entities"]
        imgs = []
        for key in images_lists:
            img = images_lists[key]
            imgs.append({
                "url": img["url"],
                "alt": img["alt"],
                "width": img["width"],
                "height": img["height"],
            })

        return imgs

    except Exception as e:
        print(e)


def get_tar(url, page):
    try:
        print("Открытие страницы: " + url)
        page.goto(url, timeout=60000, wait_until="domcontentloaded")
        data_states = page.query_selector_all("[data-state]")
        images_app = None
        results = []
        for data_state in data_states:
            if "ImagesApp" in data_state.get_attribute("id"):
                images_app = data_state.get_attribute("data-state")
                break

        if images_app is None:
            print("Не удалось найти целевой элемент")
        else:
            print("Найден целевой элемент")
            results = get_image_results(images_app)

        return results
    except Exception as e:
        print(e)


def save_csv(data):
    try:
        header = ["URL", "Alt", "Width", "Height"]
        with open('yandex_images.csv', 'w', encoding='UTF8', newline='') as f:
            writer = csv.writer(f)
            writer.writerow(header)
            for item in data:
                writer.writerow(
                    [
                        item["url"],
                        item["alt"],
                        item["width"],
                        item["height"],
                    ])
        print("Сохранено в yandex_images.csv")
    except Exception as e:
        print(e)


def main():
    try:
        with get_browser() as browser:
            page = browser.new_page()
            res = get_tar(target_website_url, page)
            if len(res) == 0:
                print("Нет результатов")
            else:
                save_csv(res)
            browser.close()
    except Exception as e:
        print(e)


if __name__ == "__main__":
    main()
Результат парсинга
Итог
Как известно, парсинг Яндекс Картинок — задача непростая. Однако, следуя инструкциям по парсингу, изложенным в этой статье, и используя приведенный код Python, вы можете легко парсить результаты поиска Яндекса по любому выбранному термину и экспортировать данные в файлы CSV или JSON.
С помощью Nstbrowser и Browserless вы можете легко масштабировать парсинг Яндекс SERP. Сейчас Browserless абсолютно бесплатен. Не упустите этот замечательный шанс!
Если вам нужно более мощное решение, свяжитесь с нами здесь.
Отказ от ответственности: Любые данные и сайты, упомянутые в этой статье, используются только для демонстрационных целей. Мы решительно против незаконных и нарушающих авторские права действий. Если у вас есть вопросы или опасения, пожалуйста, немедленно свяжитесь с нами.
Больше