Browserless
Cómo raspar los resultados de imágenes de Yandex usando Playwright y Browserless?
Rascar datos de la búsqueda de imágenes de Yandex es realmente difícil. Sin embargo, los pasos efectivos y los códigos de este artículo te ayudarán a raspar el contenido fácilmente.
Oct 24, 2024Carlos Rivera
¿Qué es Yandex?
Yandex es una empresa multinacional con sede en Rusia que es mejor conocida por su motor de búsqueda, que se encuentra entre los más grandes del país. Yandex proporciona una gama de servicios además de las capacidades de búsqueda. Además, Yandex proporciona Yandex Image Search, que le permite buscar fotografías utilizando palabras clave.
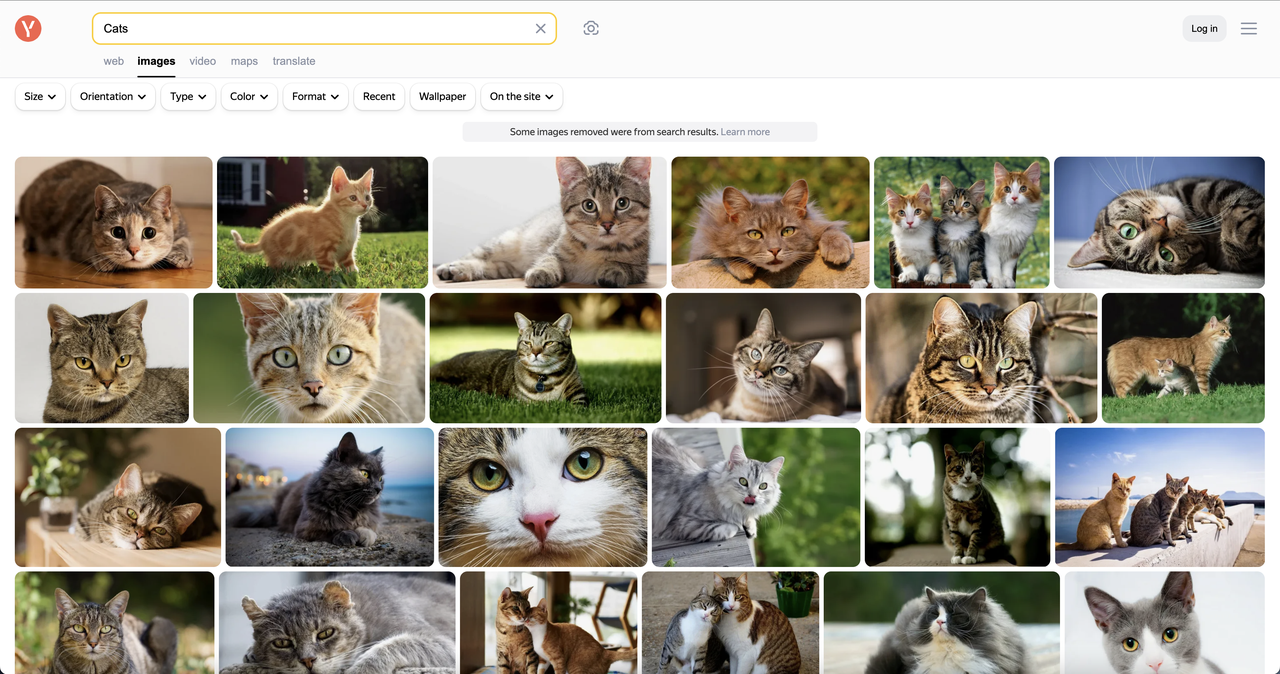
Los resultados de las búsquedas de imágenes de Yandex difieren ligeramente de los de Google y Bing. La búsqueda de imágenes de Yandex también admite numerosos filtros, que incluyen tamaño, orientación, tipo, color, formato, recientes y fondo de pantalla.
Se pueden raspar miles de fotos para una variedad de propósitos, que incluyen marketing, branding, investigación, enseñanza y creatividad.
¡Raspar Yandex es realmente difícil!
Yandex emplea medidas avanzadas contra bots diseñadas para detectar y bloquear solicitudes automatizadas. Esto incluye la implementación de CAPTCHA y la limitación estricta de la velocidad de IP, lo que puede dificultar los esfuerzos de raspado.
Muchas páginas de Yandex presentan contenido dinámico que se carga a través de JavaScript. Esto significa que las técnicas de raspado simples pueden no capturar toda la información relevante, lo que hace necesario el uso de herramientas más sofisticadas como los navegadores sin cabeza.
Además, Yandex actualiza con frecuencia sus algoritmos y la estructura de sus páginas. Esta evolución constante puede hacer que los scripts de raspado se rompan, lo que requiere mantenimiento y ajustes regulares.
Hay consideraciones legales que deben tenerse en cuenta, ya que el raspado puede violar los términos de servicio de Yandex, lo que puede llevar a repercusiones legales para los usuarios.
La gran cantidad de datos disponibles en Yandex significa que el manejo eficiente de los datos es esencial, lo que agrega otra capa de complejidad al proceso de raspado.
Estos factores combinados hacen que raspar Yandex sea un esfuerzo desafiante que requiere una planificación y ejecución cuidadosas.
¿Por qué Browserless funciona bien para raspar la búsqueda de imágenes de Yandex?
Browserless de Nstbrowser es un servicio típico de la nube de Chrome sin cabeza que opera aplicaciones en línea y automatiza scripts sin una interfaz gráfica de usuario. Es especialmente útil para tareas como el raspado web y otras operaciones automatizadas.
Nstbrowser integra características de antidetección, desbloqueo web y sin navegador en Browserless. Browserless es totalmente gratuito para probar. Nuestra documentación se ha preparado para obtener más detalles.
¿Tienes alguna idea o duda maravillosa sobre el raspado web y Browserless?
¡Veamos qué están compartiendo otros desarrolladores en Discord!
Cómo raspar los resultados de la búsqueda de imágenes de Yandex
Preconfiguración del entorno
Al principio, debemos preparar nuestro servicio Browserless. Browserless puede ayudar a resolver tareas complejas de rastreo web y automatización a gran escala, y se ha logrado una implementación en la nube totalmente administrada.
- Browserless utiliza un enfoque centrado en el navegador, ofrece funciones robustas de implementación sin cabeza y proporciona una mejor confiabilidad y velocidad. Consulte nuestra documentación sobre Browserless para obtener más detalles.
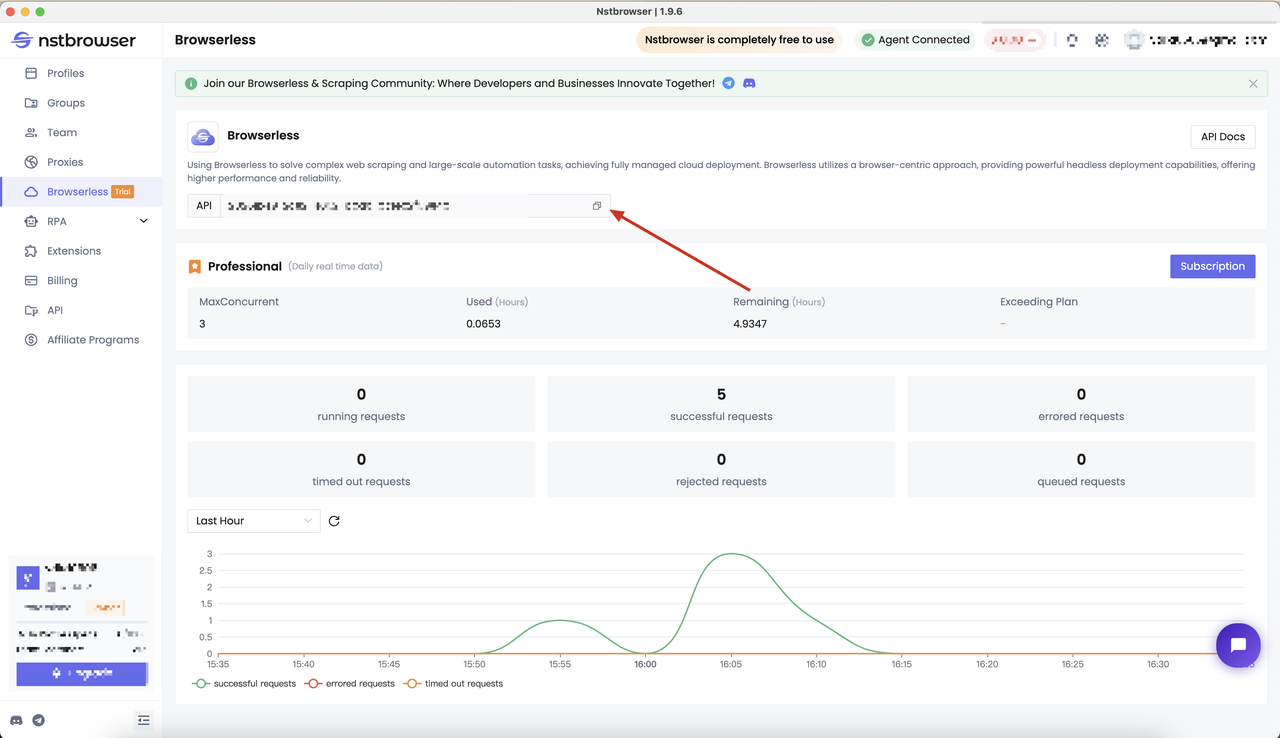
- Vaya a la página del menú Browserless del cliente Nstbrowser para obtener la API KEY, o puede obtenerla directamente a través de el enlace de salto aquí.
Determine el objetivo de rastreo
Como antes, síganos para determinar primero el objetivo de raspado.
Utilicemos Playwright y combinémoslo con el servicio Browserless de Nstbrowser para rastrear las imágenes principales al buscar la palabra clave "gato".
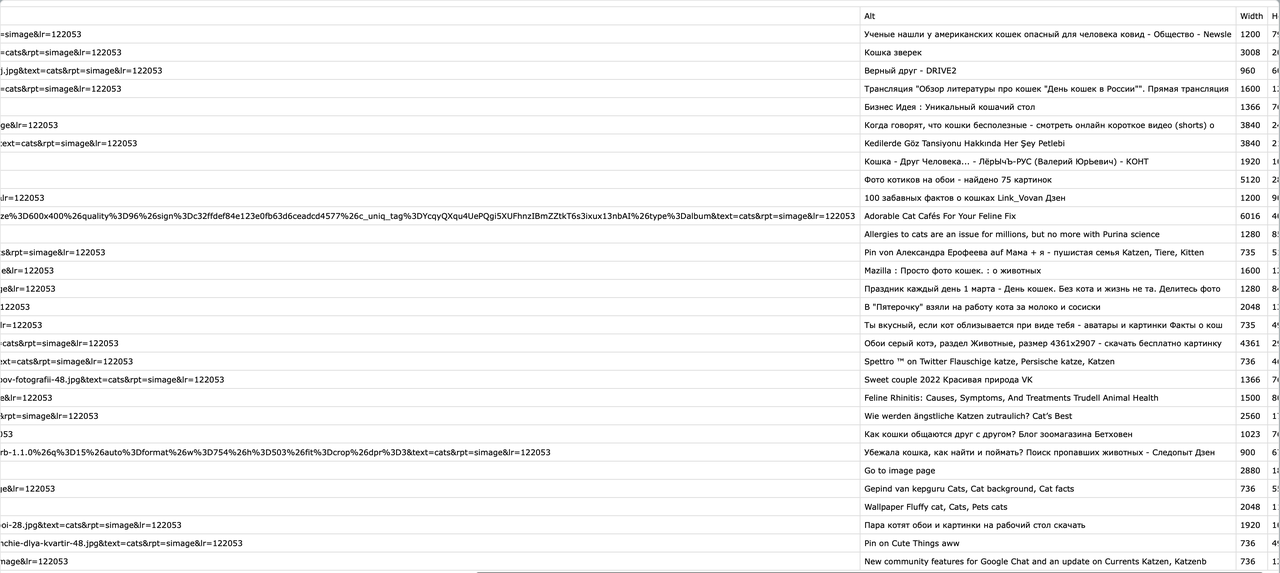
Los datos que necesitamos incluyen: "dirección de la imagen", "resumen de la imagen", "ancho de la imagen" y "alto de la imagen", y guarde los resultados en un archivo CSV.
Comience a rastrear utilizando el servicio Browserless de Nstbrowser
Siga los pasos a continuación para crear el proyecto y comenzar a raspar:
Paso 1. Cree un archivo main.py y un nuevo proyecto Python.
Paso 2. Usando Browserless de Nstbrowser para crear una instancia de navegador.
Python
from playwright.sync_api import sync_playwright

token = "Tu token de API" # obligatorio
config = {
    "proxy": "", # obligatorio; formato de entrada: schema://user:password@host:port ej: http://user:password@localhost:8080
    # "platform": "windows",  # soporte: windows, mac, linux
    # "kernel": "chromium",  # solo soporte: chromium
    # "kernelMilestone": "124",  # soporte: 113, 120, 124
    # "args": {
    #     "--proxy-bypass-list": "detect.nstbrowser.io"
    # },  # argumentos del navegador
    # "fingerprint": {
    #     "userAgent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36",
    # },
}

query = urlencode({
    "token": token,
    "config": json.dumps(config)
})

browser_ws_endpoint = f"ws://less.nstbrowser.io/connect?{query}"

def get_browser():
    playwright = sync_playwright().start()
    return playwright.chromium.connect_over_cdp(browser_ws_endpoint)
Paso 3. Obtenga los datos de la imagen y límpielos
- Defina la dirección del sitio web de destino de rastreo:
Python
target_website_url = "https://yandex.com/images/search?family=yes&from=tabbar&text=cats"- Aquí, Playwright utiliza el método
page.gotopara ayudar a abrir la página web de destino.
Este paso es para asegurar que el navegador pueda cargar la página correctamente y esperar a que el contenido DOM de la página web se cargue completamente.
Python
page.goto(url, timeout=60000, wait_until="domcontentloaded")- A continuación, necesitamos encontrar todos los elementos con atributos
data-stateen la página e intentar encontrar el elemento de destino (el elemento que contiene los datos de la imagen).
Este paso utiliza el método query_selector_all para obtener estos elementos y ubicar el elemento que contiene la información de la imagen a través de get_attribute("id") y get_attribute("data-state").
Python
data_states = page.query_selector_all("[data-state]")
images_app = None
for data_state in data_states:
    if "ImagesApp" in data_state.get_attribute("id"):
        images_app = data_state.get_attribute("data-state")
break- Después de obtener el elemento de destino, el código llama a la función
get_image_results.
Esta función analiza los datos JSON en el atributo data-state del elemento de destino y extrae la información de la imagen.
Python
def get_image_results(images_app):
    images_app_obj = json.loads(images_app)
    images_lists = images_app_obj['initialState']["serpList"]["items"]["entities"]
    imgs = []
    for key in images_lists:
        img = images_lists[key]
        imgs.append({
            "url": img["url"],
            "alt": img["alt"],
            "width": img["width"],
            "height": img["height"],
        })

    return imgs
Paso 4. Guarde los resultados de rastreo y expórtelos a un archivo CSV
Antes de guardar los datos, necesita definir el encabezado del archivo CSV. Aquí se definen cuatro campos: URL, Alt, Ancho y Alto. Estos campos representan las propiedades básicas de cada imagen. Utilice la función open() para abrir un archivo llamado yandex_images.csv en modo de escritura ('w'). Al mismo tiempo, el formato de codificación se especifica como UTF-8 y se establece newline='' para evitar líneas en blanco al escribir.
Python
def save_csv(data):
    try:
        header = ["URL", "Alt", "Ancho", "Alto"]
        with open('yandex_images.csv', 'w', encoding='UTF8', newline='') as f:
            writer = csv.writer(f)
            writer.writerow(header)
            for item in data:
                writer.writerow(
                    [
                        item["url"],
                        item["alt"],
                        item["width"],
                        item["height"],
                    ])
        print("Guardado en yandex_images.csv")
    except Exception as e:
        print(e)
Las líneas de código completas
Python
import json
import csv
from urllib.parse import urlencode

from playwright.sync_api import sync_playwright

token = ""  # obligatorio
config = {
    "proxy": "", # obligatorio; formato de entrada: schema://user:password@host:port ej: http://user:password@localhost:8080
    # "platform": "windows",  # soporte: windows, mac, linux
    # "kernel": "chromium",  # solo soporte: chromium
    # "kernelMilestone": "124",  # soporte: 113, 120, 124
    # "args": {
    #     "--proxy-bypass-list": "detect.nstbrowser.io"
    # },  # argumentos del navegador
    # "fingerprint": {
    #     "userAgent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36",
    # },
}

query = urlencode({
    "token": token,
    "config": json.dumps(config)
})

browser_ws_endpoint = f"ws://less.nstbrowser.io/connect?{query}"
target_website_url = "https://yandex.com/images/search?family=yes&from=tabbar&text=cats"


def get_browser():
    playwright = sync_playwright().start()
    return playwright.chromium.connect_over_cdp(browser_ws_endpoint)


def get_image_results(images_app):
    try:
        images_app_obj = json.loads(images_app)
        images_lists = images_app_obj['initialState']["serpList"]["items"]["entities"]
        imgs = []
        for key in images_lists:
            img = images_lists[key]
            imgs.append({
                "url": img["url"],
                "alt": img["alt"],
                "width": img["width"],
                "height": img["height"],
            })

        return imgs

    except Exception as e:
        print(e)


def get_tar(url, page):
    try:
        print("Abrir página: " + url)
        page.goto(url, timeout=60000, wait_until="domcontentloaded")
        data_states = page.query_selector_all("[data-state]")
        images_app = None
        results = []
        for data_state in data_states:
            if "ImagesApp" in data_state.get_attribute("id"):
                images_app = data_state.get_attribute("data-state")
                break

        if images_app is None:
            print("No se puede encontrar el elemento de destino")
        else:
            print("Se encontró el elemento de destino")
            results = get_image_results(images_app)

        return results
    except Exception as e:
        print(e)


def save_csv(data):
    try:
        header = ["URL", "Alt", "Ancho", "Alto"]
        with open('yandex_images.csv', 'w', encoding='UTF8', newline='') as f:
            writer = csv.writer(f)
            writer.writerow(header)
            for item in data:
                writer.writerow(
                    [
                        item["url"],
                        item["alt"],
                        item["width"],
                        item["height"],
                    ])
        print("Guardado en yandex_images.csv")
    except Exception as e:
        print(e)


def main():
    try:
        with get_browser() as browser:
            page = browser.new_page()
            res = get_tar(target_website_url, page)
            if len(res) == 0:
                print("No hay resultados")
            else:
                save_csv(res)
            browser.close()
    except Exception as e:
        print(e)


if __name__ == "__main__":
    main()
Resultado del raspado
Para terminar
Raspar la búsqueda de imágenes de Yandex es difícil, como todos saben. Sin embargo, puede raspar fácilmente los resultados de búsqueda de Yandex para cualquier término elegido y exportar los datos a archivos CSV o JSON si sigue las instrucciones de raspado de esta publicación y utiliza el código Python que se proporciona.
Puede raspar fácilmente Yandex SERP a escala con Nstbrowser y Browserless. Ahora, el uso de Browserless es totalmente gratuito. ¡No pierdas esta fantástica oportunidad!
Póngase en contacto con nosotros contáctenos si necesita una solución más potente.
Descargo de responsabilidad: Cualquier dato y sitio web mencionados en este artículo son solo para fines de demostración. Nos oponemos firmemente a las actividades ilegales y de infracción. Si tiene alguna pregunta o inquietud, comuníquese con nosotros de inmediato.
Más