Browserless
Cómo raspar sitios web dinámicos usando Browserless?
¡La extracción de páginas web dinámicas es realmente difícil! ¿Cómo terminarla fácilmente? Descubre la mejor manera en este tutorial.
Oct 18, 2024Robin Brown
¿Qué es una página web dinámica?
Una página web dinámica es aquella cuyo contenido no está incrustado directamente en HTML estático, sino que se genera a través del renderizado del lado del servidor o del lado del cliente.
Puede mostrar datos en tiempo real en función de las acciones del usuario, como cargar más contenido cuando el usuario hace clic en un botón o se desplaza hacia abajo en la página (como el desplazamiento infinito). Este diseño mejora la experiencia del usuario y permite a los usuarios obtener información relevante sin tener que volver a cargar toda la página.
Para determinar si un sitio web es una página web dinámica, puede deshabilitar JavaScript en su navegador. Si el sitio web es dinámico, la mayor parte del contenido desaparecerá.
Desafíos al raspar sitios web dinámicos
Huellas digitales y bloqueo
-
Técnicas de huellas digitales: Muchos sitios web utilizan técnicas de huellas digitales para detectar y bloquear raspadores automatizados. Estas técnicas crean una "huella digital" única para cada visitante analizando información como el comportamiento del navegador, la resolución de la pantalla, los complementos, la zona horaria, etc. Si se detectan anomalías o si son inconsistentes con el comportamiento normal del usuario, el sitio web puede bloquear el acceso.
-
Mecanismos de bloqueo: Para proteger su contenido, los sitios web implementan varios mecanismos de bloqueo, como:
- Bloqueo de IP: Cuando se reciben solicitudes frecuentes de la misma dirección IP, el sitio web puede prohibir temporal o permanentemente el acceso desde esa dirección IP.
- Verificación CAPTCHA: Los sitios web pueden introducir CAPTCHA cuando se detecta tráfico automatizado para confirmar que el visitante es humano.
- Limitación del tráfico: Se establece un límite de tasa de solicitud, y cuando la tasa de solicitud supera el umbral preestablecido, el sitio web rechazará las solicitudes adicionales.
Desafíos de carga local
- Consumo de recursos: Las páginas dinámicas suelen requerir más recursos del sistema para el renderizado y la rastreo de datos. Cuando se utilizan herramientas como Puppeteer o Selenium, esto puede provocar un alto uso de memoria y CPU, especialmente al rastrear varias páginas.
- Latencia y coste en tiempo: Debido a la necesidad de esperar a que la página se cargue completamente (incluida la ejecución de JavaScript y las solicitudes AJAX), el coste en tiempo de rastrear páginas dinámicas puede ser alto, lo que afectará a la eficiencia de todo el rastreador.
- Procesamiento concurrente: En condiciones de alta carga, el procesamiento de varias tareas de rastreo al mismo tiempo puede provocar una sobrecarga del sistema, lo que provocará errores de solicitud o tiempo de espera. Esto requiere estrategias razonables de programación de tareas y gestión de recursos.
¿Tiene alguna idea o duda maravillosa sobre el raspado web y Browserless?
¡Veamos lo que otros desarrolladores están compartiendo en Discord y Telegram!
6 formas efectivas de raspar sitios web dinámicos
1. Interceptar las solicitudes XHR/Fetch
Un método efectivo para interceptar las solicitudes XHR (XMLHttpRequest) y Fetch durante el proceso de raspado es inspeccionar la pestaña Red del navegador para identificar los puntos finales de la API que proporcionan contenido dinámico. Una vez que se identifican estos puntos finales, se pueden utilizar clientes HTTP como la biblioteca Requests para enviar solicitudes directamente a estas API para obtener datos.
- Ventajas: Este método es generalmente rápido y puede extraer datos de forma eficiente porque solo recupera el contenido requerido en lugar de toda la página web.
- Desventajas: Esto puede ser un desafío si los datos se almacenan en el DOM como JSON en lugar de ser devueltos por la API. Además, el proceso de simulación de solicitudes de API puede verse afectado por los cambios de API, los límites de frecuencia y los requisitos de autenticación, lo que da como resultado una mala escalabilidad.
2. Usar un navegador sin cabeza
El uso de un navegador sin cabeza como Puppeteer o Selenium permite la simulación completa del comportamiento del usuario, incluida la carga de la página y la interacción. Estas herramientas pueden procesar JavaScript y raspar el contenido generado dinámicamente.
- Ventajas: Este método puede raspar sitios web altamente dinámicos y admitir interacciones complejas con el usuario.
- Desventajas: alto consumo de recursos, velocidad de rastreo lenta y puede ser necesario lidiar con estructuras de página complejas y contenido dinámico.
3. Solicitud de API
Solicitar datos directamente de la API del sitio web es una forma eficiente de rastrear. Analice las solicitudes de red del sitio web, encuentre el punto final de la API y utilice el cliente HTTP para solicitar datos.
- Ventajas: Capacidad de obtener directamente los datos necesarios y evitar la complejidad de analizar HTML.
- Desventajas: Si la API requiere autenticación o tiene un límite de frecuencia de solicitud, puede afectar a la eficiencia del rastreo.
4. Rastrear solicitudes AJAX
Al monitorear las solicitudes de red, identificar las llamadas AJAX y reproducirlas, se pueden extraer datos cargados dinámicamente.
- Ventajas: Obtenga directamente las fuentes de datos y reduzca la carga innecesaria.
- Desventajas: Debe tener una cierta comprensión de los parámetros y el formato de las solicitudes AJAX, y también puede enfrentar problemas de autenticación y límites de frecuencia.
5. Proxy y rotación de IP
Para evitar ser bloqueado por el sitio web, el uso de servicios proxy y la rotación de IP es una estrategia importante. Esto puede ayudar a dispersar las solicitudes y reducir el riesgo de detección.
- Ventajas: Reduzca la probabilidad de ser bloqueado y puede mantener la efectividad en una gran cantidad de solicitudes.
- Desventajas: El uso de servicios proxy puede aumentar los costes de rastreo y requiere mantener una lista de proxy.
6. Simular el comportamiento del usuario
Escribir scripts para simular el comportamiento de navegación humana, como agregar retrasos entre las solicitudes, aleatorizar el orden de las operaciones, etc., puede ayudar a reducir el riesgo de ser identificado como un rastreador por el sitio web.
- Ventajas: El rastreo de datos se puede realizar de forma más natural, lo que reduce el riesgo de ser detectado.
- Desventajas: La implementación es relativamente compleja y lleva tiempo ajustar y optimizar el comportamiento simulado.
¿Qué es Browserless?
Browserless es un servicio en la nube headlesschrome que opera aplicaciones en línea y automatiza scripts sin una interfaz gráfica de usuario. Es especialmente útil para trabajos como el raspado web y otras operaciones automatizadas.
Browserless facilita el raspado de páginas web dinámicas
Browserless también es un poderoso navegador sin cabeza. A continuación, utilizaremos Browserless como ejemplo para rastrear páginas web dinámicas.
Requisito previo
Antes de comenzar, debemos tener un servicio Browserless. El uso de Browserless puede resolver tareas complejas de rastreo web y automatización a gran escala, y ahora se ha logrado la implementación en la nube totalmente gestionada.
Browserless adopta una estrategia centrada en el navegador, proporciona capacidades de implementación headless potentes y ofrece un mayor rendimiento y confiabilidad. Puede hacer clic aquí para obtener más información sobre la configuración de los servicios Browserless.
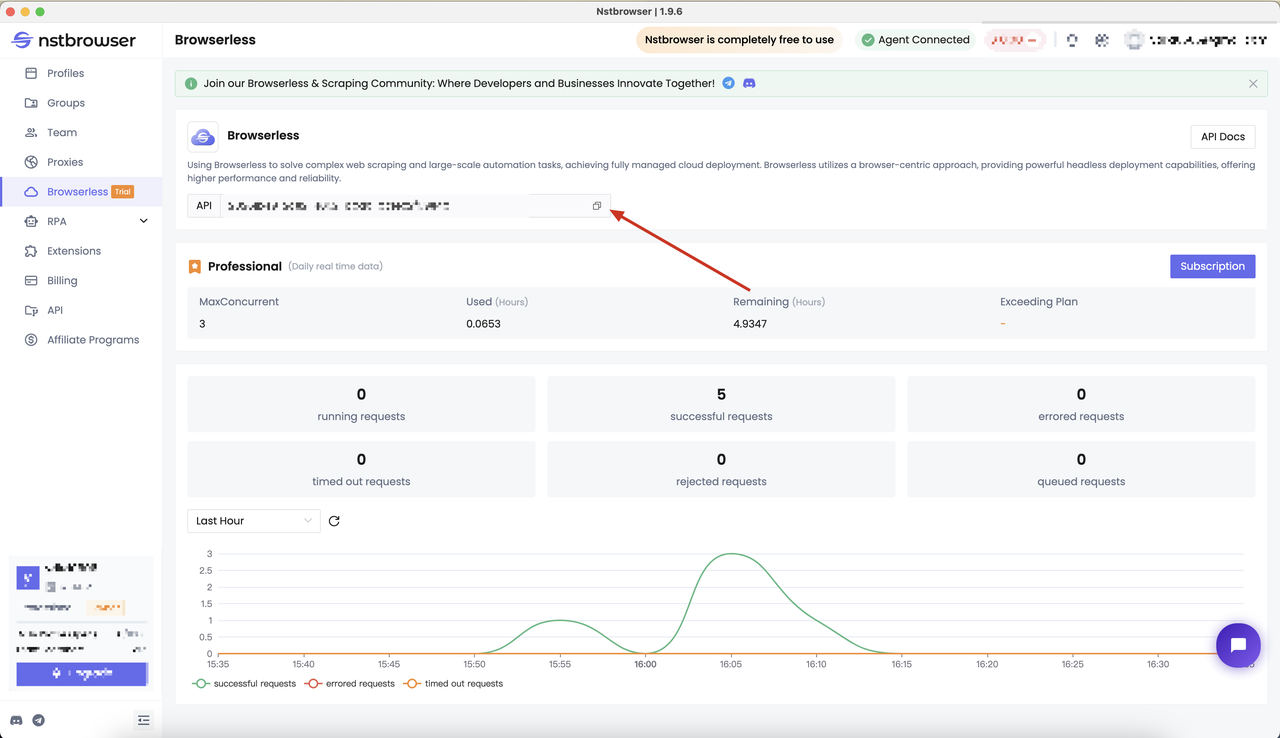
Al principio, necesitábamos obtener la API KEY de Nstbrowser. Puede ir a la página del menú Browserless del cliente Nstbrowser, o puede hacer clic aquí para visitar.
Determine el objetivo del rastreo
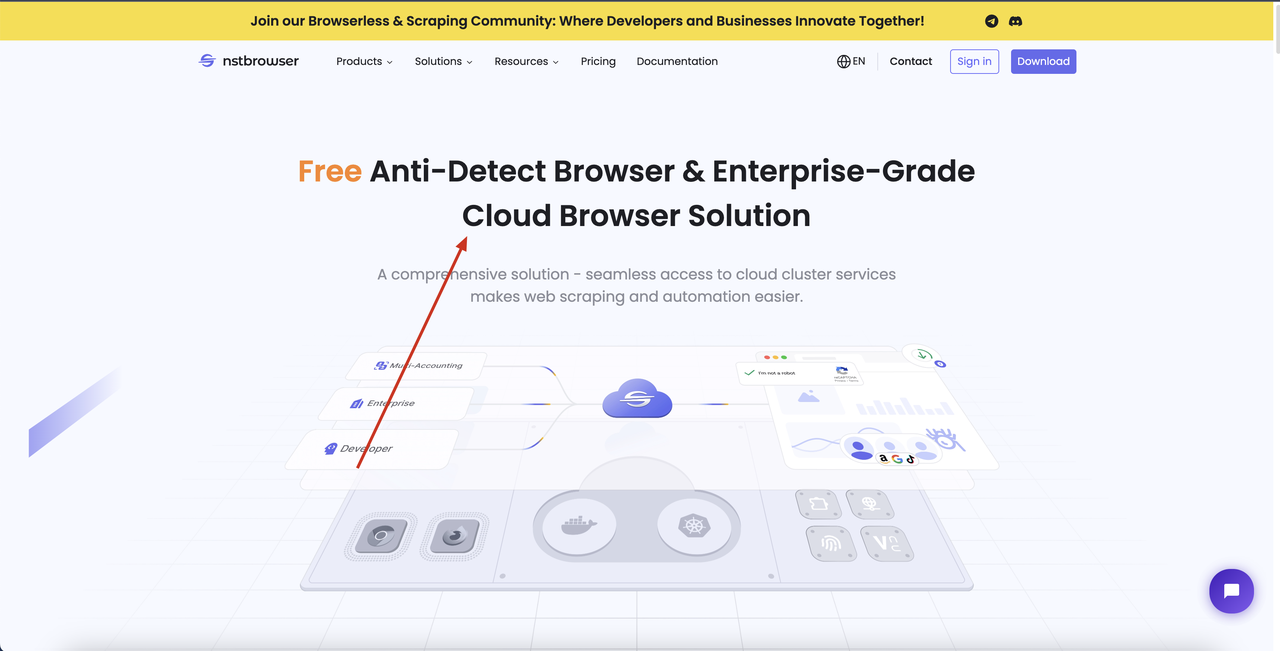
Antes de comenzar, determinemos el objetivo de esta prueba. Usaremos Puppeteer y Playwright para obtener el contenido del título de la página de sitios web dinámicos:
- Visite el sitio web de destino: https://www.nstbrowser.io/en
- Obtenga el contenido dinámico del título de la página
Inicializar el proyecto
Siga los pasos a continuación para instalar las dependencias:
- Paso 1: Crea una nueva carpeta en Vs code
- Paso 2: Abra la terminal de Vs code y ejecute los siguientes comandos para instalar las dependencias relacionadas
SQL
npm init -y
pnpm add playwright puppeteer-core
Rastrear páginas web dinámicas utilizando Playwright y Browserless
- Crea un script de rastreo
TypeScript
const { chromium } = require('playwright');

async function createBrowser() {
  const token = ''; // requerido
  const config = {
    proxy:
      '', // requerido; formato de entrada: esquema://usuario:contraseña@host:puerto ej: http://usuario:contraseña@localhost:8080
    // plataforma: 'windows', // soporte: windows, mac, linux
    // kernel: 'chromium', // solo soporte: chromium
    // kernelMilestone: '124', // soporte: 113, 120, 124
    // args: {
    //   '--proxy-bypass-list': 'detect.nstbrowser.io',
    // }, // argumentos del navegador
    // huella digital: {
    //   userAgent:
    //     'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36',
    // },
  };
  const query = new URLSearchParams({
    token: token, // requerido
    config: JSON.stringify(config),
  });

  const browserWSEndpoint = `ws://less.nstbrowser.io/connect?${query.toString()}`;
  const browser = await chromium.connectOverCDP(browserWSEndpoint);
  const context = await browser.newContext();
  const page = await context.newPage();

  page.goto('https://www.nstbrowser.io/en');

  // dormir durante 5 segundos
  await new Promise((resolve) => setTimeout(resolve, 5000));

  const h1Element = await page.$('h1');
  const content = await h1Element?.textContent();
  console.log(`Playwright: El contenido del elemento h1 es: ${content}`)

  await page.close();
  await page.context().close();
}

createBrowser().then();- Comprueba el resultado del rastreo

Rastrear páginas web dinámicas utilizando Puppeteer y Browserless
- Crea un script de rastreo
TypeScript
const puppeteer = require('puppeteer-core');

async function createBrowser() {
  const token = ''; // requerido
  const config = {
    proxy:
      '', // requerido; formato de entrada: esquema://usuario:contraseña@host:puerto ej: http://usuario:contraseña@localhost:8080
    // plataforma: 'windows', // soporte: windows, mac, linux
    // kernel: 'chromium', // solo soporte: chromium
    // kernelMilestone: '124', // soporte: 113, 120, 124
    // args: {
    //   '--proxy-bypass-list': 'detect.nstbrowser.io',
    // }, // argumentos del navegador
    // huella digital: {
    //   userAgent:
    //     'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36',
    // },
  };
  const query = new URLSearchParams({
    token: token, // requerido
    config: JSON.stringify(config),
  });

  const browserWSEndpoint = `ws://less.nstbrowser.io/connect?${query.toString()}`;
  const browser = await puppeteer.connect({
    browserWSEndpoint: browserWSEndpoint,
    defaultViewport: null,
  });
  const page = await browser.newPage();

  await page.goto('https://www.nstbrowser.io/en');

  // dormir durante 5 segundos
  await new Promise((resolve) => setTimeout(resolve, 5000));

  const h1Element = await page.$('h1');

  if (h1Element) {
    const content = await page.evaluate((el) => el.textContent, h1Element); // utilizar page.evaluate para obtener el contenido de texto del elemento h1
    console.log(`Puppeteer: El contenido del elemento h1 es: ${content}`);
  } else {
    console.log('No se encontró ningún elemento h1.');
  }

  await page.close();
}

createBrowser().then();- Comprueba el resultado del rastreo

Conclusión
Rastrear páginas web dinámicas siempre es más complicado que rastrear páginas web ordinarias. Es fácil encontrar varios problemas durante el proceso de rastreo. A través de la introducción de este blog, debe haber aprendido:
- 6 formas efectivas de rastrear páginas web dinámicas
- Usar Browserless para rastrear fácilmente páginas web dinámicas
Más