Browserless
Implementar Headlesschrome en Docker: Ejecutar en Browserless
Cómo desplegar headlesschrome en Docker? Este blog te inspirará con pasos detallados para usar Browserless en un contenedor Docker.
Sep 18, 2024Robin Brown
¿Qué es Browserless?
Browserless es una solución de navegador basada en la nube diseñada para una automatización de navegador efectiva, web scraping y pruebas.
Utiliza la biblioteca de huellas digitales de Nstbrowser para habilitar el cambio aleatorio de huellas digitales, asegurando una recopilación de datos y una automatización sin problemas. Gracias a su robusta infraestructura en la nube, Browserless simplifica el acceso a múltiples instancias de navegador, lo que facilita la gestión de tareas de automatización.
¿Tienes alguna idea o duda maravillosa sobre web scraping y Browserless?
¡Veamos qué están compartiendo otros desarrolladores en Discord y Telegram!
¿Cómo funciona Browserless?
Browserless funciona proporcionando un navegador sin cabeza como servicio, que permite a los usuarios realizar tareas de automatización del navegador sin necesidad de una interfaz gráfica.
Permite a los desarrolladores ejecutar tareas basadas en navegador, como web scraping, pruebas automatizadas y renderizado de páginas web, a través de API. Al operar en un entorno en la nube, Browserless simplifica el proceso de automatización de navegadores al eliminar la necesidad de configuración manual o mantenimiento de la infraestructura del navegador.
Browserless admite bibliotecas populares como Puppeteer y Playwright, lo que permite a los usuarios interactuar con los sitios web de forma programática. Su infraestructura basada en Docker permite una implementación escalable y flexible, lo que la hace eficiente para aplicaciones de pequeña escala y de nivel empresarial. Se puede integrar en flujos de trabajo para automatizar tareas repetitivas o recopilar datos de sitios web que requieren un navegador para acceder.
¿Cómo implementar Headlesschrome en Docker?
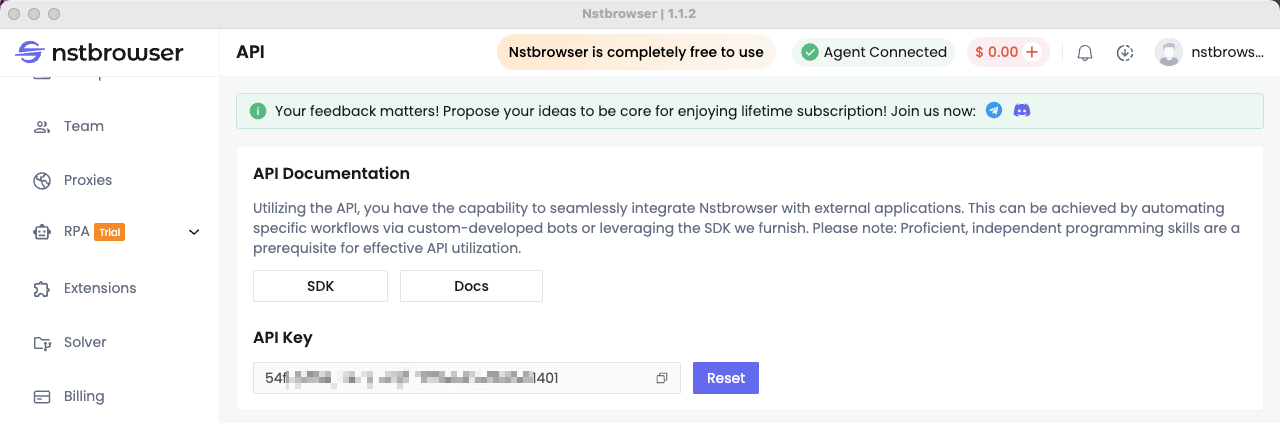
Paso 1: Obtén tu clave API
Para una mejor experiencia, crea una nueva cuenta en nuestro sitio web oficial.
Inicia sesión en el cliente Nstbrowser con la información con la que te registraste. Después de iniciar sesión correctamente, ¡no olvides generar tu clave API única desde el menú API!
Paso 2: Obtén la imagen Nstbrowserless y ejecútala
Necesitas obtener la Clave API y reemplazar la siguiente parte {YOUR_API_KEY}.
Bash
docker run -it -e TOKEN={YOUR_API_KEY} -e SERVER_PORT=8848 -p 8848:8848 --name nstbrowserless nstbrowser/browserless:0.0.1-beta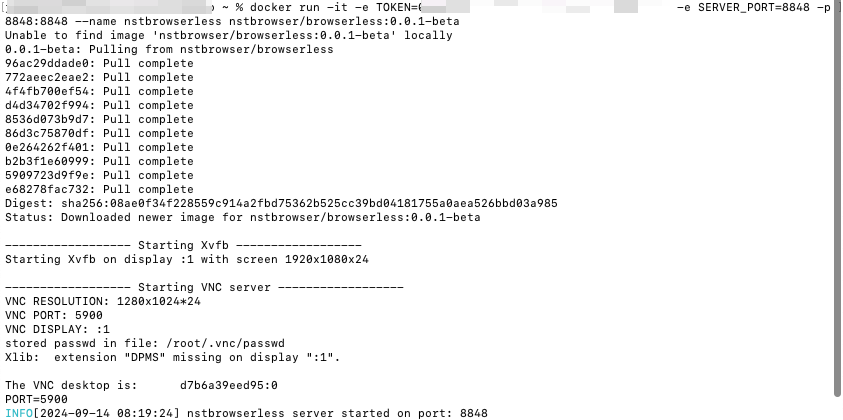
¿Cómo utilizar Browserless en un contenedor Docker?
Puedes conectarte al navegador sin cabeza a través de Puppeteer, Playwright, Chromedp u otras bibliotecas CDP para lograr las funciones de operación y captura de pantalla del navegador sin cabeza.
Puppeteer
Puppeteer es una biblioteca de Node.js que proporciona una API de alto nivel para controlar el navegador Chrome y admite operaciones a través del protocolo DevTools.
- Instala Puppeteer
Bash
npm install puppeteer- Prepara el archivo
puppeteer.js
JavaScript
const puppeteer = require("puppeteer");

(async () => {
  const host = "127.0.0.1:8848"; // Reemplaza con la IP de tu contenedor Docker
  const browserWSEndpoint = `ws://${host}/ws/connect`;

  try {
    const browser = await puppeteer.connect({
      browserWSEndpoint: browserWSEndpoint,
    });

    const page = await browser.newPage();
    await page.goto("https://google.com", { waitUntil: 'networkidle2' }); // Espera a que la red esté inactiva
    await page.screenshot({ path: "screenshot.png", fullPage: true }); // Toma una captura de pantalla de toda la página

    console.log("Captura de pantalla tomada y guardada como screenshot.png");

    await browser.close(); // Cierra la conexión del navegador
  } catch (err) {
    console.error("Error ocurrido:", err);
  }
})();- Ejecuta tus scripts
Bash
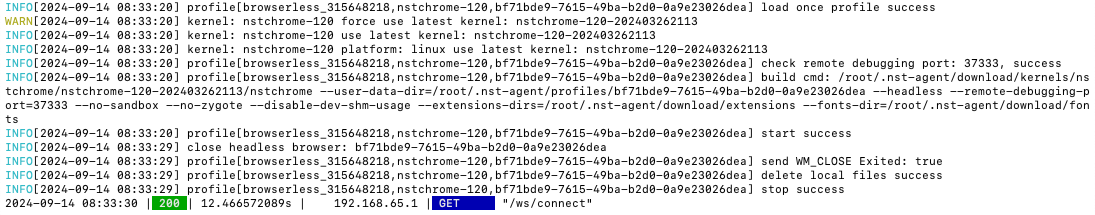
node puppeteer.jsDespués de ejecutar, puedes ver que el navegador sin cabeza está funcionando como lo deseábamos:
Ahora, el proyecto ha terminado, puedes averiguar el screenshot.png generado:
Playwright CDP
Playwright es un marco para pruebas web y automatización que permite probar el navegador Chrome a través de una única API.
- Instala Playwright
Bash
npm install playwright- Prepara el archivo playwright.js
JavaScript
import { chromium } from "playwright";

(async () => {
  const host = "127.0.0.1:8848"; // reemplaza con la IP de tu contenedor Docker
  const browserWSEndpoint = `ws://${host}/ws/connect`;

  try {
    const browser = await chromium.connectOverCDP(browserWSEndpoint);
    const context = await browser.newContext();
    const page = await context.newPage();

    await page.goto("https://www.google.com/", { waitUntil: 'networkidle' }); // espera a que la red esté inactiva
    await page.screenshot({ path: "screenshot.png" }); // toma una captura de pantalla de toda la página

    console.log("Captura de pantalla tomada y guardada como screenshot.png");

    await browser.close(); // cierra la conexión del navegador
  } catch (err) {
    console.error("Error ocurrido:", err);
  }
})();- Ejecuta tus scripts
Bash
node playwright.jsAl igual que Puppeteer, después de ejecutar, puedes averiguar el screenshot.png generado también.
Resumen
Browserless hace que el web scraping y la automatización sean fáciles. En este blog, puedes ver:
- La forma efectiva de implementar headlesschrome en Docker.
- Pasos detallados para usar Browserless en un contenedor Docker.
Ejecutar un navegador dentro de un contenedor proporciona mucha flexibilidad y escalabilidad. También es mucho más barato que las instancias tradicionales basadas en VM.
Nstbrowser te ofrece la solución óptima. ¡Prueba Browserless gratis ahora!
Más