Browserless
Cómo usar Browserless con Ubuntu 22.04?
Ubuntu 22.04 es un sistema potente para cualquier desarrollador. ¿Cómo funciona con Browserless? Encuentra todos los detalles en este maravilloso blog.
Sep 26, 2024Carlos Rivera
Ubuntu 22.04 es un sistema operativo Linux basado en Debian que es una versión de soporte a largo plazo (LTS), que proporciona cinco años de soporte oficial y actualizaciones de seguridad.
Utiliza un entorno de escritorio GNOME moderno, optimiza el rendimiento y la estabilidad, y contiene los paquetes y herramientas más recientes para admitir el nuevo hardware. Además, Ubuntu 22.04 mejora la seguridad y proporciona configuraciones de seguridad predeterminadas más estrictas y protección de la privacidad.
¿Sigue siendo compatible Ubuntu 22.04?
¡Sí!
Ubuntu 22.04 tiene el nombre en código Jammy Jellyfish. Se lanzó el 21 de abril de 2022 y es una versión de soporte a largo plazo, con soporte durante cinco años, hasta abril de 2027.
¿Qué es Browserless?
Browserless es una potente solución de navegador. Basado en clústeres en la nube, Browserless está diseñado para facilitar tareas complejas de automatización del navegador, rastreo web y pruebas de una manera escalable y eficiente. Está construido sobre la biblioteca integral de huellas digitales de Nstbrowser y proporciona un cambio aleatorio de huellas digitales para satisfacer las necesidades del usuario en cuanto a la recopilación de datos y las tareas de automatización.
¿Tienes alguna idea maravillosa y dudas sobre el web scraping y Browserless?
¡Veamos qué comparten otros desarrolladores en Discord y Telegram!
¿Cómo usar Browserless en Ubuntu 22.04?
Requisitos previos
Antes de usar Browserless, debes configurar NodeJS de antemano.
Ubuntu 22.04 viene con un paquete Node.js. Aunque es posible que la versión predeterminada no sea la más reciente, es suficiente para satisfacer las necesidades de desarrollo básicas. Usamos apt para instalarlo, que es una forma sencilla.
Paso 1. Actualiza el índice de paquetes local.
Antes de instalar Node.js, actualiza el índice de paquetes local:
Shell
sudo apt updatePaso 2. Instala Node.js.
Instala Node.js usando el administrador de paquetes apt:
Shell
sudo apt install nodejs -yPaso 3. Instala el administrador de paquetes de nodos.
npm se utiliza para administrar módulos y paquetes de Node.js
Shell
sudo apt install npm -yPaso 4. Verifica que Node.js y npm estén instalados correctamente.
Una vez completada la instalación, puedes verificar la versión de Node.js instalada con el siguiente comando:
Shell
node -v
npm -v
Si la salida muestra información de la versión, significa que la instalación fue exitosa.
Usando Browserless
Paso 1. Construcción del proyecto
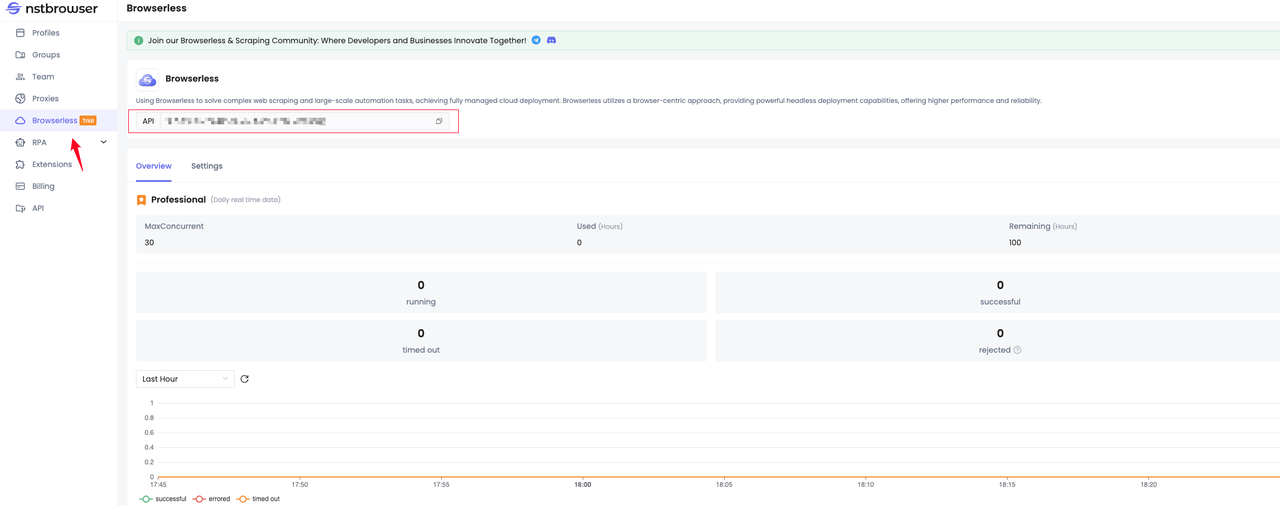
- De acuerdo con la documentación de la API de Nstbrowser browserless, primero, necesitamos obtener la clave API:
- A continuación, crea un proyecto de nodo
Bash
mkdir nst-browserless && cd nst-browserless
npm init -y- Luego, simplemente elige el IDE que te guste. Usamos VisualStudio aquí:
Bash
code .Actualmente, Browserless solo admite Puppeteer y Playwright. En este tutorial, elegimos usar un puppeteer. A continuación, es hora de instalar las dependencias:
Bash
npm i --save puppeteer-coreHasta ahora, hemos completado la construcción del proyecto.
Paso 2. Codificación
Acceso a Browserless
Primero, escribe un proceso simple para verificar si se puede acceder a Browserless normalmente:
JavaScript
import puppeteer from "puppeteer-core";

const token = "tu token"; // requerido
const config = {
    proxy: 'tu proxy', // requerido
};
const query = new URLSearchParams({
    token: token, // requerido
    config: JSON.stringify(config),
});
const browserWSEndpoint = `https://less.nstbrowser.io/connect?${query.toString()}`;

const getBrowser = async () => puppeteer.connect({
    browserWSEndpoint,
    defaultViewport: null,
});

(async () => {
    let browser = null;
    await getBrowser()
        .then(async (browser) => {
            const page = await browser.newPage();
            await page.goto("https://nstbrowser.io");
            await page.screenshot({ path: "screenshot.png", fullPage: true });
            await page.close();
            await browser.close();
        })
        .catch((error) => {
            console.log(error);
        })
        .finally(() => browser?.close());
})()
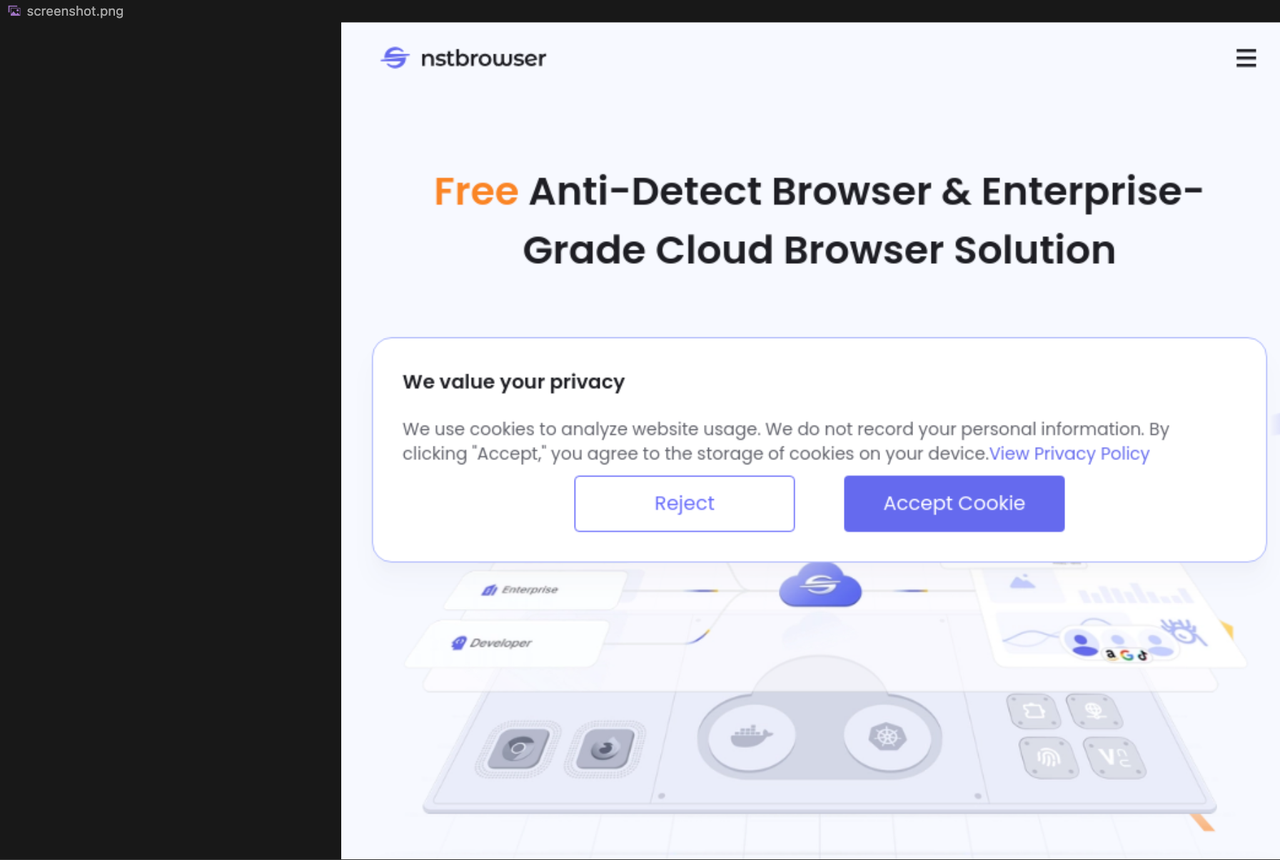
Poder generar una captura de pantalla muestra que podemos usar Browserless normalmente:
Rastreo de imágenes
A continuación, vamos al sitio Pixels para rastrear algunas imágenes:
- ingresa a la subpágina desde la navegación de la categoría Arte de pared en la parte superior de la página de inicio
- obtén las primeras seis direcciones de imagen e imprime los resultados.
- Análisis del sitio
Encuentra el enlace del menú de navegación:
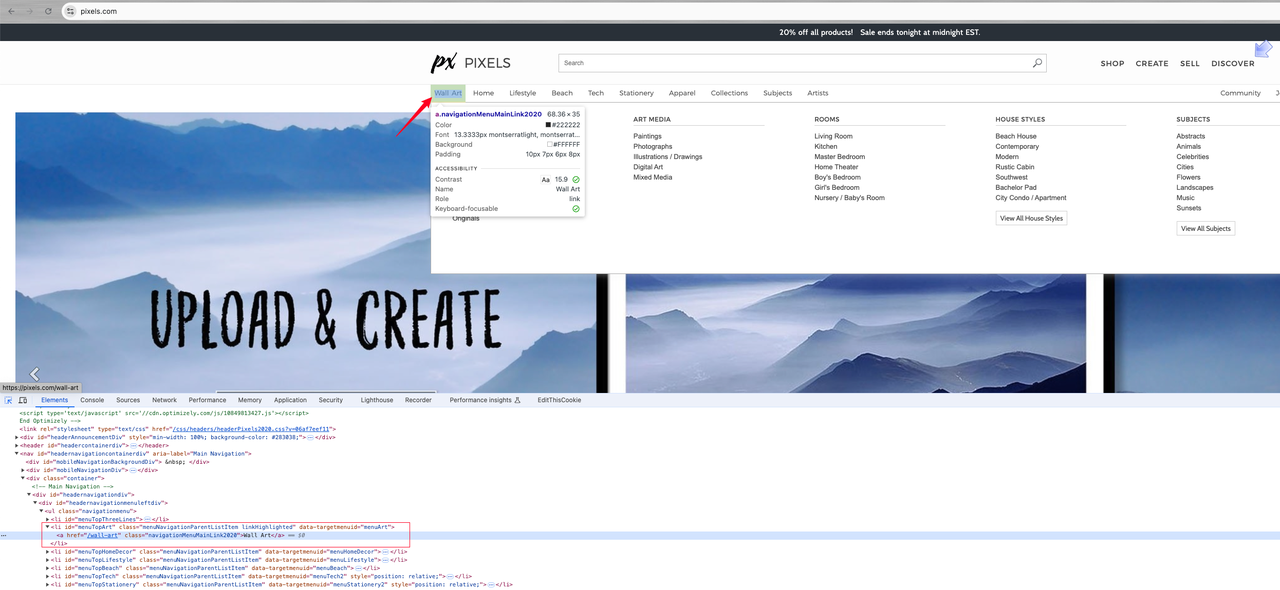
Después del análisis, podemos ver que el enlace en el que debemos hacer clic es una etiqueta a debajo del elemento li con el id menuTopArt. A continuación, analicemos más a fondo el elemento que se va a rastrear:
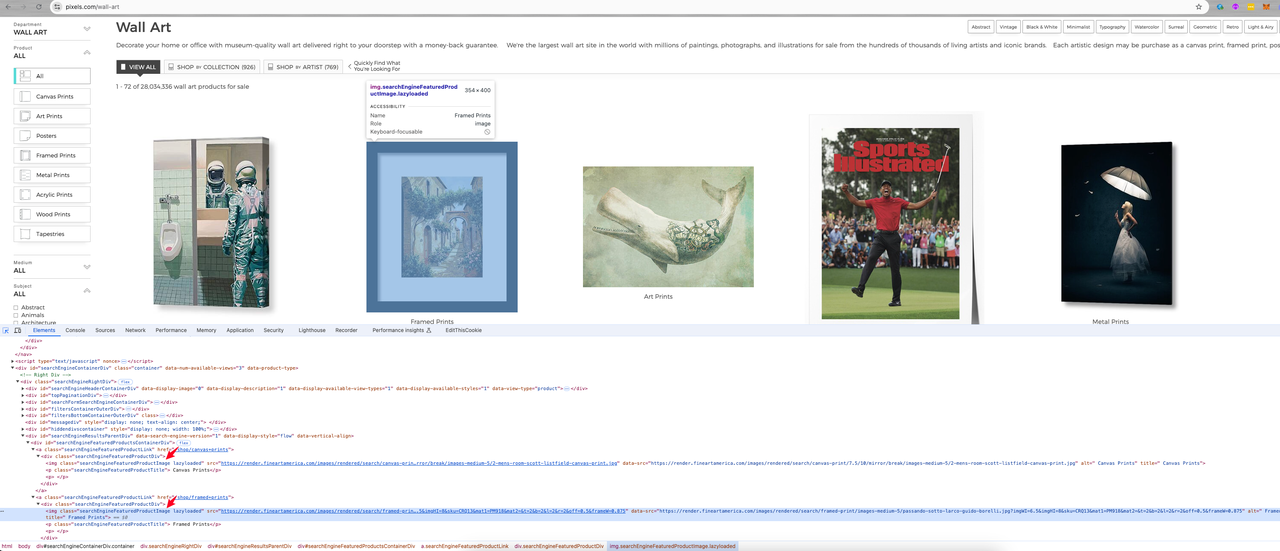
Muestra que el elemento donde se encuentra la imagen que queremos está ubicado en el valor src de una etiqueta img con el nombre de clase searchEngineFeaturedProductImage cargado de forma diferida.
- Rastreo de imágenes
Modifica el código que escribimos anteriormente para completar el trabajo de rastreo:
JavaScript
import puppeteer from "puppeteer-core";

const token = "tu token de api";
const config = {
    proxy: 'tu proxy', // requerido
};
const query = new URLSearchParams({
    token: token, // requerido
    config: JSON.stringify(config),
});
const browserWSEndpoint = `https://less.nstbrowser.io/connect?${query.toString()}`;

const getBrowser = async () => puppeteer.connect({
    browserWSEndpoint,
    defaultViewport: null,
});

(async () => {
    let browser = null;
    const pixelsWebsite = "https://pixels.com";
    await getBrowser()
        .then(async (browser) => {
            const page = await browser.newPage();
            await page.goto(pixelsWebsite);
            await page.waitForSelector("#menuTopArt", { timeout: 30000 });
            await page.click("#menuTopArt a"); // haz clic en el menú 'Arte de pared'
            await page.waitForSelector(".searchEngineFeaturedProductImage", { timeout: 30000 });
            const imageElements = await page.$$('.searchEngineFeaturedProductImage');
            for (const imageElement of imageElements) {
                const src = await page.evaluate(el => el.src, imageElement);
                if (src.includes("Blank.jpg")) { // interrumpe si llega Blank.jgp
                    break
                }
                console.log(src);
                // TODO: agrega un procesamiento adicional para la imagen si es necesario
            }
            await page.close();
            await browser.close();
        })
        .catch((error) => {
            console.log(error);
        })
        .finally(() => browser?.close());
})()
¡Bravo! Aquí puedes encontrar el resultado del rastreo:

Notas para llevar
¡Qué maravilloso es Ubuntu! En este blog, aprendimos que:
- Los pasos para instalar NodeJS en Ubuntu 22.04
- Usa Browserless a través de Puppeteer para rastrear el enlace de datos de la dirección de imagen en el sitio Pixels
Puedes ver que todo el proceso es muy ligero y rápido, y el proceso también es muy simple.
¡Ahora comienza a estudiar más formas de jugar con Browserless por tu cuenta!
Más