Browserless
Cómo raspar datos de productos de Amazon usando Puppeteer y Browserless?
La extracción de datos de Amazon evitará en gran medida problemas que consumen tiempo y mano de obra. Lee este tutorial y encuentra la forma efectiva de extraer datos de Amazon.
Nov 08, 2024Robin Brown
Siempre puedes encontrar toda la información relevante y valiosa sobre productos, vendedores, reseñas, calificaciones, ofertas especiales, noticias, etc. en Amazon. Ya sea que se trate de un vendedor que realiza estudios de mercado o de una persona que recopila datos, el uso de una herramienta de alta calidad, conveniente y rápida te ayudará a rastrear con precisión una gran cantidad de información en Amazon.
¿Por qué es importante raspar los datos de los productos de Amazon?
Amazon recopila información valiosa en un solo lugar: productos, reseñas, calificaciones, ofertas exclusivas, noticias, etc. Por lo tanto, el raspado de datos en Amazon evitará en gran medida los problemas que requieren mucho tiempo y trabajo. Como empresa, el uso de un raspador de productos de Amazon puede aportarte al menos las siguientes 4 ventajas significativas:
- Comprender los precios en el mercado local o incluso global y comparar precios
- Analizar las diferencias con la competencia
- Identificar grupos objetivo
- Mejorar la imagen del producto
- Predecir las necesidades de los usuarios
- Recopilar información de los clientes
Razones típicas para raspar productos de Amazon
- Monitorear los precios y los productos de la competencia
- Entender las tendencias del mercado
- Optimizar las estrategias de marketing
- Mejorar las fichas de producto
- Optimización de precios
- Mejorar la investigación de productos
- Seguimiento del sentimiento de los clientes
¿Ayuda Browserless a construir un raspador de productos de Amazon?
Los navegadores sin cabeza son excelentes para realizar trabajos automatizados. Así es, utilizaremos el servicio de navegador sin cabeza más potente de Nstbrowser: Browserless para rastrear la información del producto de Amazon.
Al rastrear datos de productos de Amazon, siempre nos encontramos con una serie de desafíos graves, como detección de robots, reconocimiento de códigos de verificación y bloqueo de IP. ¡Usar Browserless puede evitar completamente estos dolores de cabeza!
Browserless de Nstbrowser proporciona huellas dactilares de navegador de usuario real, y cada huella dactilar es única. Además, participar en nuestro plan de suscripción puede lograr una omisión completa del captcha, lo que garantiza una experiencia de acceso sin obstáculos. ¡Únete a nuestro programa de recomendación de Discord para compartir $ 1,500 en efectivo ahora!
¿Cómo podemos raspar datos de productos de Amazon?
Sin más preámbulos, ¡comencemos oficialmente a usar Browserless para el rastreo de datos!
Requisitos previos
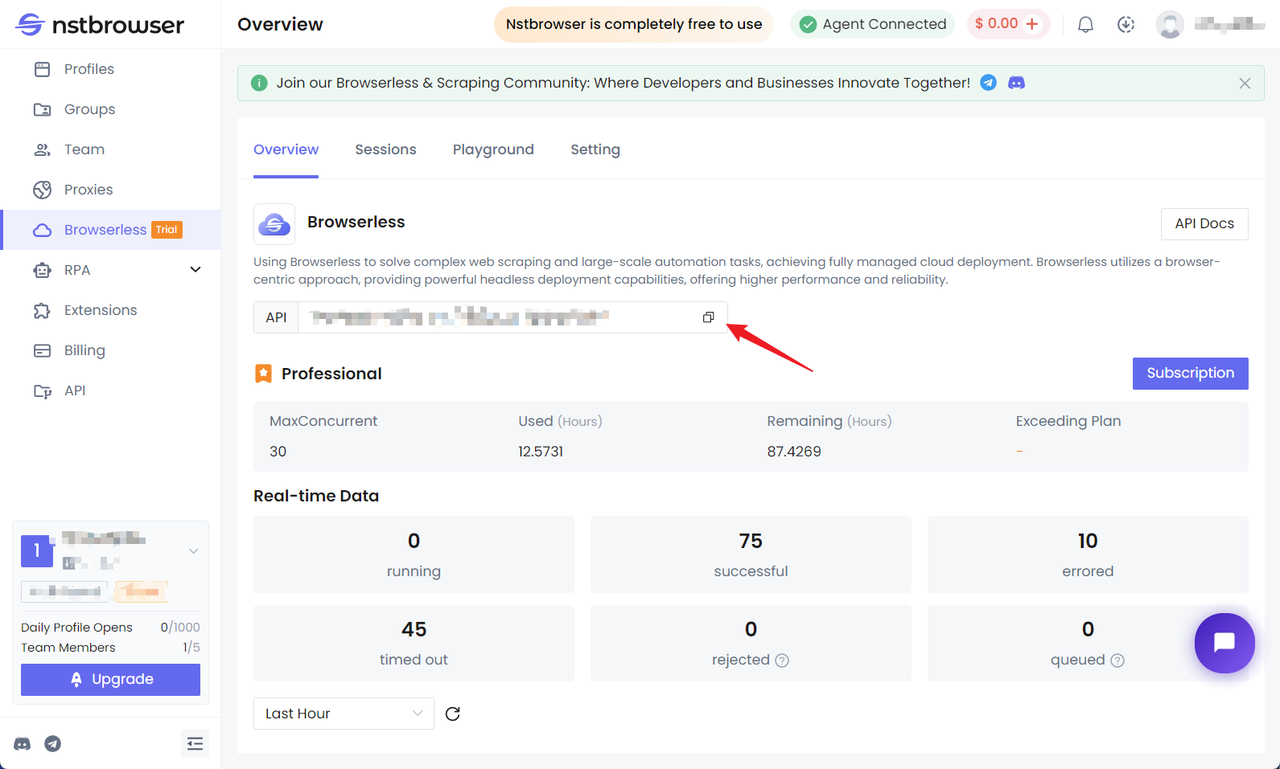
Antes de comenzar, debemos conectarnos al servicio Browserless. El uso de Browserless puede resolver tareas complejas de raspado web y automatización a gran escala, y realmente puedes disfrutar de la implementación en la nube totalmente administrada.
Browserless adopta un concepto centrado en el navegador, proporciona potentes capacidades de implementación sin cabeza y ofrece un mayor rendimiento y confiabilidad. Para obtener más información sobre Browserless, puedes consultar nuestra documentación relevante.
Obtén la API KEY y ve a la página del menú de Browserless del cliente de Nstbrowser, o puedes hacer clic aquí para acceder directamente.
Instalar Puppeteer y conectarse a Browserless
- Instala Puppeteer. El puppeteer-core más ligero es una mejor opción.
Bash
# pnpm
pnpm i puppeteer-core
# yarn
yarn add puppeteer-core
# npm
npm i --save puppeteer-core- Hemos preparado el código para llamar a Browserless. Solo necesitas completar el apiKey y el proxy para iniciar la operación posterior del raspador de productos de Amazon:
JavaScript
const apiKey = "your ApiKey"; // required
const config = {
    proxy: 'your proxy', // required; input format: schema://user:password@host:port eg: http://user:password@localhost:8080
    // platform: 'windows', // support: windows, mac, linux
    // kernel: 'chromium', // only support: chromium
    // kernelMilestone: '128', // support: 128
    // args: {
    //     "--proxy-bypass-list": "detect.nstbrowser.io"
    // }, // browser args
    // fingerprint: {
    //     userAgent: 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36', // userAgent supportted since v0.15.0
    // },
};
const query = new URLSearchParams({
    token: apiKey, // required
    config: JSON.stringify(config),
});
const browserlessWSEndpoint = `https://less.nstbrowser.io/connect?${query.toString()}`;
Comenzar a rastrear
Paso 1: Verificar la página de destino
Antes de rastrear, podemos intentar ir a https://www.amazon.com/. Si es la primera vez que visitas, es muy probable que aparezca un código de verificación:
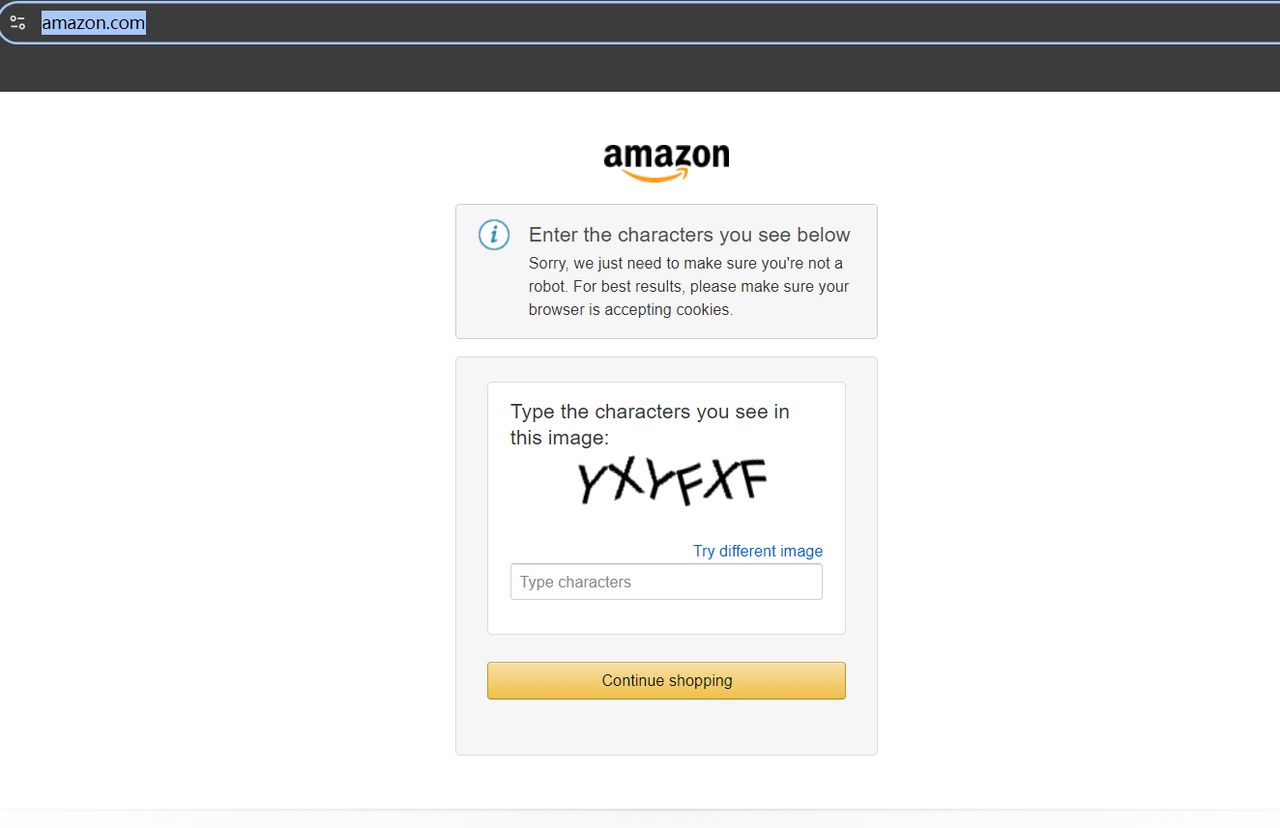
Pero no importa, no tenemos que esforzarnos para encontrar una herramienta de decodificación de código de verificación. En este momento, solo necesitas visitar el nombre de dominio de Amazon en tu región o la región de tu proxy, y el código de verificación no se activará.
Por ejemplo, visitemos: https://www.amazon.co.uk/: el nombre de dominio de Amazon en el Reino Unido. Podemos ver la página sin problemas, luego intenta ingresar la palabra clave del producto que deseas en la barra de búsqueda superior o visita directamente a través de la URL, como:
Bash
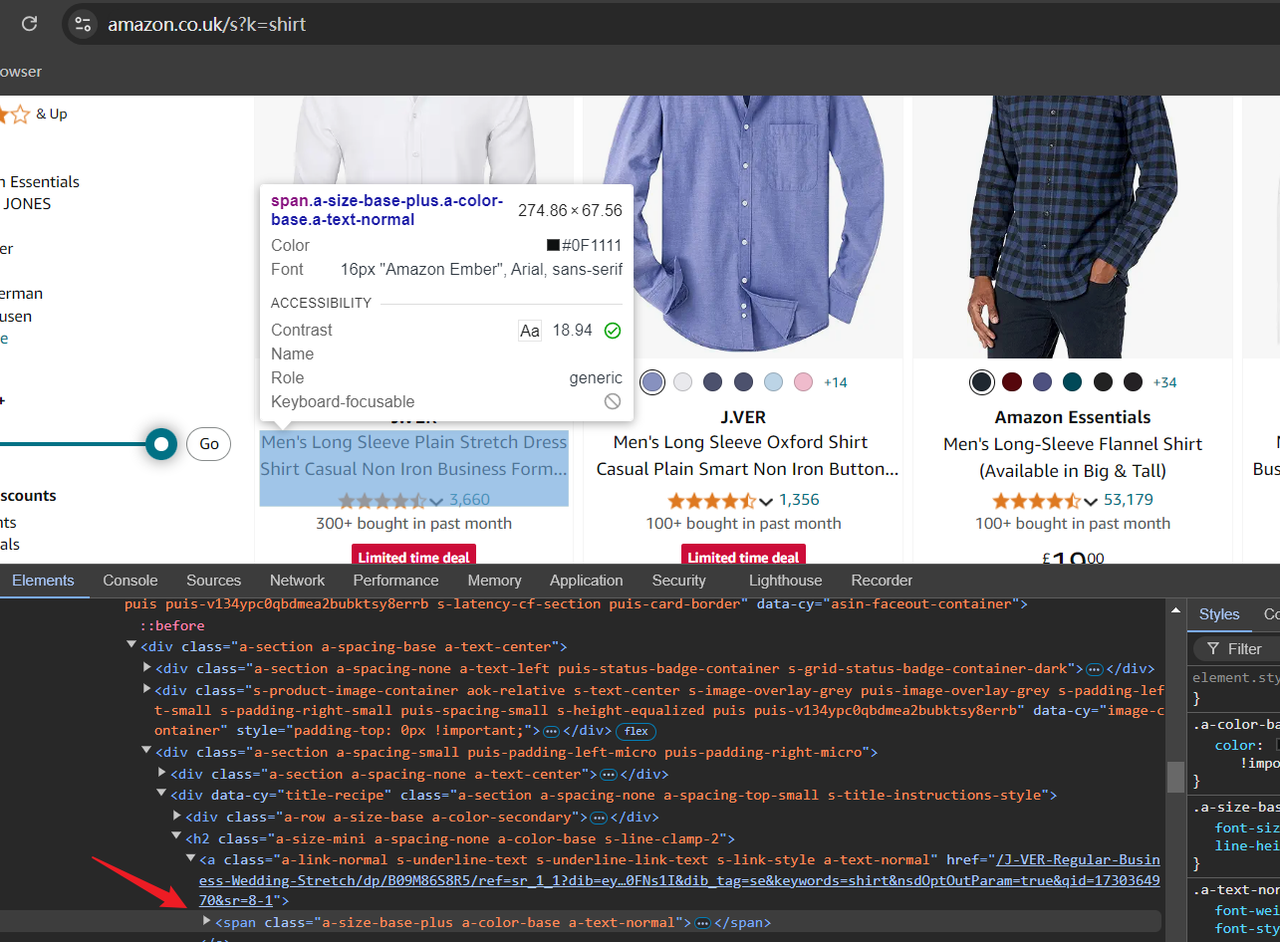
https://www.amazon.co.uk/s?k=shirtEl valor después de /s?k= en la URL es la palabra clave del producto. Al acceder a la URL anterior, verás productos relacionados con la camisa en Amazon. Ahora puedes abrir las "Herramientas para desarrolladores" (F12) para verificar la estructura HTML de la página y confirmar los datos que necesitamos rastrear más adelante posicionando el cursor.
Paso 2: Escritura de guiones
Primero, agregué una cadena de código en la parte superior del script. El siguiente código usa el primer parámetro del script como la palabra clave del producto de Amazon, y los scripts posteriores también usarán este parámetro para rastrear:
JavaScript
const productName = process.argv.slice(2);

if (productName.length !== 1) {
  console.error('product name CLI arguments missing!');
  process.exit(2);
}
A continuación, necesitamos:
- Importar Puppeteer y conectarse a Browserless
- Ir a la página de resultados de la consulta de producto correspondiente a Amazon
- Agregar una captura de pantalla para verificar si el acceso es exitoso
JavaScript
import puppeteer from "puppeteer-core";

const browser = await puppeteer.connect({
  browserWSEndpoint: browserlessWSEndpoint,
  defaultViewport: null,
})
console.info('Connected!');

const page = await browser.newPage();

await page.goto(`https://www.amazon.co.uk/s?k=${productName}`);

// Agregar capturas de pantalla para facilitar la resolución de problemas posteriores
await page.screenshot({ path: 'amazon_page.png' })
Ahora usamos page.$$ para obtener una lista de todos los productos, recorremos la lista de productos y obtenemos los datos relevantes uno por uno en el bucle. Luego, recopila estos datos en la matriz productDataList e imprímelo:
JavaScript
// Obtener el elemento contenedor de todos los resultados de la búsqueda
const productContainers = await page.$$('div[data-component-type="s-search-result"]')

const productDataList = []

// Obtener información diversa sobre el producto: título, calificación, enlace de imagen, precio
for (const product of productContainers) {

  async function safeEval(selector, evalFn) {
    try {
      return await product.$eval(selector, evalFn);
    } catch (e) {
      return null;
    }
  }

  const title = await safeEval('.s-title-instructions-style > h2 > a > span', node => node.textContent)
  const rate = await safeEval('a > i.a-icon.a-icon-star-small > span', node => node.textContent)
  const img = await safeEval('span[data-component-type="s-product-image"] img', node => node.getAttribute('src'))
  const price = await safeEval('div[data-cy="price-recipe"] .a-offscreen', node => node.textContent)

  productDataList.push({ title, rate, img, price })
}

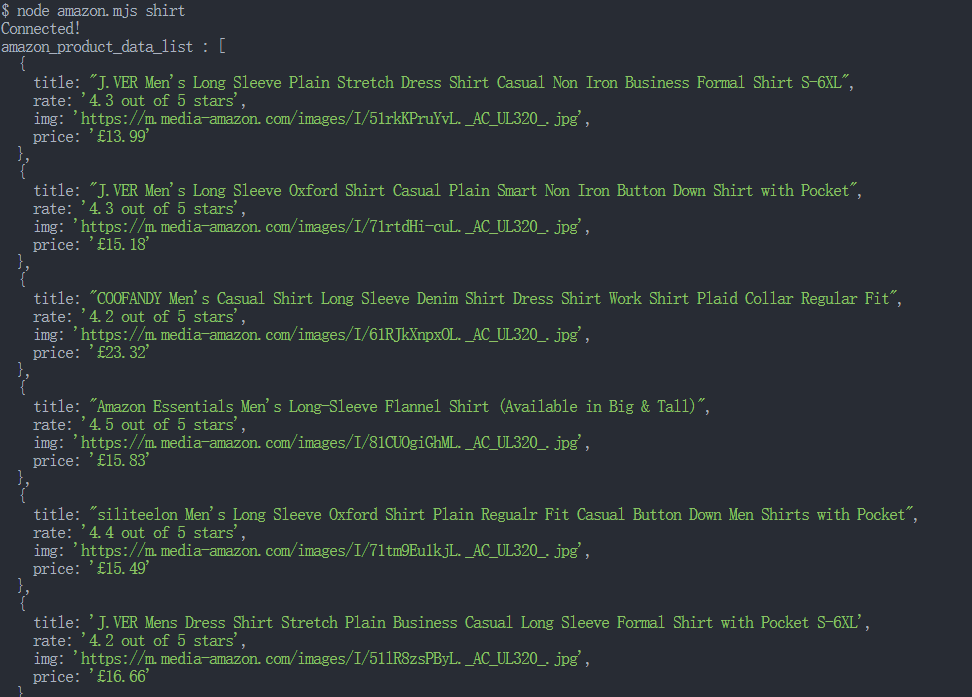
console.log('amazon_product_data_list :', productDataList);

await browser.close();
Ejecutar el script:
Bash
node amazon.mjs shirtSi tiene éxito, se imprimirá lo siguiente en la consola:
Paso 3: Salida de los datos rastreados como un archivo JSON
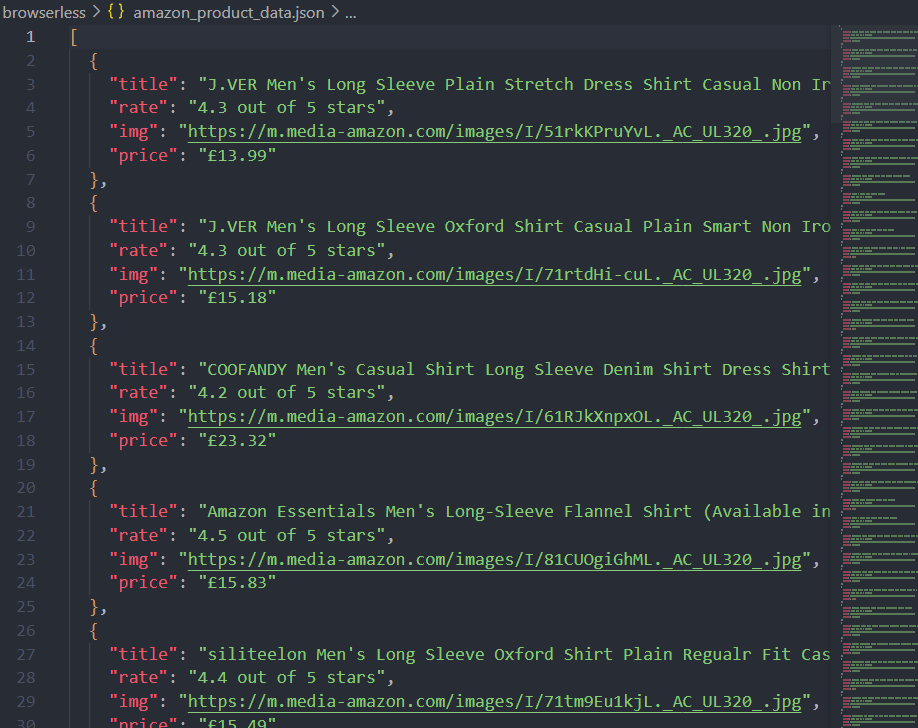
Obviamente, para analizar mejor los datos, no es suficiente simplemente imprimir los datos en la consola. Aquí hay un ejemplo simple: convierte rápidamente un objeto JS a un archivo JSON a través del módulo fs:
JavaScript
import fs from 'fs'

function saveObjectToJson(obj, filename) {
  const jsonString = JSON.stringify(obj, null, 2)
  fs.writeFile(filename, jsonString, 'utf8', (err) => {
    err ? console.error(err) : console.log(`File saved successfully: ${filename}`);
  });
}

saveObjectToJson(productDataList, 'amazon_product_data.json')
Bueno, echemos un vistazo a nuestro código completo:
JavaScript
import puppeteer from "puppeteer-core";
import fs from 'fs'

const productName = process.argv.slice(2);

if (productName.length !== 1) {
  console.error('product name CLI arguments missing!');
  process.exit(2);
}

const apiKey = "your ApiKey"; // 'your proxy'

const config = {
  proxy: 'your proxy', // required; input format: schema://user:password@host:port eg: http://user:password@localhost:8080
  // platform: 'windows', // support: windows, mac, linux
  // kernel: 'chromium', // only support: chromium
  // kernelMilestone: '128', // support: 128
  // args: {
  //     "--proxy-bypass-list": "detect.nstbrowser.io"
  // }, // browser args
  // fingerprint: {
  //     userAgent: 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/128.0.6613.85 Safari/537.36', // userAgent supportted since v0.15.0
  // },
};

const query = new URLSearchParams({
  token: apiKey, // required
  config: JSON.stringify(config),
});

const browserlessWSEndpoint = `https://less.nstbrowser.io/connect?${query.toString()}`;

const browser = await puppeteer.connect({
  browserWSEndpoint: browserlessWSEndpoint,
  defaultViewport: null,
})
console.info('Connected!');

const page = await browser.newPage();

await page.goto(`https://www.amazon.co.uk/s?k=${productName}`);

// Agregar capturas de pantalla para facilitar la resolución de problemas posteriores
await page.screenshot({ path: 'amazon_page.png' })

// Obtener el elemento contenedor de todos los resultados de la búsqueda
const productContainers = await page.$$('div[data-component-type="s-search-result"]')

const productDataList = []

// Obtener información diversa sobre el producto: título, calificación, enlace de imagen, precio
for (const product of productContainers) {

  async function safeEval(selector, evalFn) {
    try {
      return await product.$eval(selector, evalFn);
    } catch (e) {
      console.log(`Error fetching ${selector}:`, e);
      return null;
    }
  }

  const title = await safeEval('.s-title-instructions-style > h2 > a > span', node => node.textContent)
  const rate = await safeEval('a > i.a-icon.a-icon-star-small > span', node => node.textContent)
  const img = await safeEval('span[data-component-type="s-product-image"] img', node => node.getAttribute('src'))
  const price = await safeEval('div[data-cy="price-recipe"] .a-offscreen', node => node.textContent)

  productDataList.push({ title, rate, img, price })
}

function saveObjectToJson(obj, filename) {
  const jsonString = JSON.stringify(obj, null, 2)
  fs.writeFile(filename, jsonString, 'utf8', (err) => {
    err ? console.error(err) : console.log(`File saved successfully: ${filename}`);
  });
}

saveObjectToJson(productDataList, 'amazon_product_data.json')

console.log('amazon_product_data_list :', productDataList);

await browser.close();
Ahora, después de ejecutar el script, no solo puedes ver la impresión de la consola, sino también el archivo amazon_product_data.json escrito en la ruta actual.
Verificar el panel de Browserless
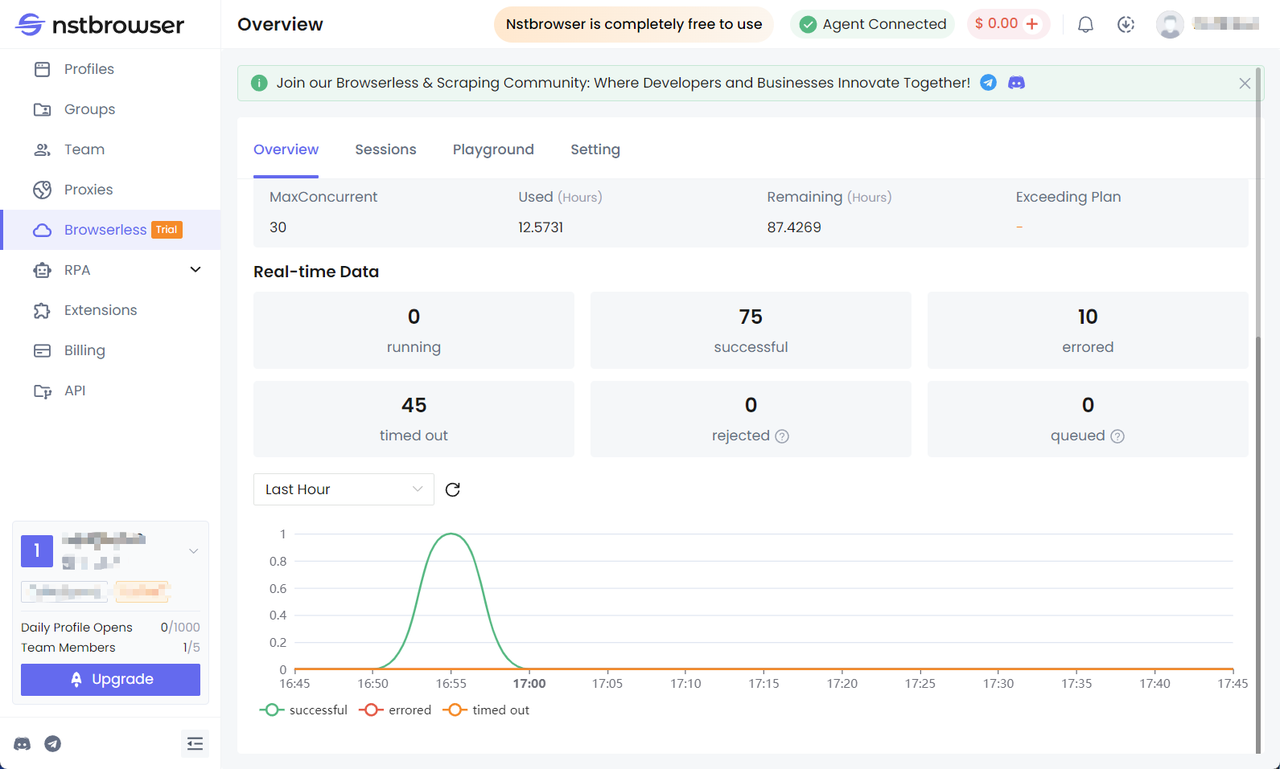
Puedes ver las estadísticas de las solicitudes recientes y el tiempo de sesión restante en el menú de Browserless del cliente de Nstbrowser.
Nstbrowser RPA: una forma más fácil de construir tu raspador de productos de Amazon
Usar herramientas RPA para rastrear datos web es un método común de recopilación de datos. El uso de herramientas RPA puede mejorar en gran medida la eficiencia de la recopilación de datos y reducir el costo de la recopilación. La función Nstbrowser RPA puede proporcionarte la mejor experiencia RPA y la mejor eficiencia laboral.
Después de leer este tutorial, podrás:
- Comprender cómo usar RPA para la recopilación de datos
- Comprender cómo guardar los datos recopilados por RPA
Preparación
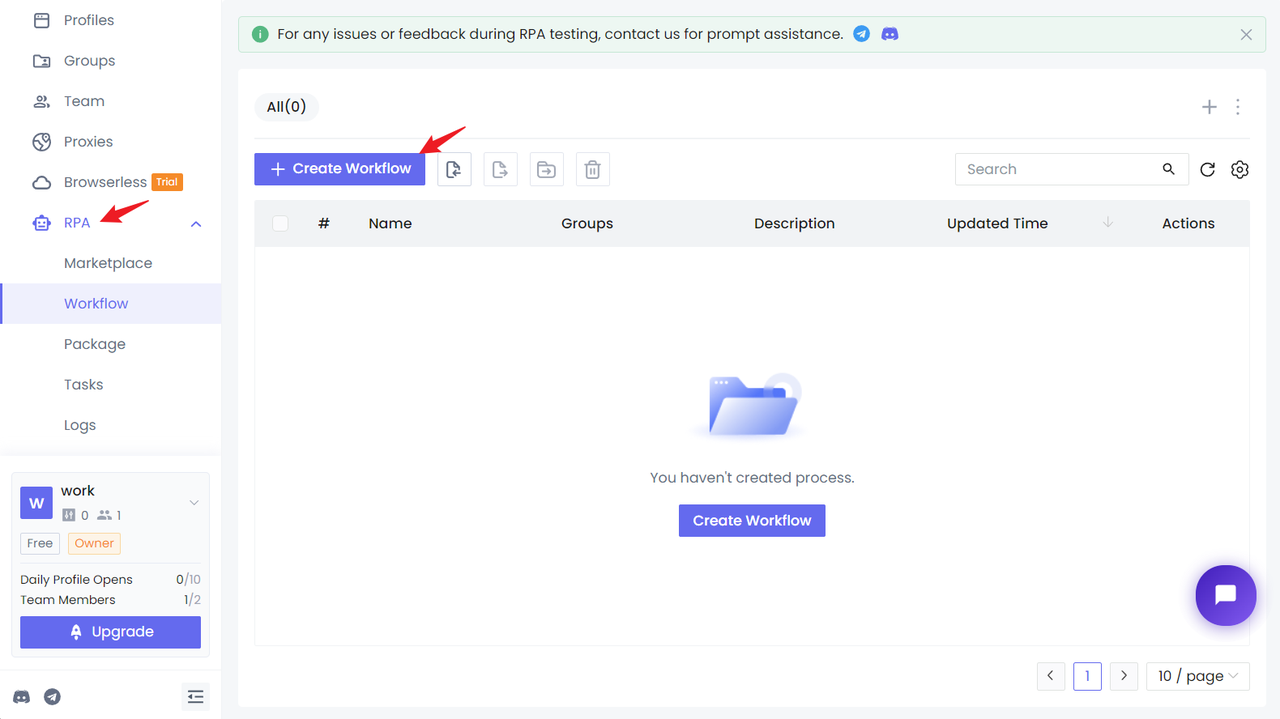
Primero, necesitas tener una cuenta de Nstbrowser, y luego inicia sesión en el cliente de Nstbrowser, ingresa a la página de flujo de trabajo del módulo RPA y haz clic en Nuevo flujo de trabajo.
Ahora, podemos comenzar a configurar el flujo de trabajo de rastreo RPA basado en los resultados de la búsqueda de productos de Amazon.
Paso 1. Visitar el sitio web de destino
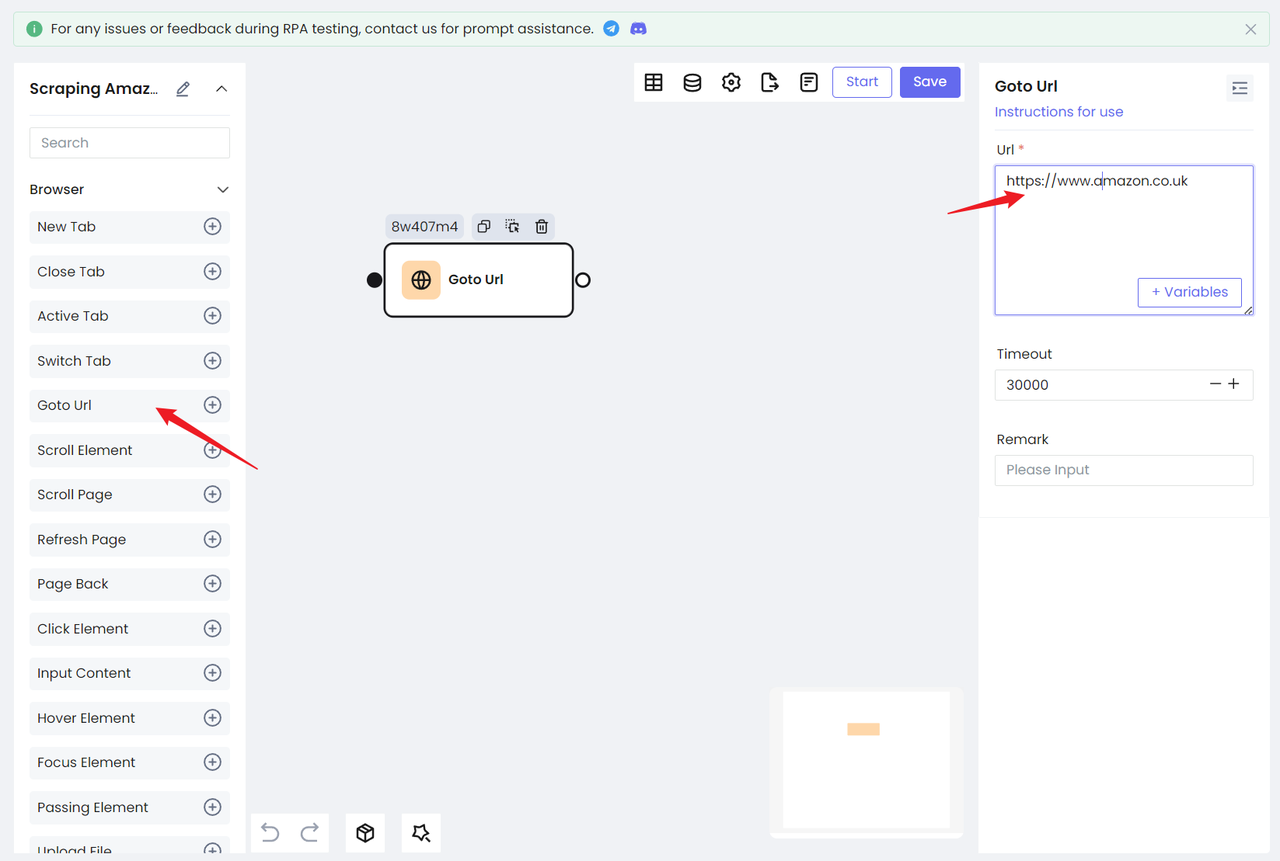
- Debemos visitar nuestro sitio web de destino: https://www.amazon.co.uk;
- También puedes usar el sitio principal de Amazon directamente: https://www.amazon.com/, pero debes procesar manualmente el código de verificación para la primera visita;
- Usa el nodo
Goto Url, configura la URL del sitio web y puedes visitar el sitio web de destino:
Paso 2. Buscar contenido de destino
Esta vez no usaremos el método de consultar el producto correspondiente a través de la URL, sino que usaremos RPA para ayudar a ingresar al cuadro de entrada en la página de inicio y luego activar el salto de consulta. Esto no solo nos hará más familiarizados con el funcionamiento de RPA, sino que también evitará el control de riesgos del sitio en mayor medida.
Bueno, después de llegar al sitio web de destino, necesitamos buscar primero la dirección de destino. Aquí necesitamos usar la herramienta Chrome Devtool para localizar el elemento HTML.
- Abre la herramienta Devtool y selecciona el cuadro de búsqueda con el ratón. Podemos ver:
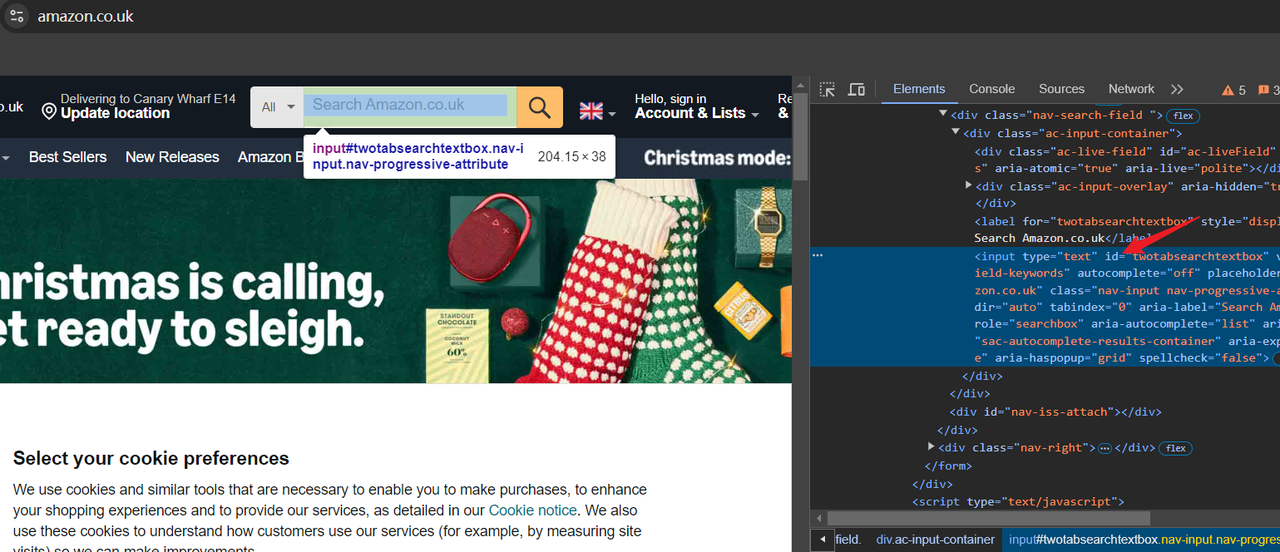
- Nuestro cuadro de entrada de elemento objetivo tiene un atributo id, que se puede usar como un selector CSS para localizar el cuadro de entrada.
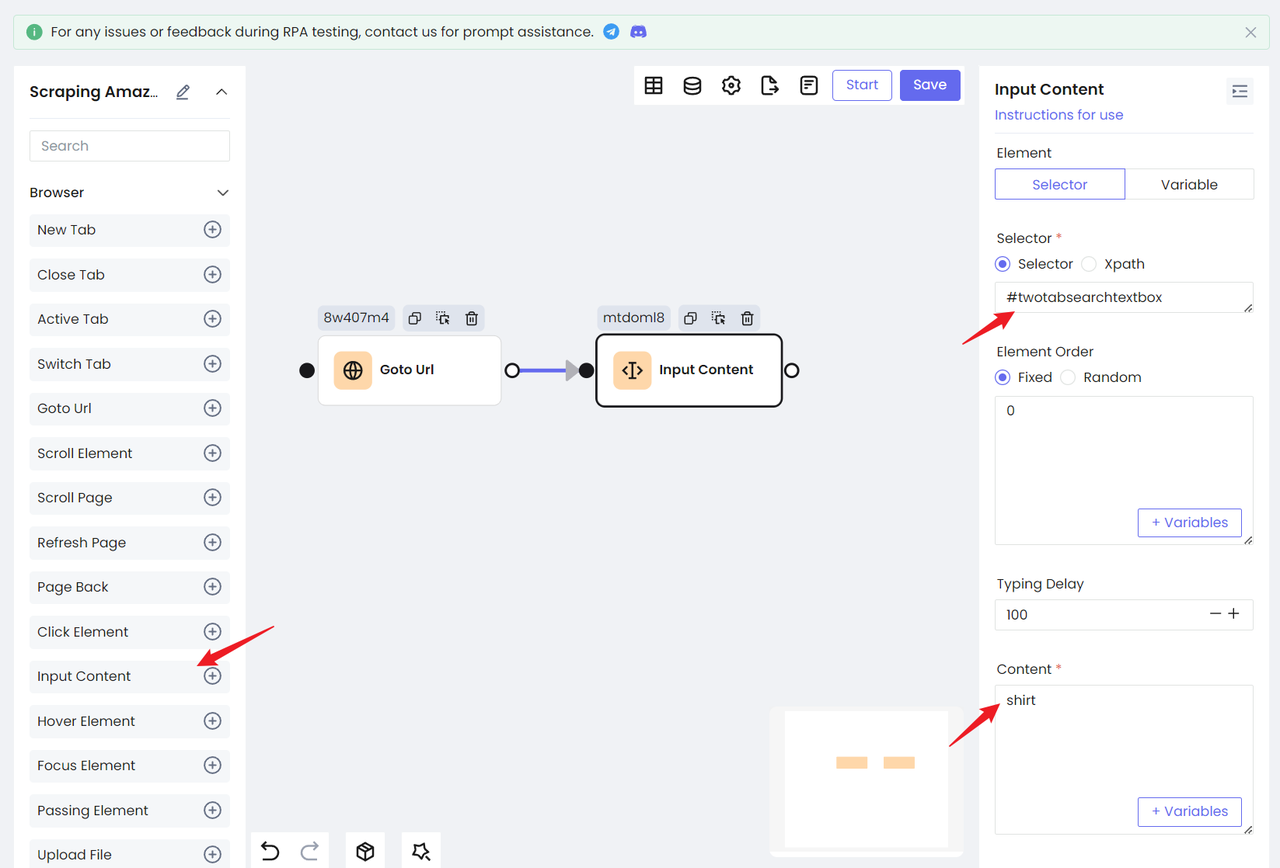
Agregar nodo Input Content:
- Selecciona Selector en la opción Elemento. Esta opción selecciona uniformemente Selector.
- Completa el selector CSS del
idque estamos ubicando en el cuadro de entrada - y luego ingresa el contenido que desea buscar en la opción Contenido.
De esta manera, hemos completado la acción de ingresar al cuadro de entrada.
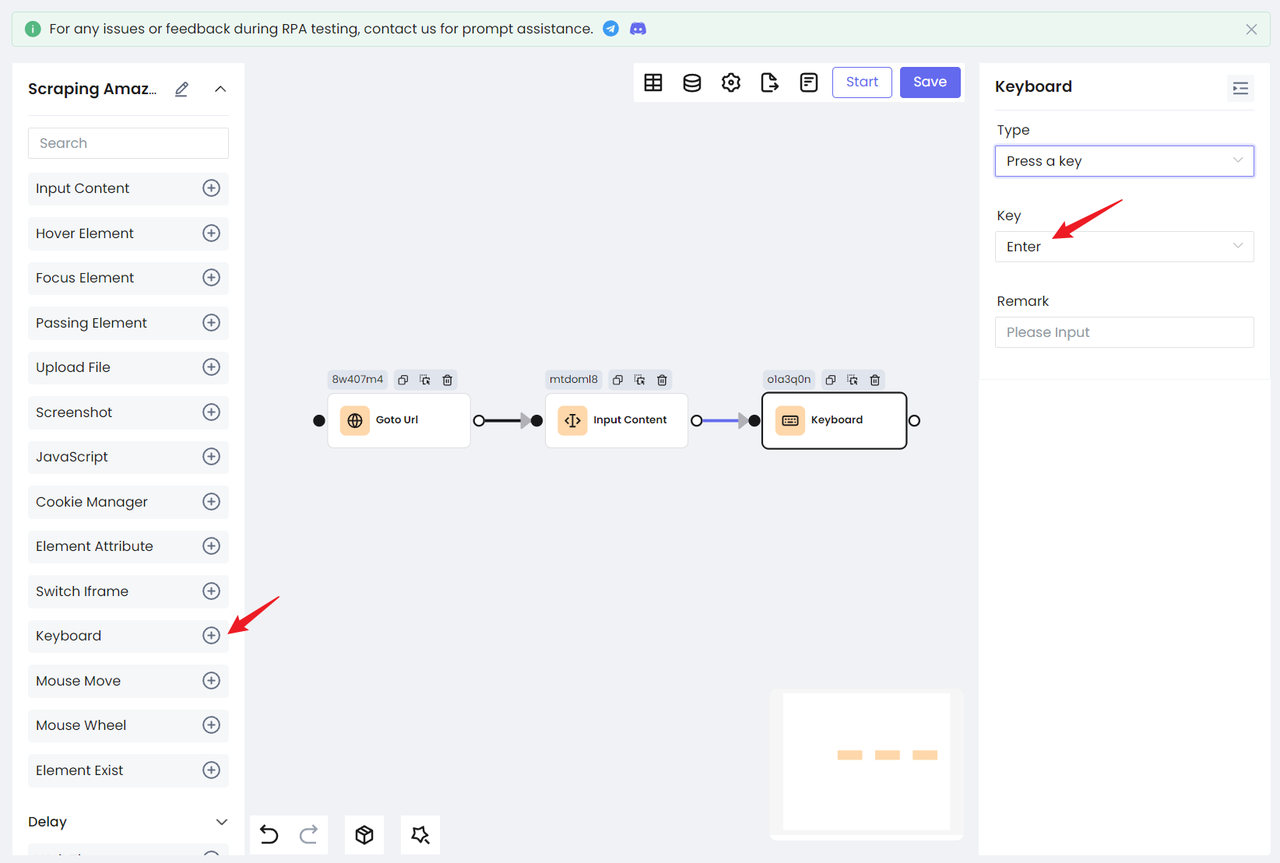
- Luego, usa el nodo
Keyboardpara simular la acción de entrada del teclado para buscar productos:
Debido a que la página de búsqueda saltará a una nueva página, debemos agregar una acción de espera para asegurarnos de que hayamos cargado correctamente la página de resultados. Nstbrowser RPA proporciona dos comportamientos de espera: Wait Time y Wait Request.
Wait Time: usado para esperar un período de tiempo. Puedes elegir un tiempo fijo o un tiempo aleatorio según tu situación específica.Wait Request: usado para esperar a que la solicitud de red finalice. Aplicable a la situación de obtener datos a través de solicitudes de red.
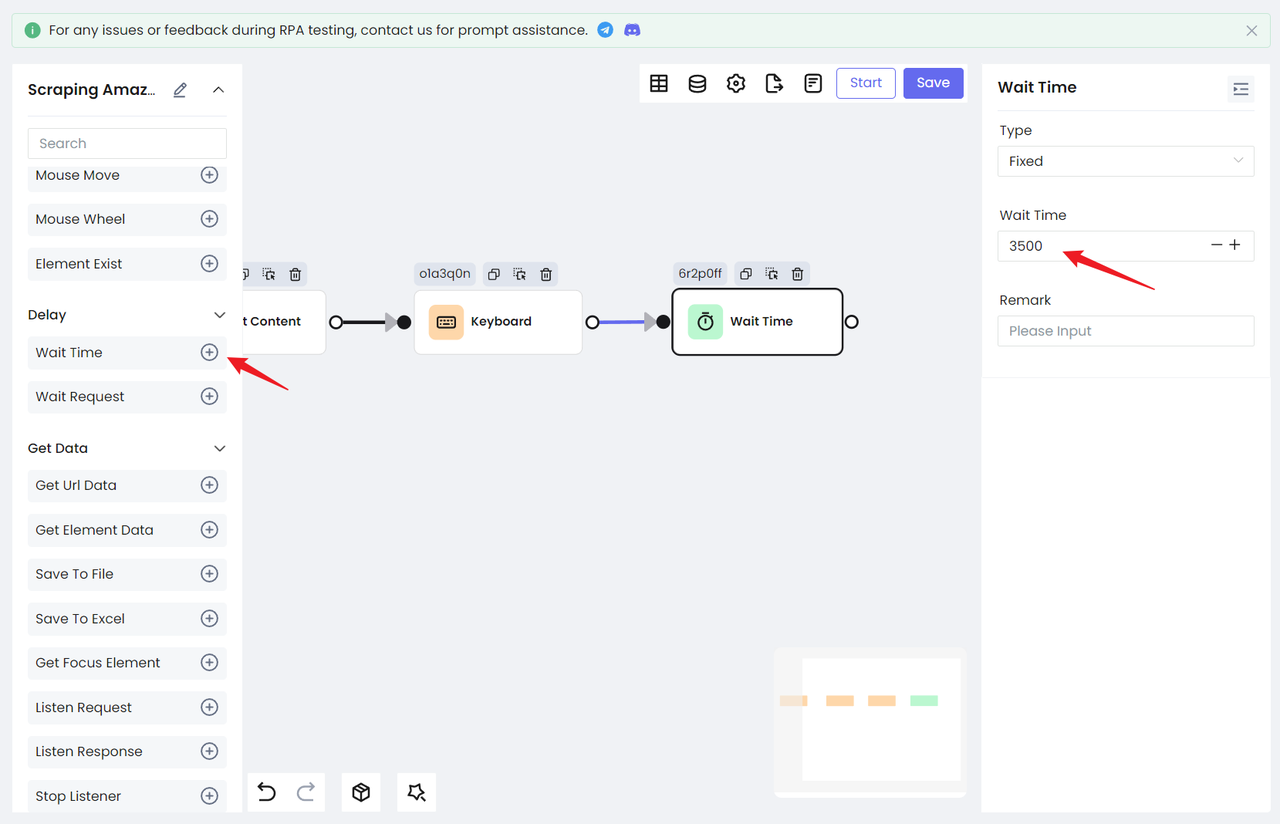
Paso 3. Recorrer la lista de productos
Bueno, ahora podemos ver correctamente la nueva página de búsqueda de productos, y el siguiente paso es rastrear estos contenidos.
Mediante la observación, podemos encontrar que los resultados de búsqueda de Amazon se muestran en forma de una lista de tarjetas. Este es un método de visualización muy clásico:
De manera similar, abre la herramienta Devtool y ubica cada dato en la tarjeta:
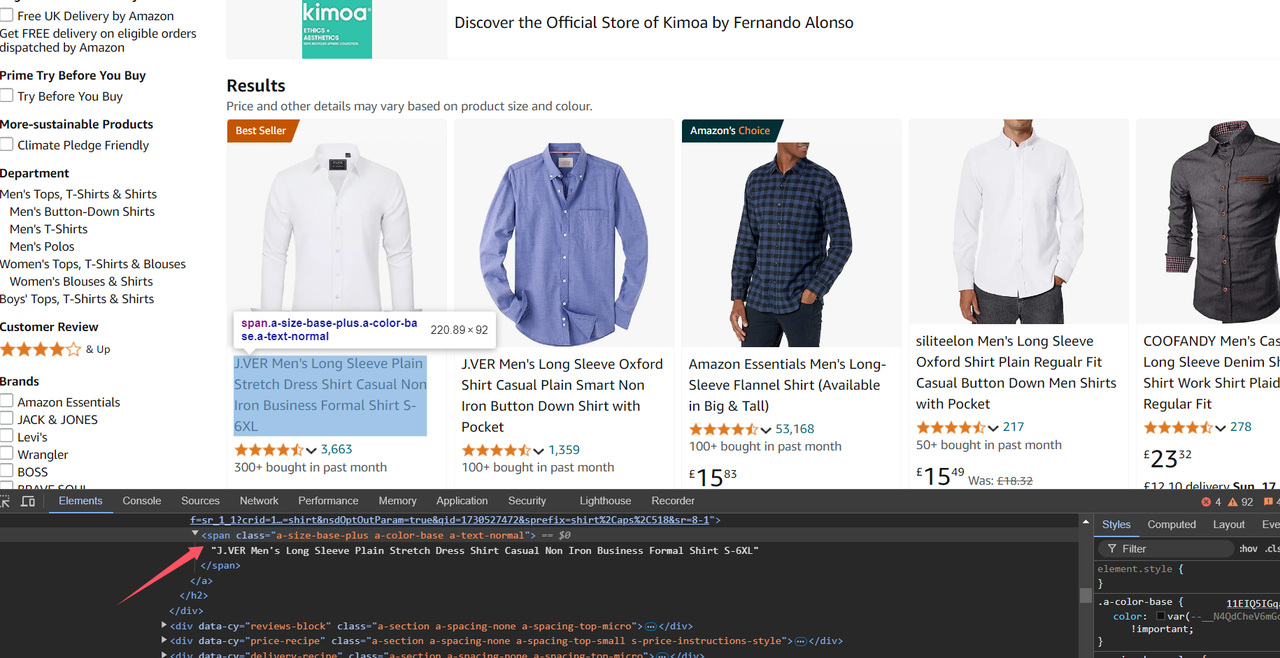
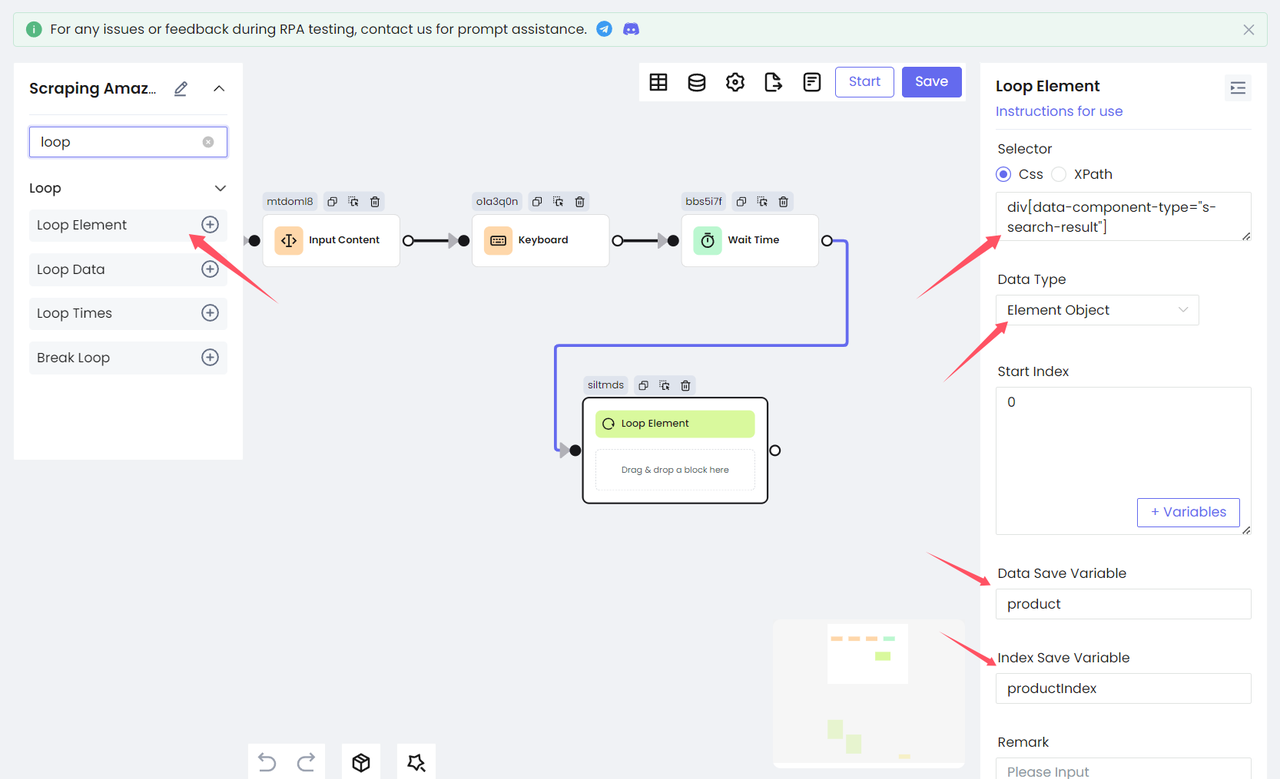
Debido a que cada elemento en la lista de tarjetas es un elemento HTML, necesitamos usar el nodo Loop Element para recorrer todos los resultados de la consulta. Completamos el selector CSS de la lista product en Selector y seleccionamos Element Object para Data Type, lo que significa obtener el elemento objetivo y guardarlo como un objeto de elemento en una variable. Establecer el nombre de la variable en product a través de Data Save Variable, y guardar el índice como productIndex.
Paso 4. Obtener datos
A continuación, debemos procesar cada elemento recorrido y obtener la información que necesitamos de la product. Obtenemos el elemento título del producto. Aquí necesitamos usar el nodo Get Element Data para obtenerlo y finalmente guardarlo como la variable title.
Selecciona Children como Data Type, lo que significa obtener los elementos secundarios del elemento objetivo y guardarlo como un objeto de elemento en la variable title. Debes completar el selector de elemento del elemento secundario. El selector CSS ingresado aquí es naturalmente el selector CSS del título del producto:
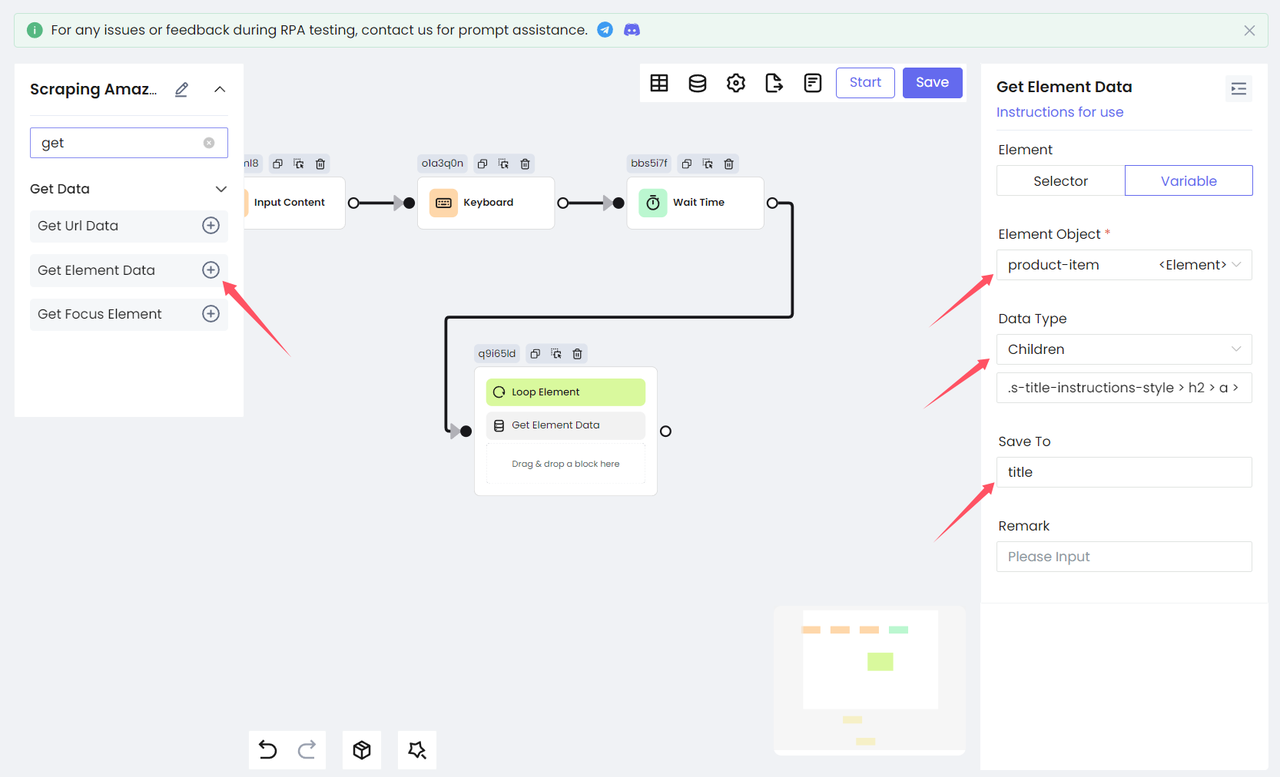
Luego, usamos el mismo método para convertir la información restante del producto: calificaciones, enlaces de imagen y precios, todo en procesos RPA.
- Nombres de variables y selectores CSS de hijos:
Bash
'title' .s-title-instructions-style > h2 > a > span
'rate' a > i.a-icon.a-icon-star-small > span
'img' span[data-component-type="s-product-image"] img
'price' div[data-cy="price-recipe"] .a-offscreen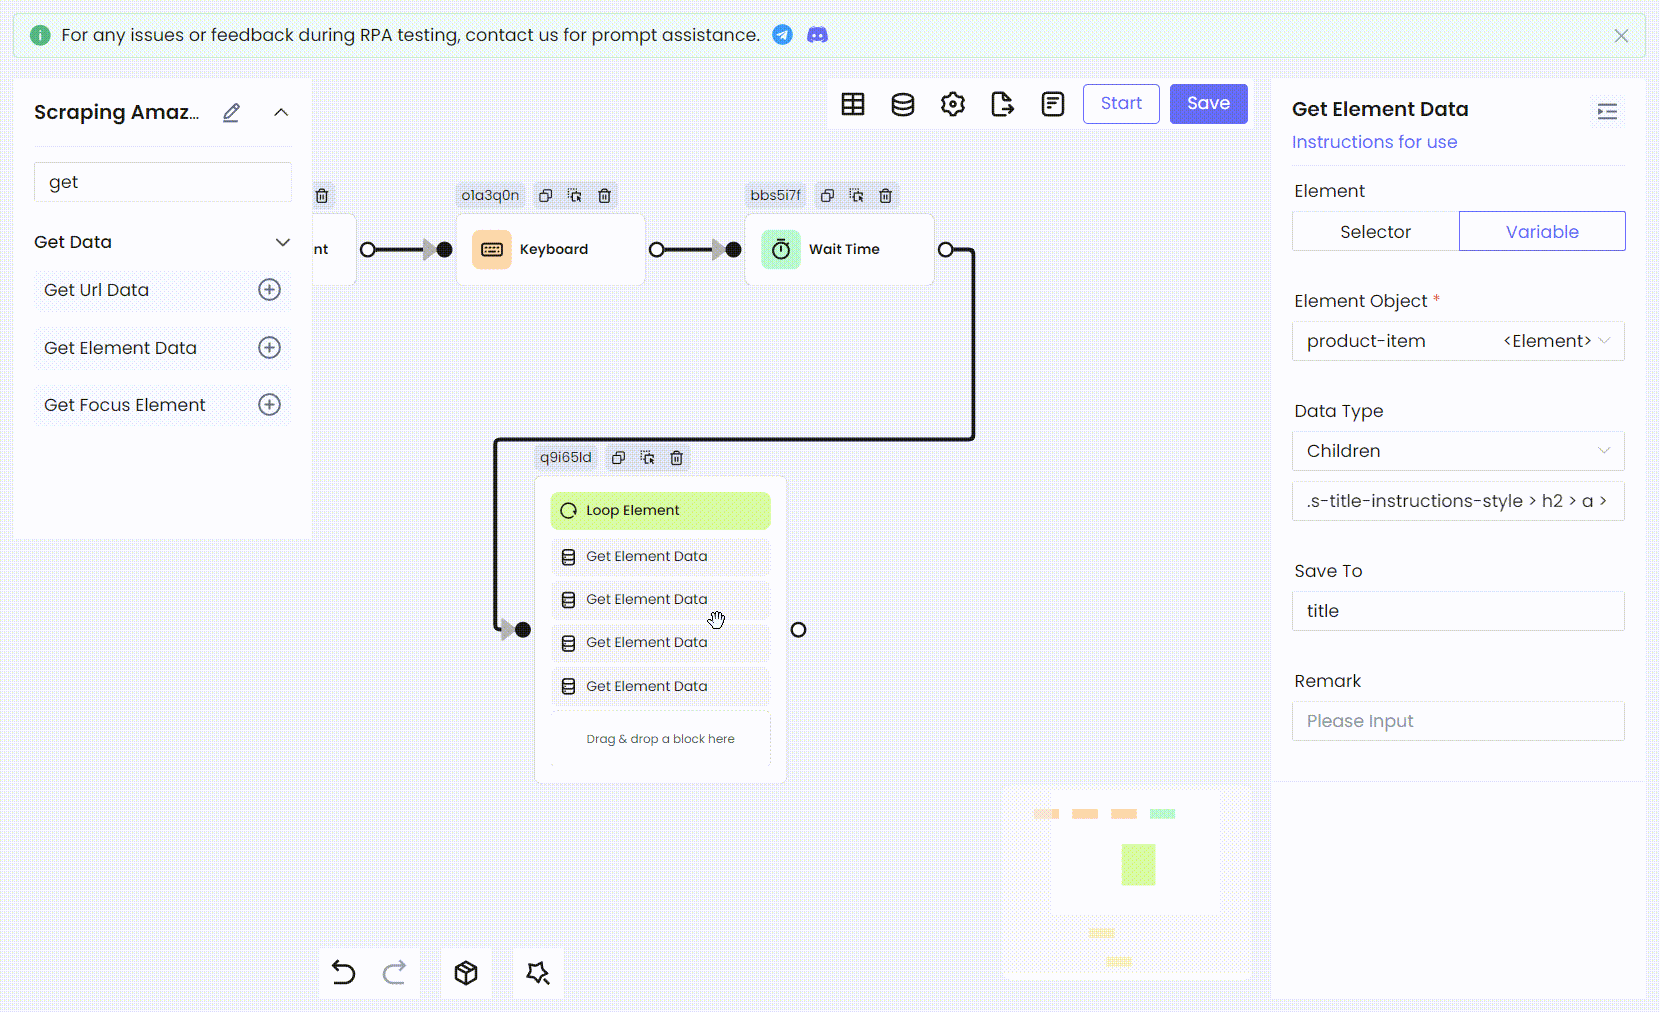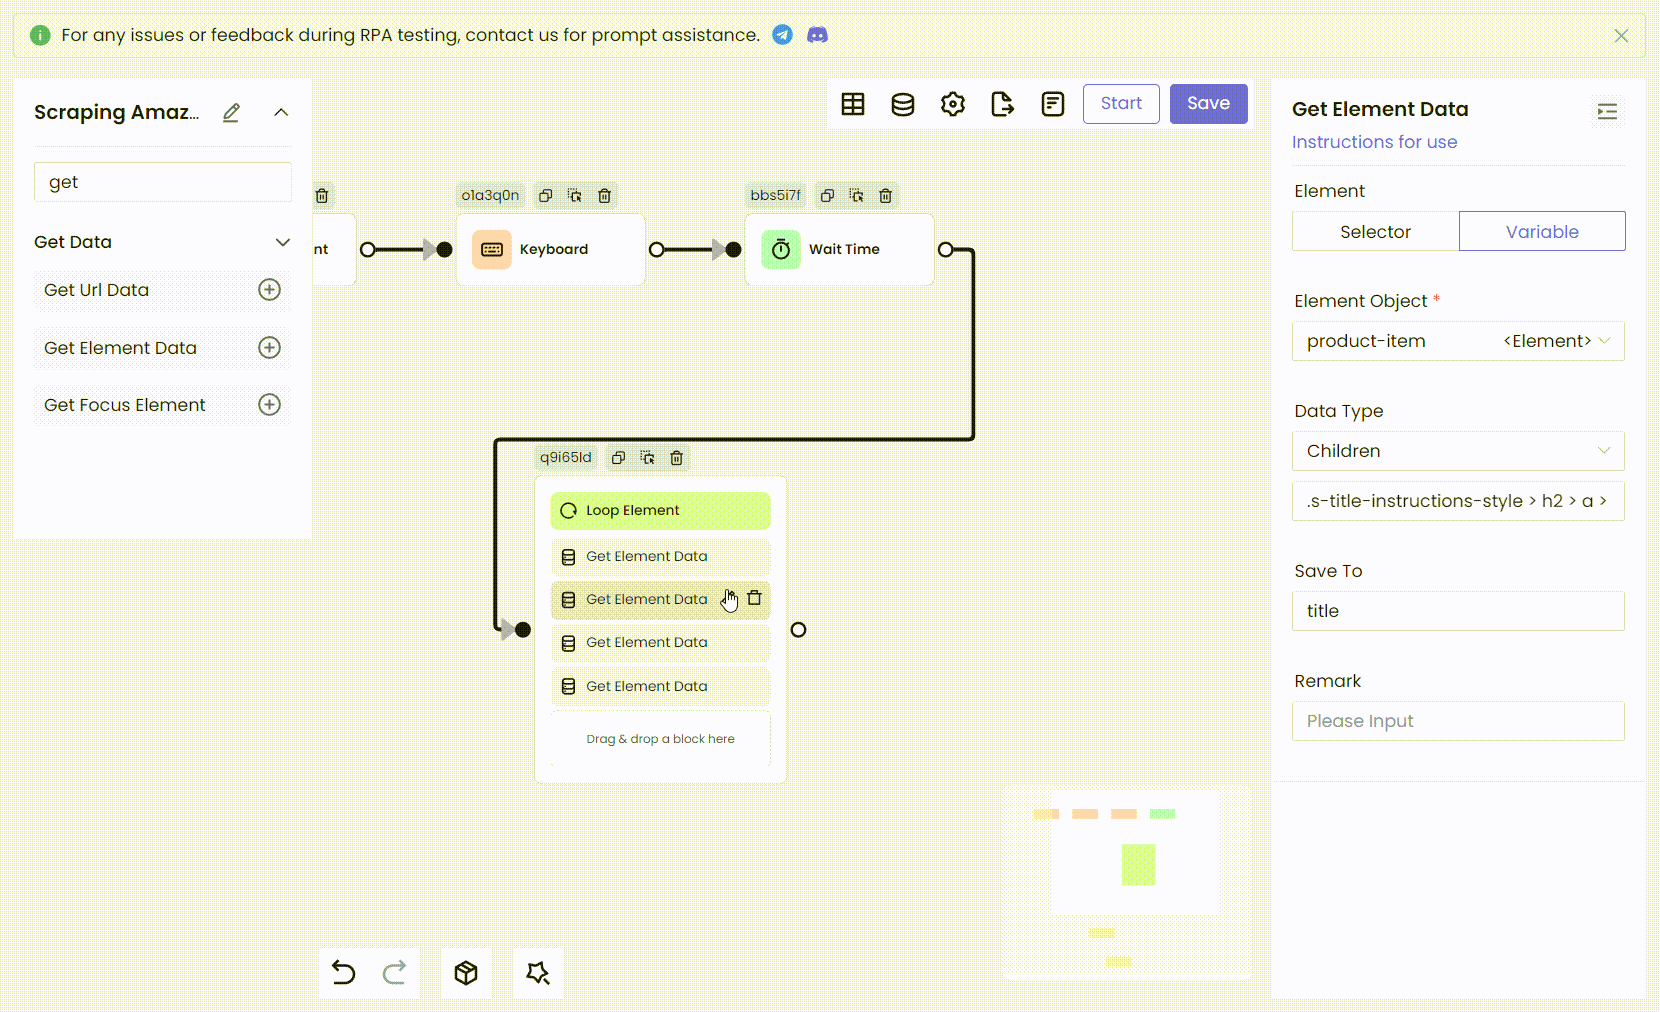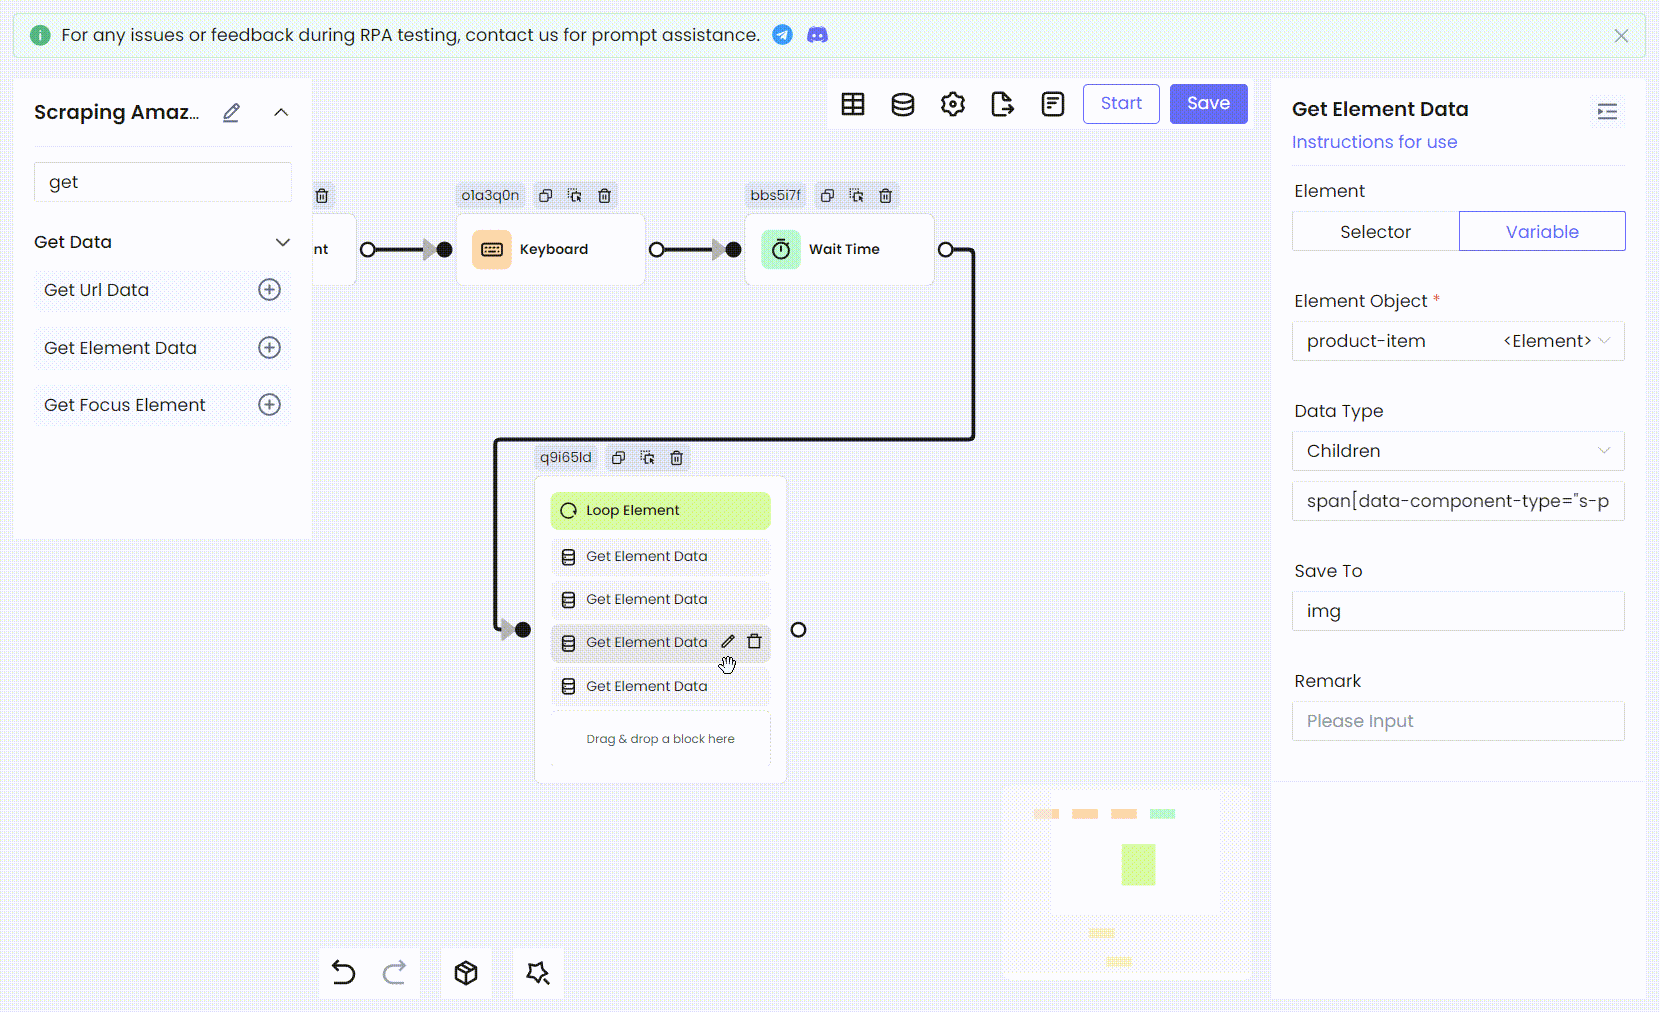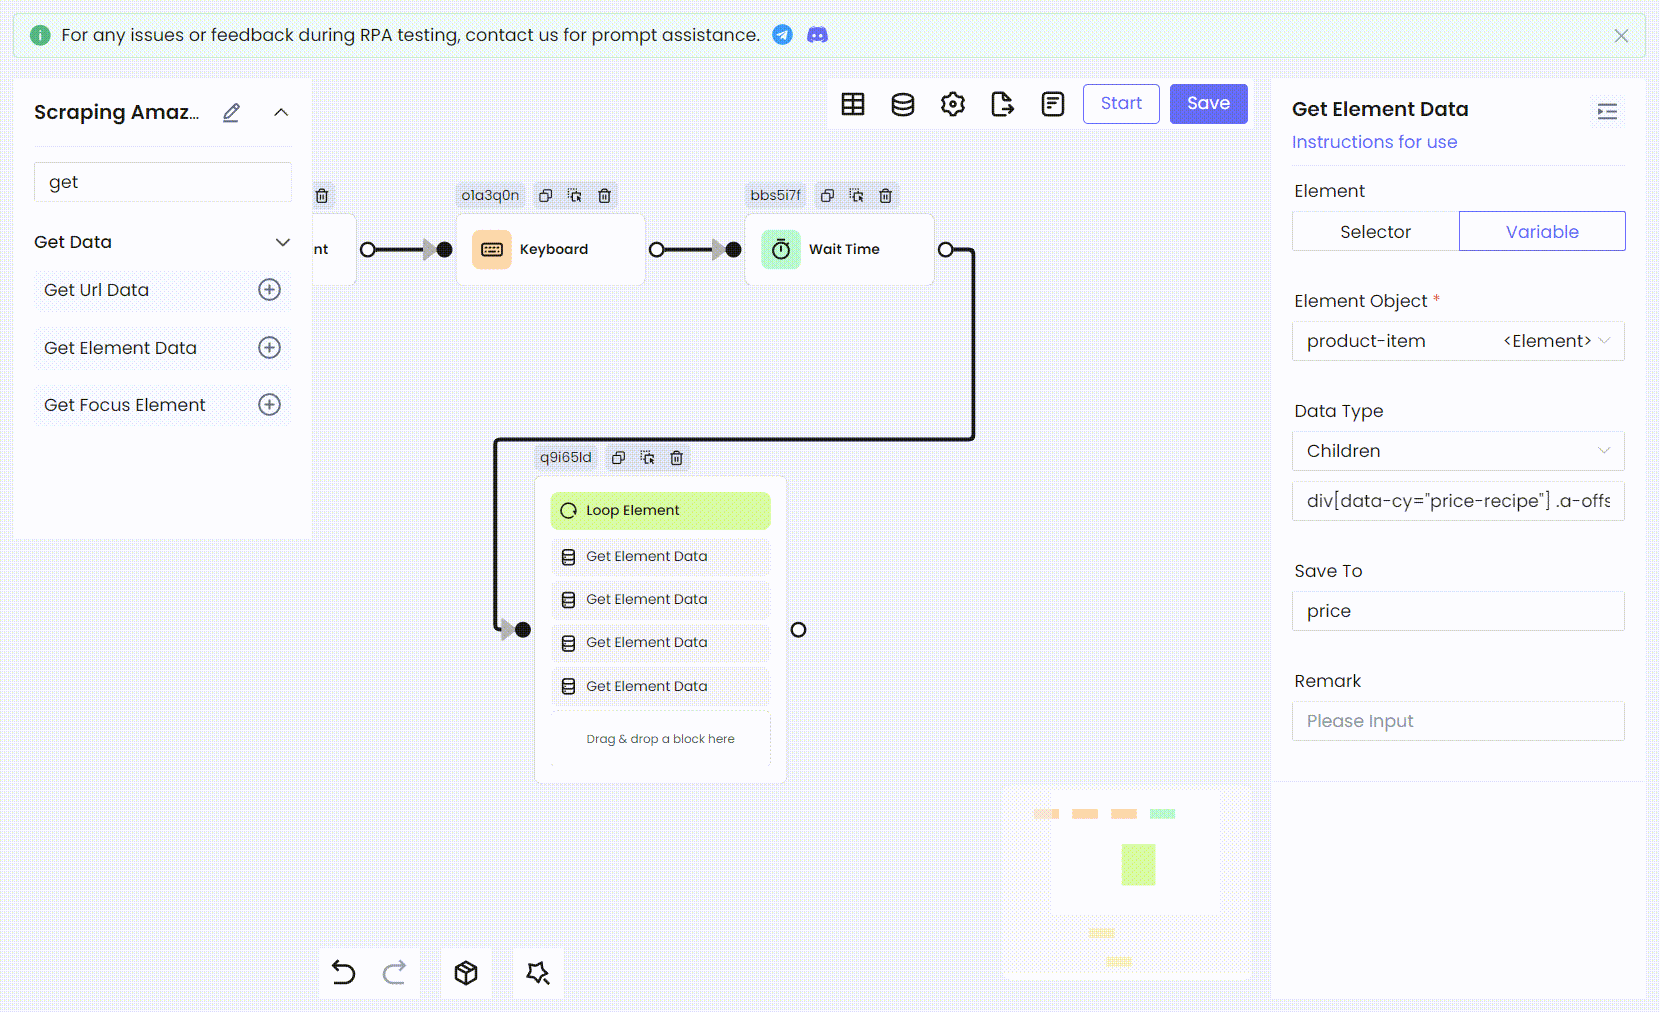
Sin embargo, los datos variables obtenidos anteriormente son en realidad elementos HTML. Todavía necesitamos procesarlos para generar el texto en los elementos HTML y prepararnos para el almacenamiento de datos posterior.
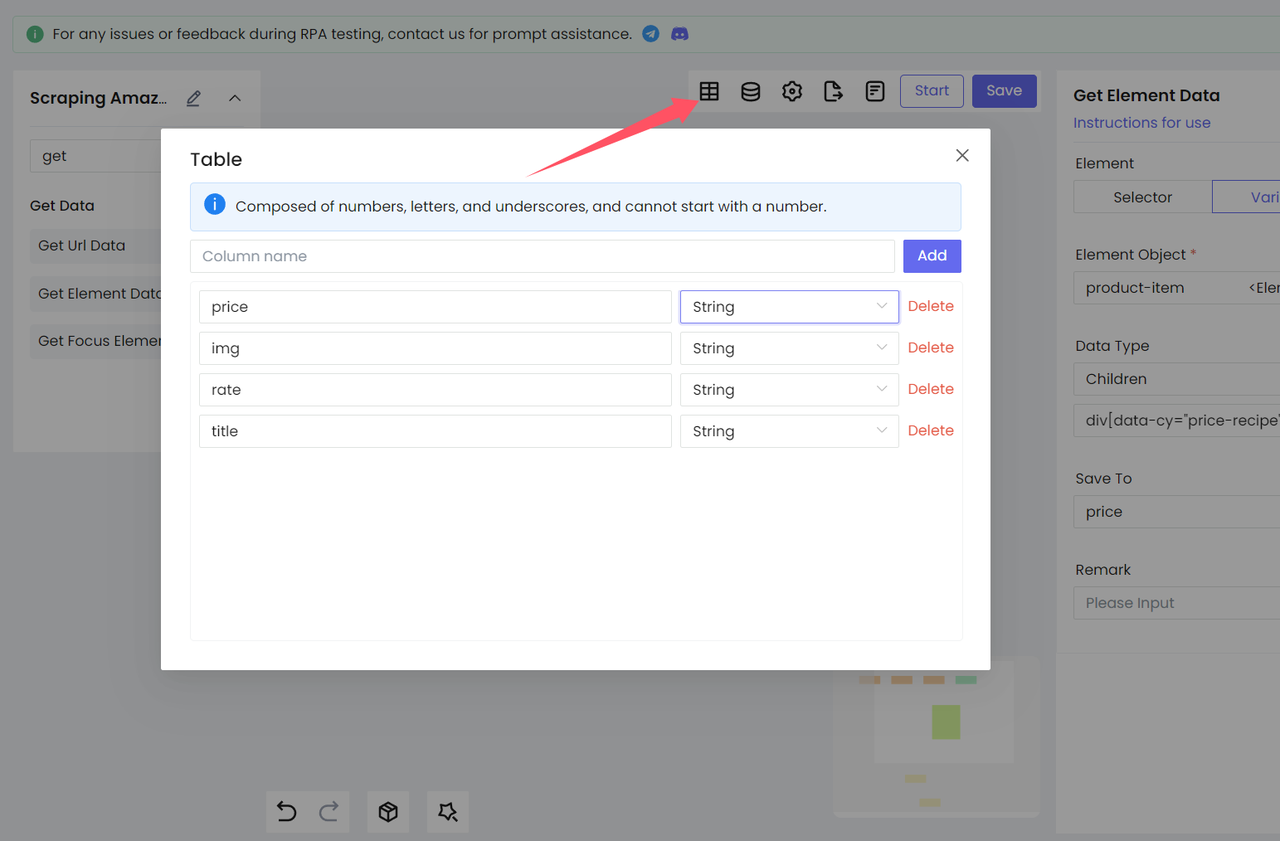
- Configurar la tabla
Necesitamos
- Configurar la tabla
- Y generar el Excel correspondiente en función de los campos de esta tabla:
- Obtener el texto del elemento
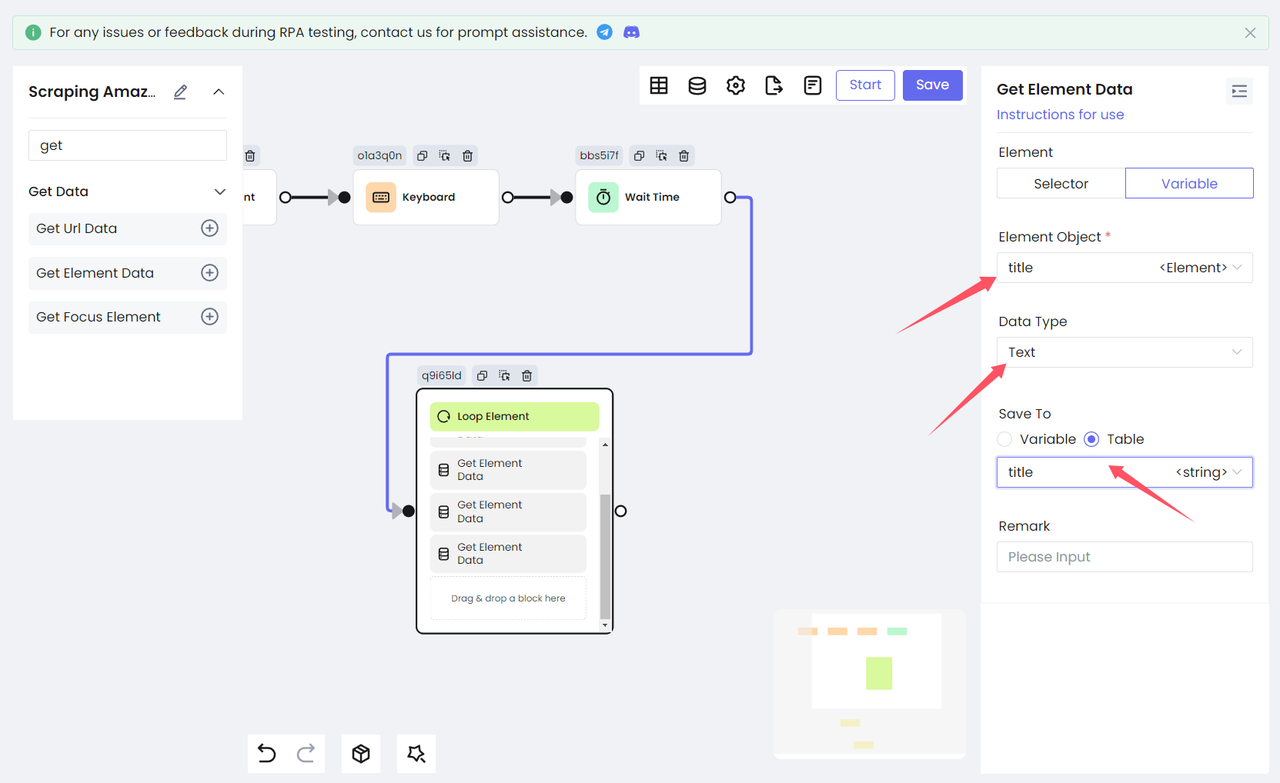
Agrega nuevamente el nodo Get Element Data para generar las variables obtenidas anteriormente como texto y guardarlas en la variable de tabla para el almacenamiento de datos posterior. Selecciona Data Type como Text para obtener el innerText del elemento objetivo. (La figura a continuación muestra el procesamiento de la variable title)
- Obtener el enlace a la imagen
Luego, usamos el mismo método para convertir la calificación y el precio del producto en la información de texto final.
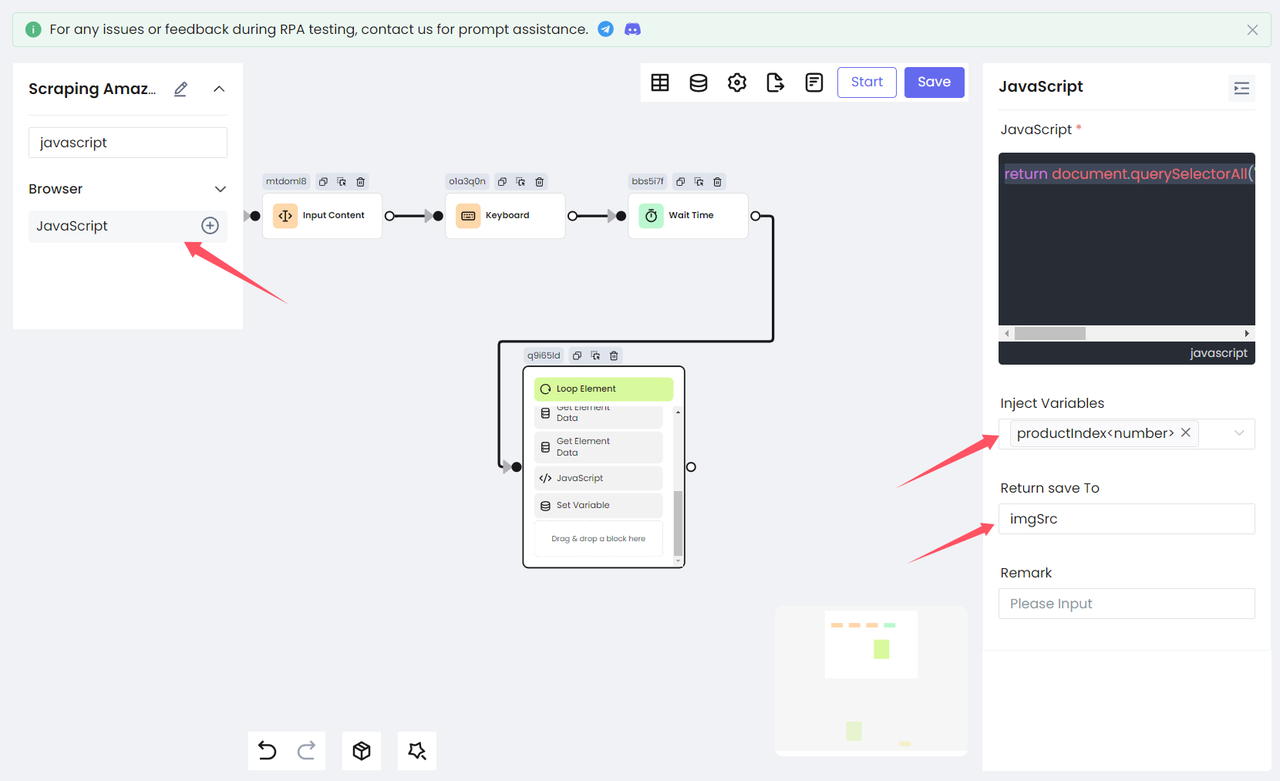
El enlace de imagen necesita procesamiento adicional. Aquí usamos el nodo javascript para obtener el src de la imagen del producto actual recorrido. Ten en cuenta que la variable de índice productIndex guardada por el nodo Loop Element necesita inyectarse en el script y finalmente guardarse como la variable imgSrc.
JavaScript
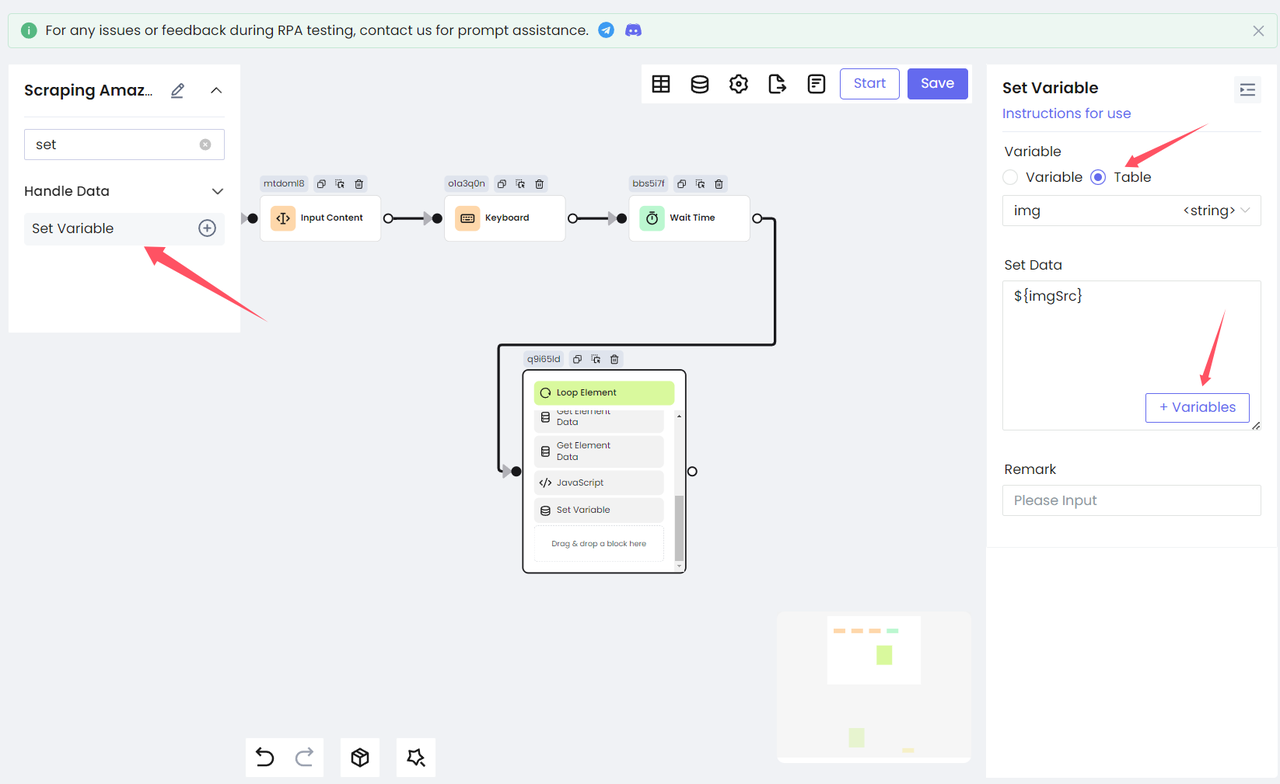
return document.querySelectorAll('[data-image-latency="s-product-image"]')[productIndex].getAttribute('src')Finalmente, usamos el nodo Set Variable para almacenar la variable imgSrc en la table:
Paso 5. Guardar el resultado
En este punto, hemos obtenido todos los datos que queremos recopilar, y es hora de guardar estos datos.
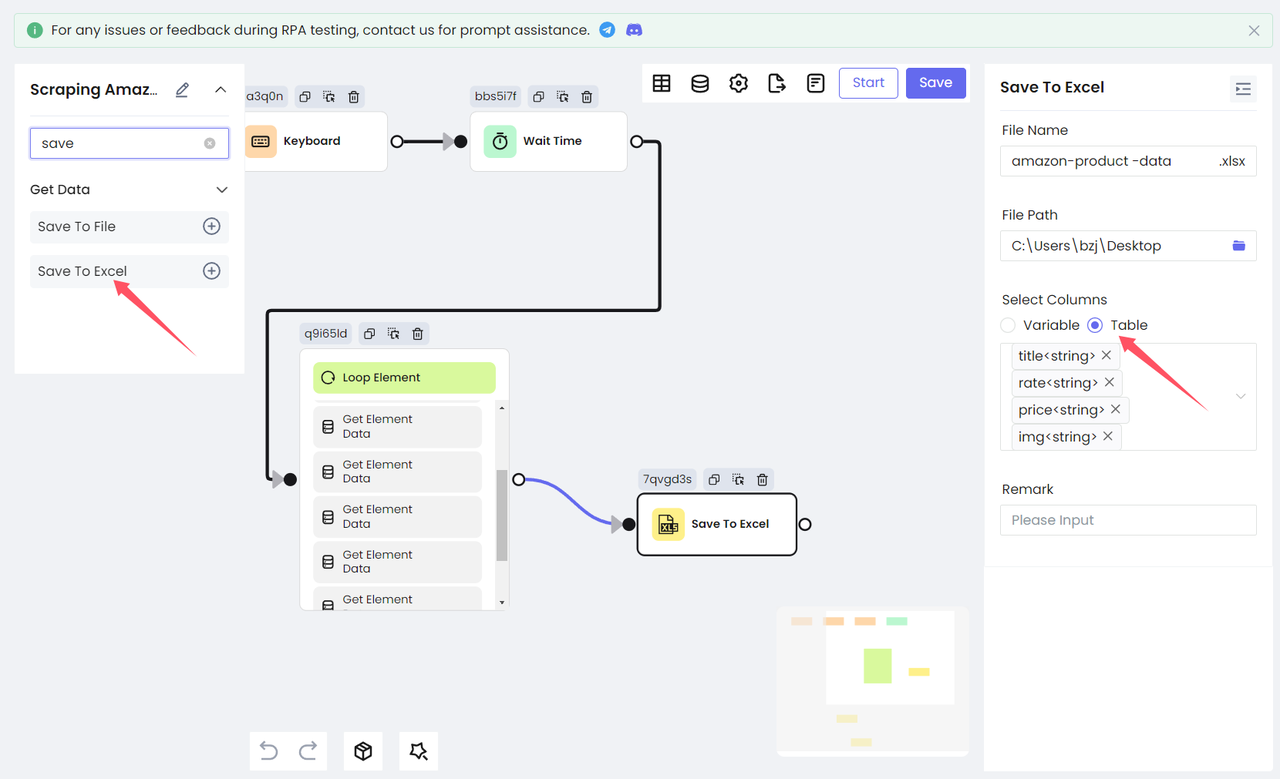
- Nstbrowser RPA proporciona dos formas de guardar datos:
Save To FileySave To Excel.
Save To Fileproporciona tres tipos de archivos para que elijas: .txt, .CSV y .JSON.Save To Excelsolo puede guardar datos en archivos Excel.
Para facilitar la visualización, elegimos guardar los datos recopilados en Excel. Agrega el nodo Save To Excel, configura la ruta del archivo y el nombre del archivo que se guardará, selecciona el contenido de la tabla que se guardará y ¡listo!
Ejecutar RPA
Guarda primero el flujo de trabajo que configuramos, luego puedes ejecutarlo directamente en la página actual, o volver a la página anterior, crear nuevas tareas y hacer clic en el botón Ejecutar para ejecutarlo. ¡En este punto, podemos comenzar a recopilar los datos del producto de Amazon!
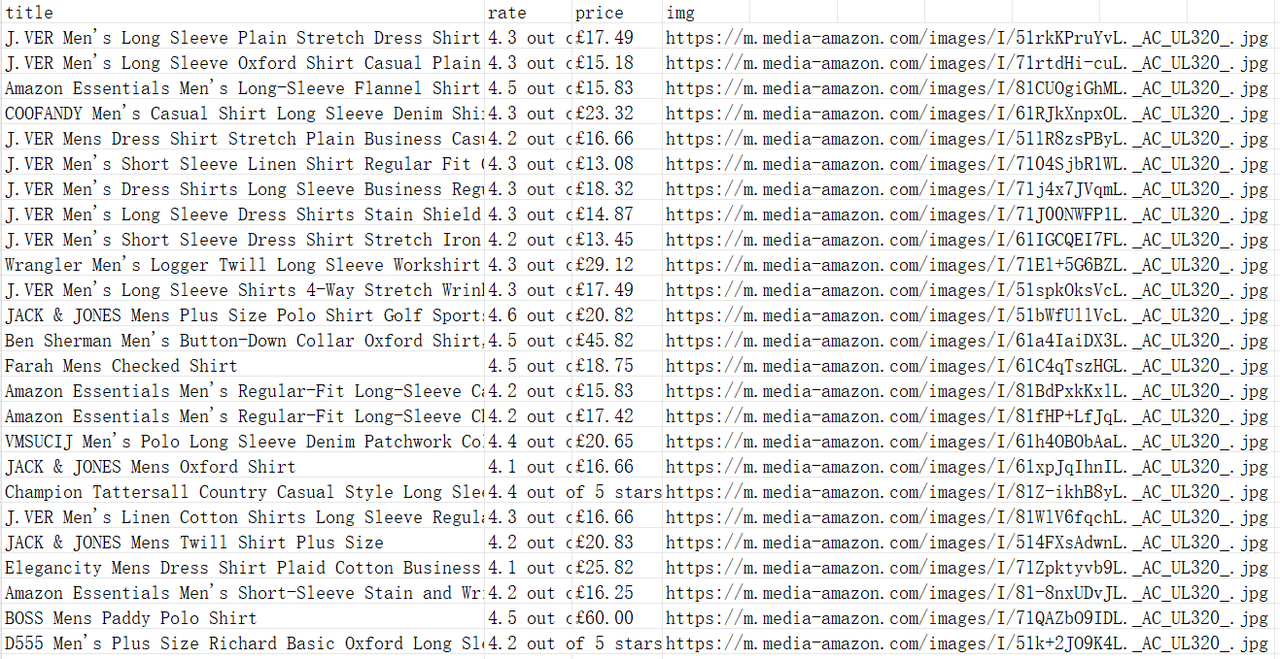
Después de que se complete la ejecución, puedes ver el archivo amazon-product-data.xlsx generado en el escritorio.
En resumen
La forma más fácil de raspar productos de Amazon es construir tu propio raspador de productos de Amazon usando Browserless. Este artículo del tutorial más completo de 2024 te explica claramente:
- Los beneficios de raspar productos de Amazon.
- Las poderosas funciones del raspador de productos de Amazon de Browserless.
- Cómo crear un raspador más fácil usando el RPA de Nstbrower.
¿Estás particularmente interesado en los datos web? Consulta nuestro mercado de RPA. Nstbrowser ha preparado 20 potentes programas RPA que pueden resolver todos tus problemas en todos los aspectos.
Si tienes necesidades especiales para Browserless, raspado de datos o automatización, por favor contacta con nosotros a tiempo. Estamos listos para brindarte servicios personalizados de alta calidad.
Descargo de responsabilidad: Cualquier dato y sitio web mencionados en este artículo son solo para fines de demostración. Nos oponemos firmemente a las actividades ilegales y de infracción. Si tiene alguna pregunta o inquietud, comuníquese con nosotros de inmediato.
Más